在看了众多关于flags与app.flags的文献后,理解程度还是有点迷茫。
1. import tensorflow as tf
2. FLAGS=tf.app.flags.FLAGS
3. tf.app.flags.DEFINE_float(
4. 'flag_float', 0.01, 'input a float')
5. tf.app.flags.DEFINE_integer(
6. 'flag_int', 400, 'input a int')
7. tf.app.flags.DEFINE_boolean(
8. 'flag_bool', True, 'input a bool')
9. tf.app.flags.DEFINE_string(
10. 'flag_string', 'yes', 'input a string')
11.Â
12. print(FLAGS.flag_float)
13. print(FLAGS.flag_int)
14. print(FLAGS.flag_bool)
15. print(FLAGS.flag_string)
1.在命令行中查看帮助信息,在命令行输入 python test.py -h
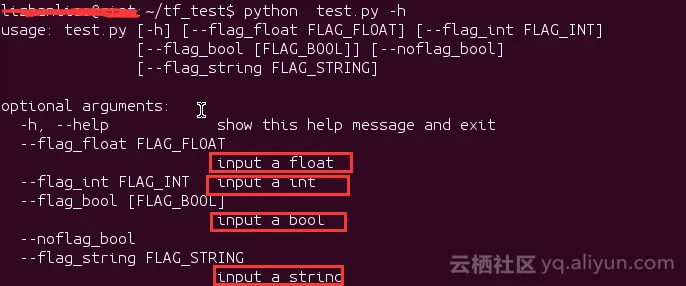
注意红色框中的信息,这个就是我们用DEFINE_XXX添加命令行参数时的第三个参数
2.直接运行test.py
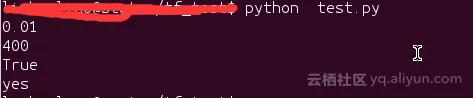
因为没有给对应的命令行参数赋值,所以输出的是命令行参数的默认值。
3.带命令行参数的运行test.py文件
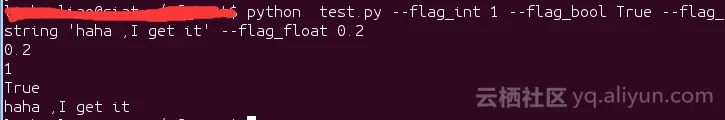
这里输出了我们赋给命令行参数的值
tf.app.flags.DEFINE_xxx()就是添加命令行的optional argument(可选参数),
而tf.app.flags.FLAGS可以从对应的命令行参数取出参数。
DEFINE_string()限定了可选参数输入必须是string,这也就是为什么这个函数定义为DEFINE_string(),同理,DEFINE_int()限定可选参数必须是int,DEFINE_float()限定可选参数必须是float,DEFINE_boolean()限定可选参数必须是bool。
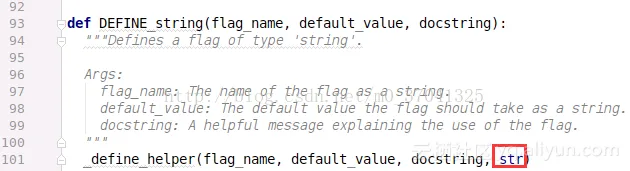
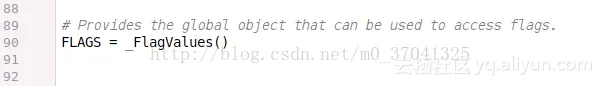
最关键的一步,这里定义了_FlagValues这个类的一个实例,这样的这样当要访问命令行输入的命令时,就能使用像tf.app.flag.Flags这样的操作。
从:使用CNN做英文文本任务实例来看flags用法
import tensorflow as tfimport numpy as npimport osimport timeimport datetimeimport data_helpersfrom text_cnn import TextCNNfrom tensorflow.contrib import learn
# Parameters# ==================================================
# Data loading params# 语料文件路径定义
tf.flags.DEFINE_float("dev_sample_percentage", .1, "Percentage of the training data to use for validation")
tf.flags.DEFINE_string("positive_data_file", "./data/rt-polaritydata/rt-polarity.pos", "Data source for the positive data.")
tf.flags.DEFINE_string("negative_data_file", "./data/rt-polaritydata/rt-polarity.neg", "Data source for the negative data.")
# Model Hyperparameters# 定义网络超参数
tf.flags.DEFINE_integer("embedding_dim", 128, "Dimensionality of character embedding (default: 128)")
tf.flags.DEFINE_string("filter_sizes", "3,4,5", "Comma-separated filter sizes (default: '3,4,5')")
tf.flags.DEFINE_integer("num_filters", 128, "Number of filters per filter size (default: 128)")
tf.flags.DEFINE_float("dropout_keep_prob", 0.5, "Dropout keep probability (default: 0.5)")
tf.flags.DEFINE_float("l2_reg_lambda", 0.0, "L2 regularization lambda (default: 0.0)")
# Training parameters# 训练参数
tf.flags.DEFINE_integer("batch_size", 32, "Batch Size (default: 32)")
tf.flags.DEFINE_integer("num_epochs", 200, "Number of training epochs (default: 200)") # 总训练次数
tf.flags.DEFINE_integer("evaluate_every", 100, "Evaluate model on dev set after this many steps (default: 100)") # 每训练100次测试一下
tf.flags.DEFINE_integer("checkpoint_every", 100, "Save model after this many steps (default: 100)") # 保存一次模型
tf.flags.DEFINE_integer("num_checkpoints", 5, "Number of checkpoints to store (default: 5)")# Misc Parameters
tf.flags.DEFINE_boolean("allow_soft_placement", True, "Allow device soft device placement") # 加上一个布尔类型的参数,要不要自动分配
tf.flags.DEFINE_boolean("log_device_placement", False, "Log placement of ops on devices") # 加上一个布尔类型的参数,要不要打印日志
# 打印一下相关初始参数
FLAGS = tf.flags.FLAGS
FLAGS._parse_flags()
print("\nParameters:")for attr, value in sorted(FLAGS.__flags.items()):
print("{}={}".format(attr.upper(), value))
print("")
# Data Preparation# ==================================================
# Load data
print("Loading data...")
x_text, y = data_helpers.load_data_and_labels(FLAGS.positive_data_file, FLAGS.negative_data_file)
# Build vocabulary
max_document_length = max([len(x.split(" ")) for x in x_text]) # 计算最长邮件
vocab_processor = learn.preprocessing.VocabularyProcessor(max_document_length) # tensorflow提供的工具,将数据填充为最大长度,默认0填充
x = np.array(list(vocab_processor.fit_transform(x_text)))
# Randomly shuffle data# 数据洗牌
np.random.seed(10)# np.arange生成随机序列
shuffle_indices = np.random.permutation(np.arange(len(y)))
x_shuffled = x[shuffle_indices]
y_shuffled = y[shuffle_indices]
# 将数据按训练train和测试dev分块# Split train/test set# TODO: This is very crude, should use cross-validation
dev_sample_index = -1 * int(FLAGS.dev_sample_percentage * float(len(y)))
x_train, x_dev = x_shuffled[:dev_sample_index], x_shuffled[dev_sample_index:]
y_train, y_dev = y_shuffled[:dev_sample_index], y_shuffled[dev_sample_index:]
print("Vocabulary Size: {:d}".format(len(vocab_processor.vocabulary_)))
print("Train/Dev split: {:d}/{:d}".format(len(y_train), len(y_dev))) # 打印切分的比例
# Training# ==================================================
with tf.Graph().as_default():
session_conf = tf.ConfigProto(
allow_soft_placement=FLAGS.allow_soft_placement,
log_device_placement=FLAGS.log_device_placement)
sess = tf.Session(config=session_conf)
with sess.as_default():
# 卷积池化网络导入
cnn = TextCNN(
sequence_length=x_train.shape[1],
num_classes=y_train.shape[1], # 分几类
vocab_size=len(vocab_processor.vocabulary_),
embedding_size=FLAGS.embedding_dim,
filter_sizes=list(map(int, FLAGS.filter_sizes.split(","))), # 上面定义的filter_sizes拿过来,"3,4,5"按","分割
num_filters=FLAGS.num_filters, # 一共有几个filter
l2_reg_lambda=FLAGS.l2_reg_lambda) # l2正则化项
# Define Training procedure
global_step = tf.Variable(0, name="global_step", trainable=False)
optimizer = tf.train.AdamOptimizer(1e-3) # 定义优化器
grads_and_vars = optimizer.compute_gradients(cnn.loss)
train_op = optimizer.apply_gradients(grads_and_vars, global_step=global_step)
# Keep track of gradient values and sparsity (optional)
grad_summaries = []
for g, v in grads_and_vars:
if g is not None:
grad_hist_summary = tf.summary.histogram("{}/grad/hist".format(v.name), g)
sparsity_summary = tf.summary.scalar("{}/grad/sparsity".format(v.name), tf.nn.zero_fraction(g))
grad_summaries.append(grad_hist_summary)
grad_summaries.append(sparsity_summary)
grad_summaries_merged = tf.summary.merge(grad_summaries)
# Output directory for models and summaries
timestamp = str(int(time.time()))
out_dir = os.path.abspath(os.path.join(os.path.curdir, "runs", timestamp))
print("Writing to {}\n".format(out_dir))
# Summaries for loss and accuracy
# 损失函数和准确率的参数保存
loss_summary = tf.summary.scalar("loss", cnn.loss)
acc_summary = tf.summary.scalar("accuracy", cnn.accuracy)
# Train Summaries
# 训练数据保存
train_summary_op = tf.summary.merge([loss_summary, acc_summary, grad_summaries_merged])
train_summary_dir = os.path.join(out_dir, "summaries", "train")
train_summary_writer = tf.summary.FileWriter(train_summary_dir, sess.graph)
# Dev summaries
# 测试数据保存
dev_summary_op = tf.summary.merge([loss_summary, acc_summary])
dev_summary_dir = os.path.join(out_dir, "summaries", "dev")
dev_summary_writer = tf.summary.FileWriter(dev_summary_dir, sess.graph)
# Checkpoint directory. Tensorflow assumes this directory already exists so we need to create it
checkpoint_dir = os.path.abspath(os.path.join(out_dir, "checkpoints"))
checkpoint_prefix = os.path.join(checkpoint_dir, "model")
if not os.path.exists(checkpoint_dir):
os.makedirs(checkpoint_dir)
saver = tf.train.Saver(tf.global_variables(), max_to_keep=FLAGS.num_checkpoints) # 前面定义好参数num_checkpoints
# Write vocabulary
vocab_processor.save(os.path.join(out_dir, "vocab"))
# Initialize all variables
sess.run(tf.global_variables_initializer()) # 初始化所有变量
# 定义训练函数
def train_step(x_batch, y_batch):
"""
A single training step
"""
feed_dict = {
cnn.input_x: x_batch,
cnn.input_y: y_batch,
cnn.dropout_keep_prob: FLAGS.dropout_keep_prob # 参数在前面有定义
}
_, step, summaries, loss, accuracy = sess.run(
[train_op, global_step, train_summary_op, cnn.loss, cnn.accuracy], feed_dict)
time_str = datetime.datetime.now().isoformat() # 取当前时间,python的函数
print("{}: step {}, loss {:g}, acc {:g}".format(time_str, step, loss, accuracy))
train_summary_writer.add_summary(summaries, step)
# 定义测试函数
def dev_step(x_batch, y_batch, writer=None):
"""
Evaluates model on a dev set
"""
feed_dict = {
cnn.input_x: x_batch,
cnn.input_y: y_batch,
cnn.dropout_keep_prob: 1.0 # 神经元全部保留
}
step, summaries, loss, accuracy = sess.run(
[global_step, dev_summary_op, cnn.loss, cnn.accuracy], feed_dict)
time_str = datetime.datetime.now().isoformat()
print("{}: step {}, loss {:g}, acc {:g}".format(time_str, step, loss, accuracy))
if writer:
writer.add_summary(summaries, step)
# Generate batches
batches = data_helpers.batch_iter(list(zip(x_train, y_train)), FLAGS.batch_size, FLAGS.num_epochs)
# Training loop. For each batch...
# 训练部分
for batch in batches:
x_batch, y_batch = zip(*batch) # 按batch把数据拿进来
train_step(x_batch, y_batch)
current_step = tf.train.global_step(sess, global_step) # 将Session和global_step值传进来
if current_step % FLAGS.evaluate_every == 0: # 每FLAGS.evaluate_every次每100执行一次测试
print("\nEvaluation:")
dev_step(x_dev, y_dev, writer=dev_summary_writer)
print("")
if current_step % FLAGS.checkpoint_every == 0: # 每checkpoint_every次执行一次保存模型
path = saver.save(sess, './', global_step=current_step) # 定义模型保存路径
print("Saved model checkpoint to {}\n".format(path))
tf定义了tf.app.flags,用于支持接受命令行传递参数,相当于接受argv。
import tensorflow as tf
#第一个是参数名称,第二个参数是默认值,第三个是参数描述
tf.app.flags.DEFINE_string('str_name', 'def_v_1',"descrip1")
tf.app.flags.DEFINE_integer('int_name', 10,"descript2")
tf.app.flags.DEFINE_boolean('bool_name', False, "descript3")
FLAGS = tf.app.flags.FLAGS
#必须带参数,否则:'TypeError: main() takes no arguments (1 given)'; main的参数名随意定义,无要求def main(_):
print(FLAGS.str_name)
print(FLAGS.int_name)
print(FLAGS.bool_name)
if __name__ == '__main__':
tf.app.run() #执行main函数
执行:
def_v_1
10
False
# python tt.py --str_name test_str --int_name 99 --bool_name True
test_str
99
True