GPT-6.2 Astra 和 Sol 今儿凌晨终于偷偷摸摸上线了(散播消息到现在得有2个月了)。
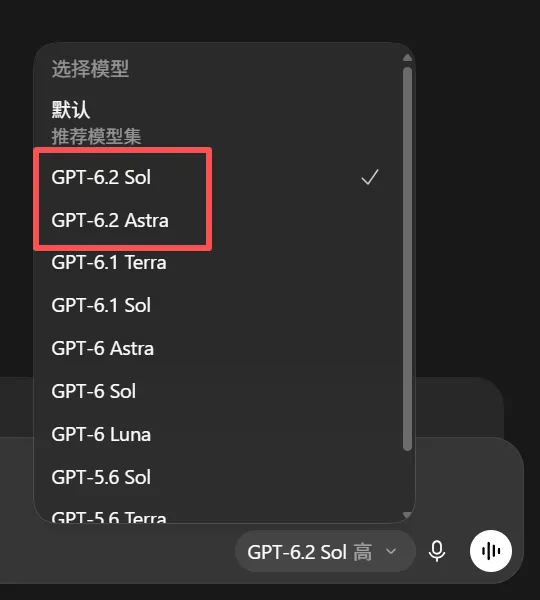
其中 Astra 是旗舰,Sol 是编程日常主力。
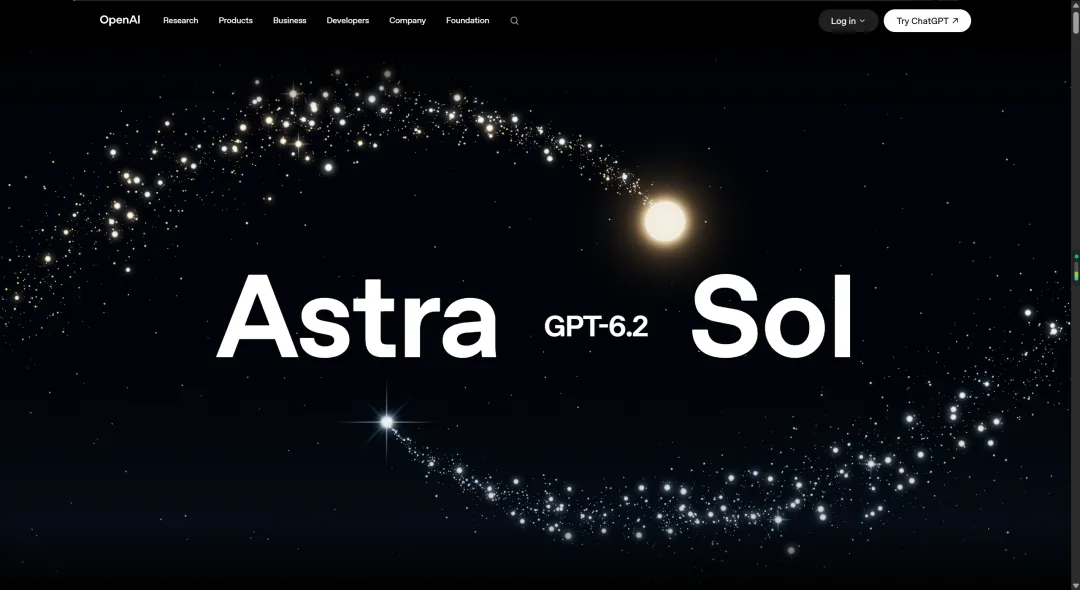
已经在网页的Work和Codex客户端里可见。
不过这次的首批反馈,还挺两极分化的。
一边是漂亮的汽车网页、3D 模型,还有一张很难不让人多看两眼的账单:OpenAI 公布的专业任务评测结果里,Astra 每题花 2.89 美元,Claude Fable 5.2 要 60.05 美元。
然而另一边,几位提前用过的开发者却在吐槽:话说不明白,活干到一半就停,最后还得人回来收拾。
就像这老哥,已经快把百万阅读量的吐槽了。
模型更强了,为什么用起来还让人生气?
老金把官方资料、独立评测和社区上的首批反馈放到一起看了一遍。
这里面,有真进步,也有真问题。
我们一步步看一下。
01|先看看这次能做什么
先看案例。
@Layton 展示了一款汽车:深色背景下,车身、玻璃车顶和灯光一起把质感撑起来。
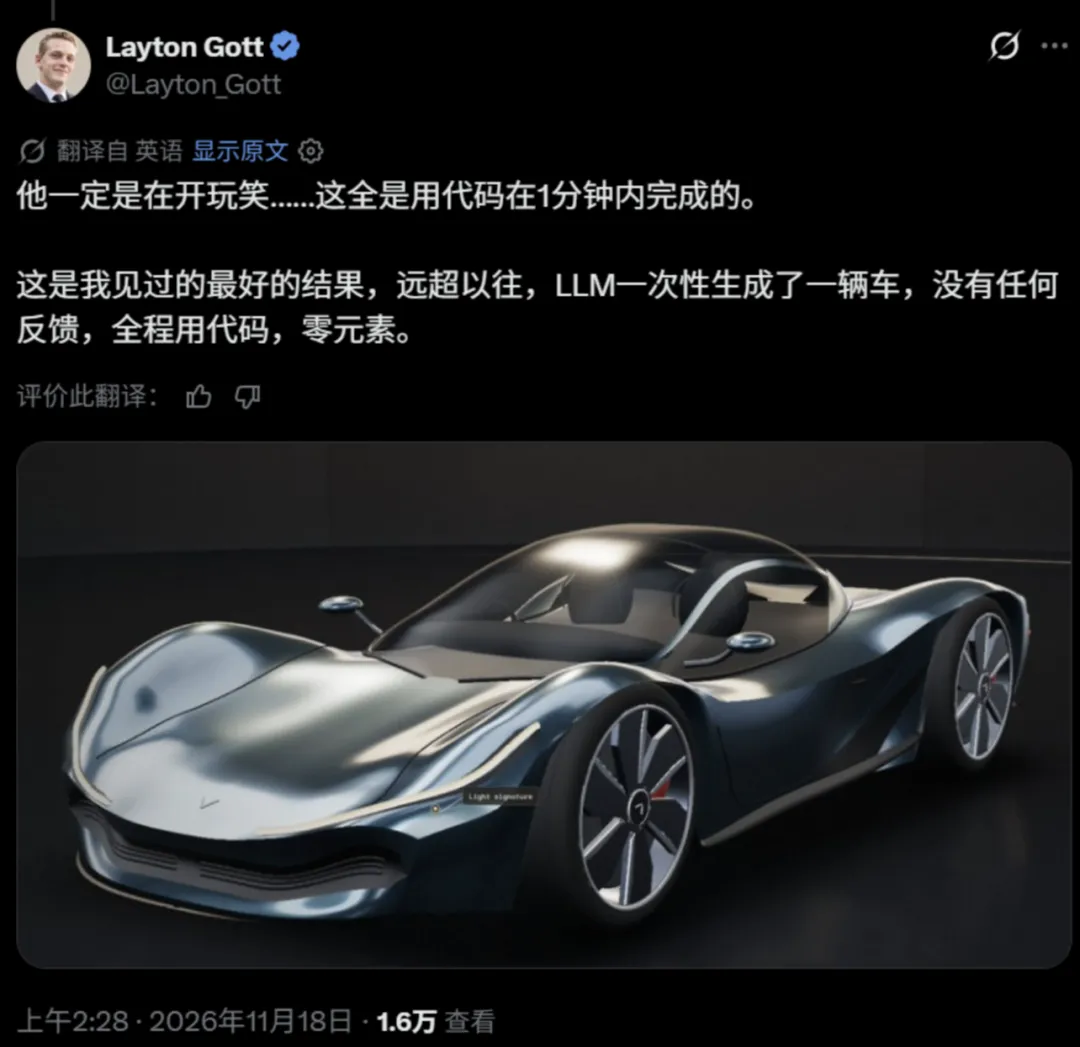
他说,这个结果只花了1分钟,也公开了自己使用的详细提示词,他给模型的要求很具体,并非随手扔一句“做个好看的网站”,这个大家得学,我已经苦口婆心说了N百次,别许愿。。
为虚构的未来电动超跑“VeyraX”构建其发布网站。该网站应感觉像一个真实的高端汽车发布会网站,并看起来像一个获奖网站。

要求:
- 一个独立的HTML文件。使用CDN上的Three.js和GSAP。除了GoogleFonts外,不使用任何外部图片、模型或字体。汽车及其他内容均需通过代码构建。
- 主角:汽车停在一个昏暗的工作室里,一道扫过车身的灯光将其照亮。流线型、低矮的未来主义设计,配有发光灯带、具有真实反射效果的亮面漆和玻璃顶盖。它缓慢旋转,并对鼠标做出反应。
- 当用户滚动时,摄像机围绕汽车旋转以展示不同角度,并且汽车向前驶入一个霓虹灯隧道,光线条纹和运动模糊显示其速度。
- 部分:英雄展示、性能数据(0-60、最高速度、续航里程),这些数据会配合动画进行计数,一个设计部分,其中汽车的各个部件会高亮显示并带有标签,一个可实时更改漆面和轮毂风格的配置器,以及一个保留部分。
- 所有用户界面(导航、按钮、状态卡片、配置器、预留表单)均采用苹果风格的液态玻璃效果。它必须在边缘折射和扭曲背景,并带有高光反射,而不仅仅是背景模糊。玻璃应像液体一样对悬停做出反应。
- 让其感觉高端:流畅60帧,电影级灯光,简洁现代字体,间
距充足,无廉价感。
- 必须能在桌面端和移动端运行。不得使用任何现有元素,尽可能地完善动画效果和细节处理。
接下来的案例,来自 OpenAI 的官方展示。
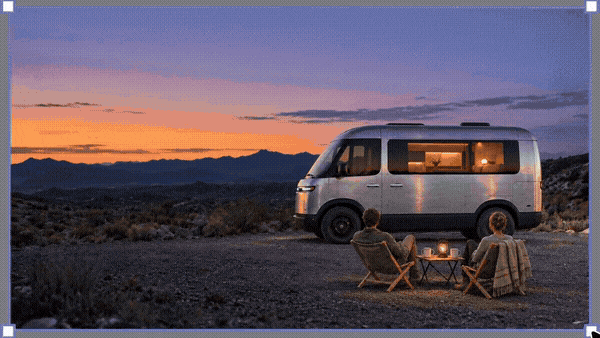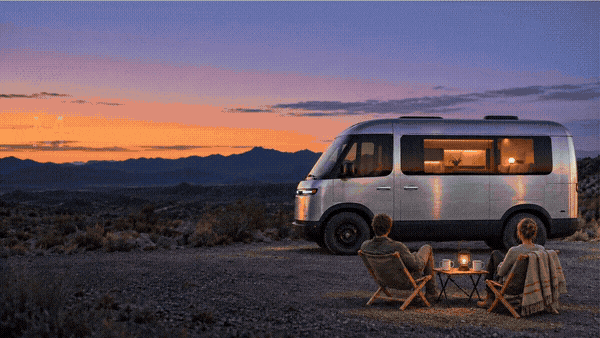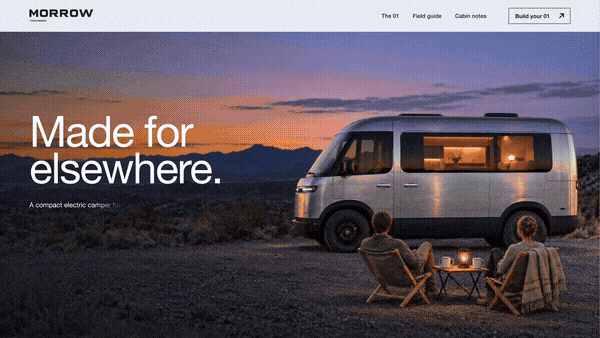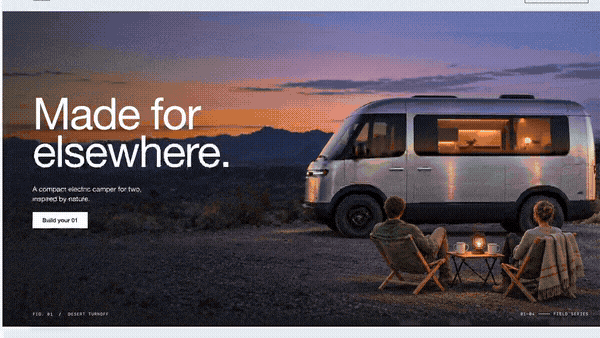
先看这个房车网站。
傍晚的山景、亮着灯的车厢,再加上大面积留白,第一屏已经能把旅行氛围带出来。
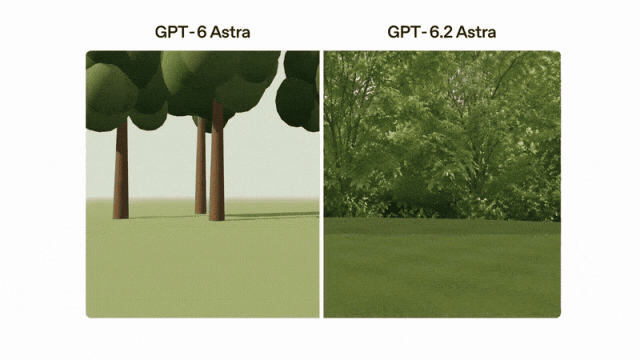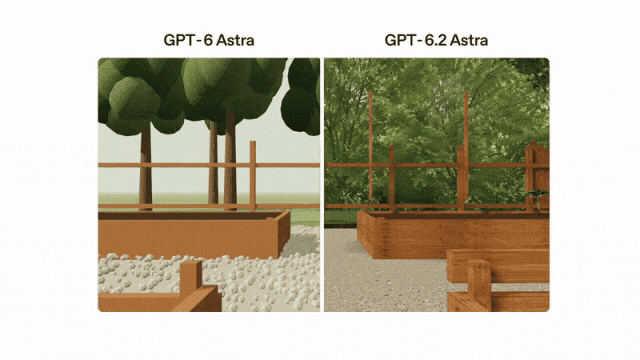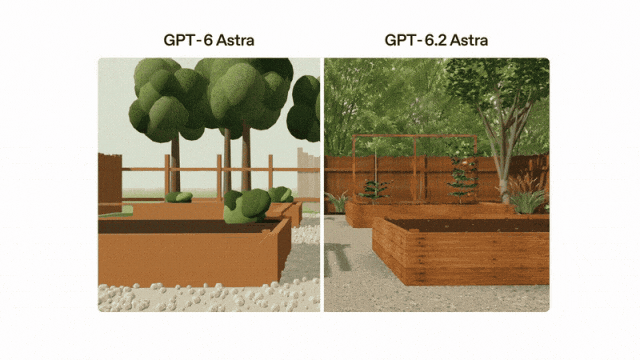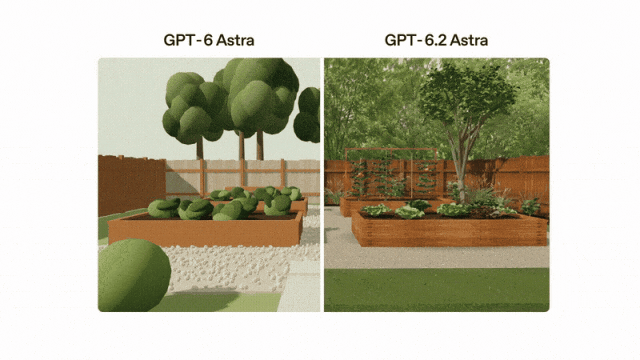
如果说网站还需要自己想主题,花园案例的输入就更直观:一段后院画面。模型据此规划菜园,官方还放了两代模型的结果对照。
左边的植物和围栏更像简单模型;右边能看到更丰富的枝叶、木材纹理和场景细节。
看这组展示,新老版本确实差了一大截,新版效果显著。
再看一个离日常工作近点的。
比如你拿着上一季度的 PPT,要把它改成这一季度的。
难点往往不在多做几页,而是旧模板得接着用,新数据还得讲明白,最后还得让领导看懂接下来怎么办。
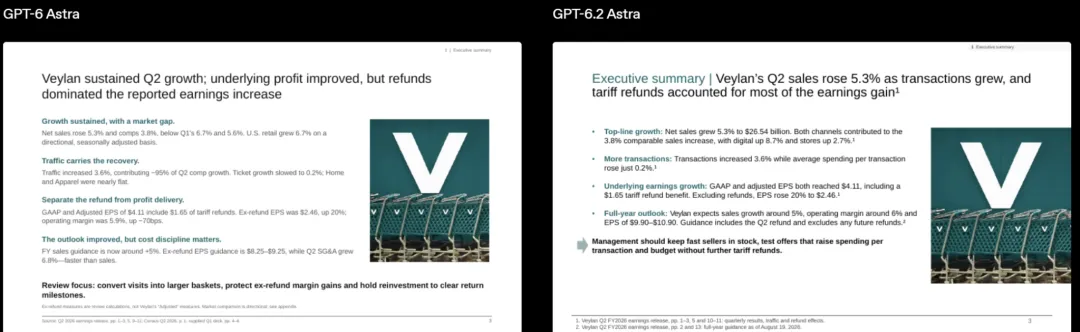
OpenAI 这次拿一家零售商的公开财报做了演示:给两代模型旧 PPT、新季度财报和申报文件,让它们更新内容。
两代都发现了关税退款对利润的影响,这是个重点,都没问题。
然后从画面上来看,新版则进一步把销售增长放进标题,拆开线上和门店表现,再给出备货、预算方面的下一步建议。
这里的进步就比较好理解了:除了把数字填进去,它还要判断哪些数字值得讲、怎么讲、讲完要做什么。
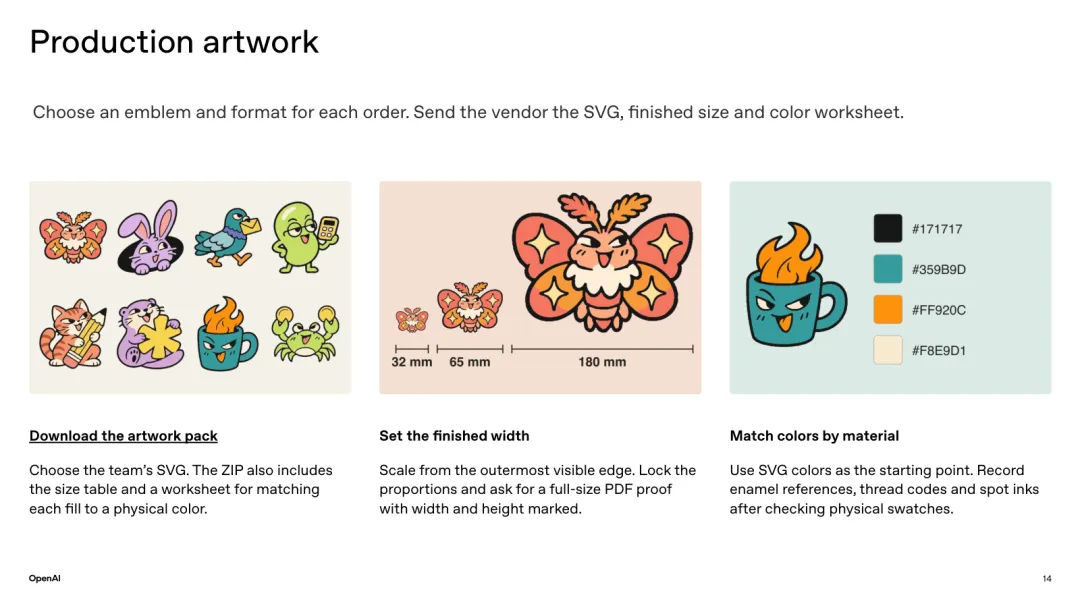
官方还展示了另一组 PPT,用同样的团队周边主题,分别生成提案。
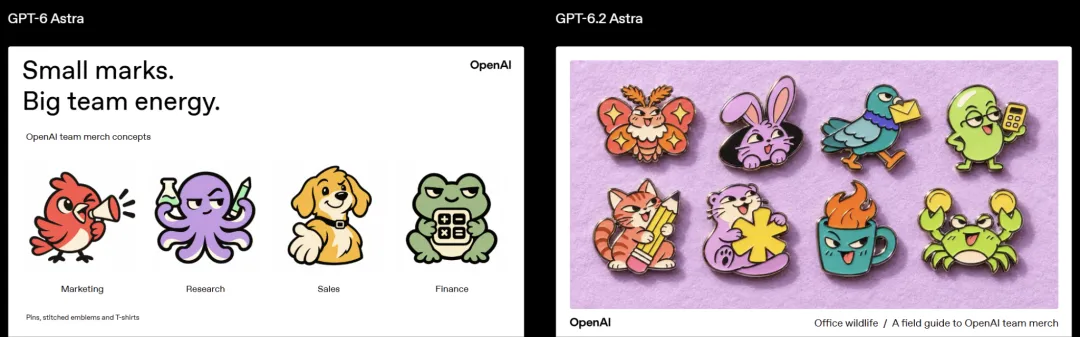
一个偏平面角色展示,一个把徽章的材质和实物感放进了画面,不过这个老金觉得主观性比较强,仁者见仁吧。
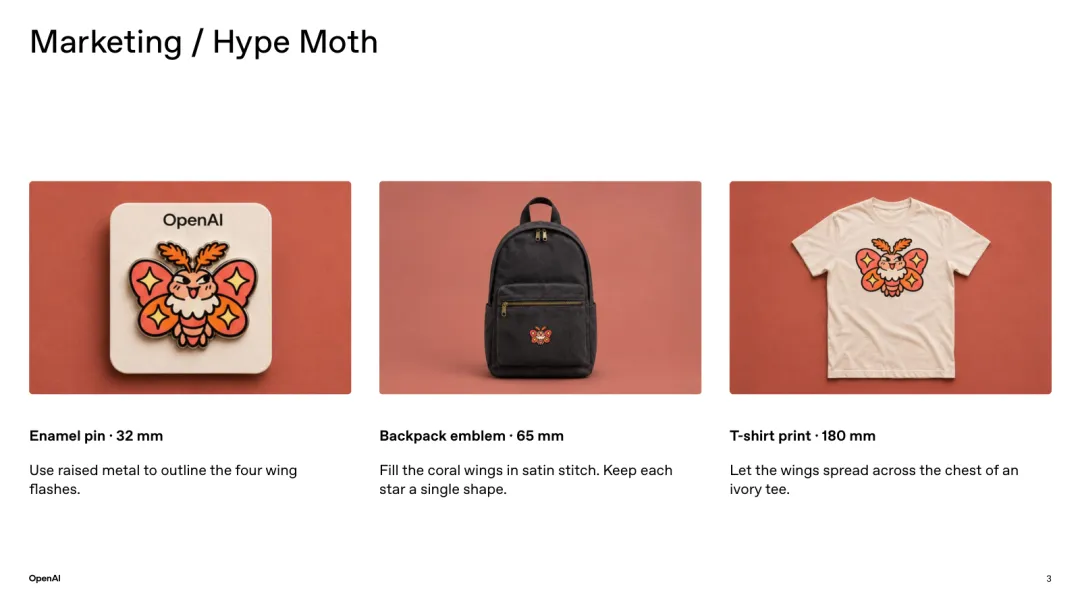
不过它还交付了可下载的矢量图、尺寸、配色匹配和打样确认事项。
对要把方案交给供应商的人来说,这个就实用了。
当然,这是官方选出的案例,日常任务能不能稳定做成,还要继续看。
但这至少说明,这次更新想解决的事情,比“再画一个漂亮网页”多得多。
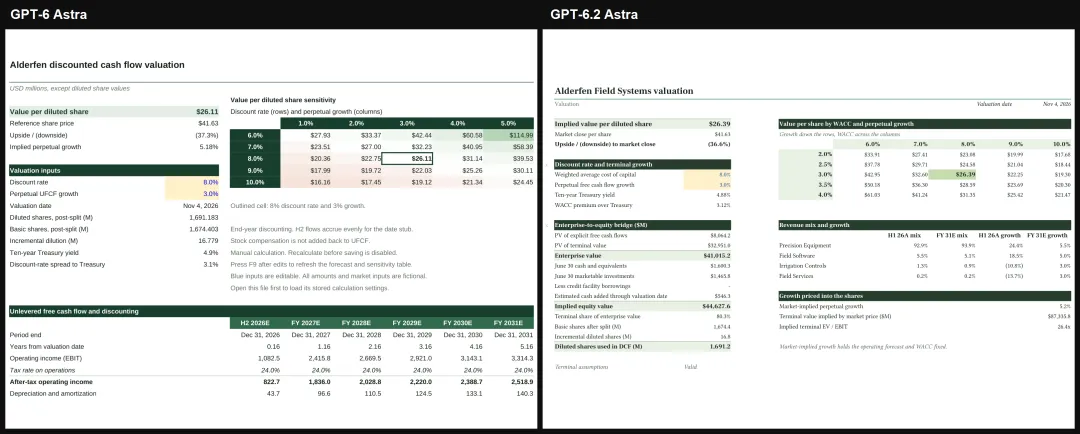
再看一个更接近办公室日常的例子:给模型一家虚构农业科技公司的财务报表、经营假设和市场数据,让它做一份可编辑的 Excel。
任务要求按业务预测到 2031 年,把利润表、资产负债表和现金流量表勾稽起来,用 8% 的折现率、3% 的永续增长率计算每股价值,还要反推当前股价隐含的增长预期,最后做敏感性分析。
新版把收入构成、企业价值到每股价值的推导,放到了敏感性表附近。
你看到估值变化时,更容易顺着找到它依赖的假设,而不是在几个工作表之间来回翻。
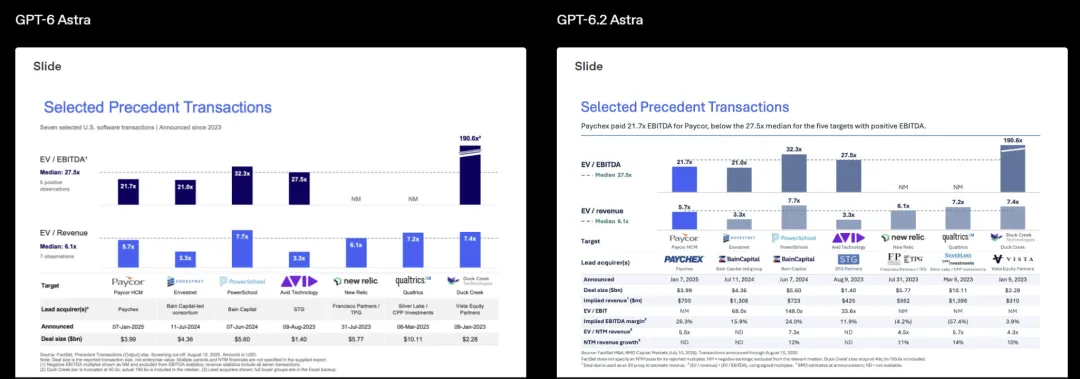
再看七宗美国软件收购的估值对比。
新版把 Paycor 的 21.7 倍 EBITDA 与 27.5 倍中位数写进标题,读者先看到判断,再往下核对数据。
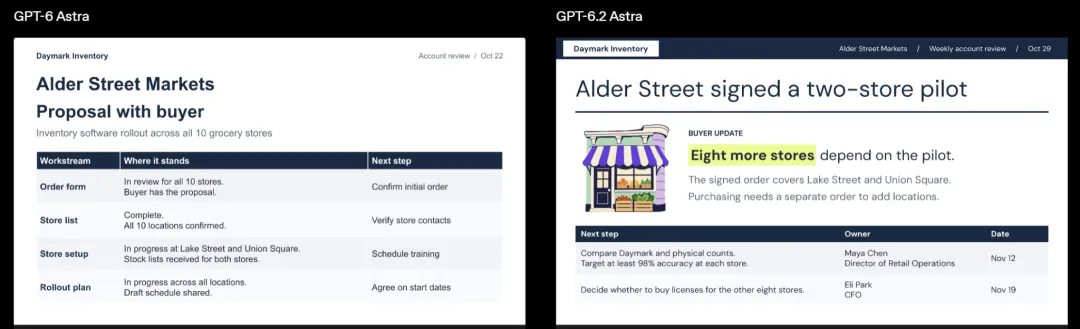
然后这个原始参考,把他重构一下。
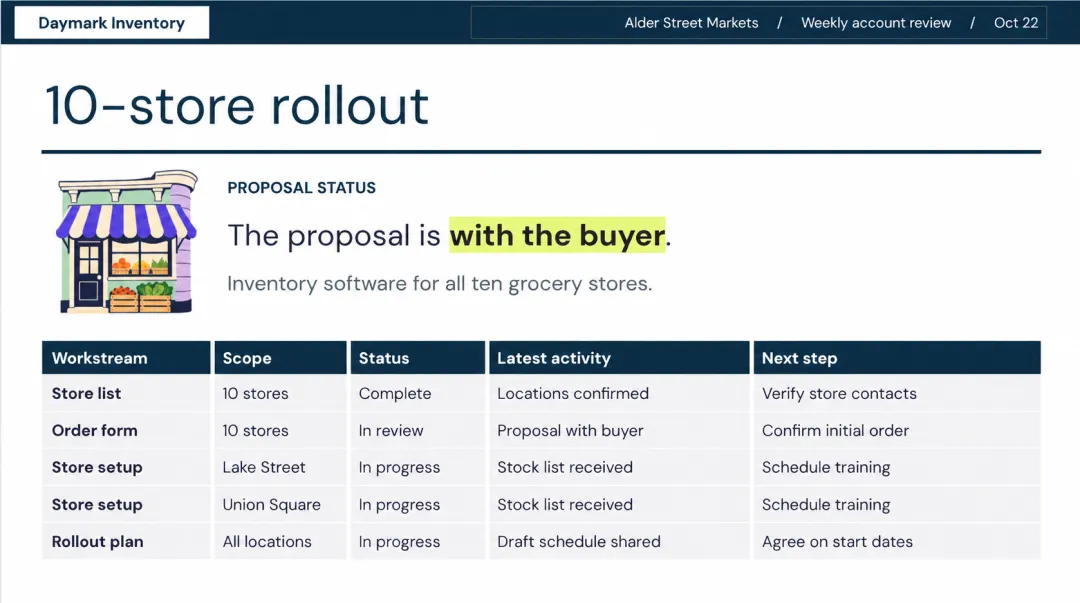
左侧把更新做成了工作流表格,右侧则延续参考模板的深蓝页眉、店面插画和重点标记,把两店试点、另八店待定的信息放进原有版式。
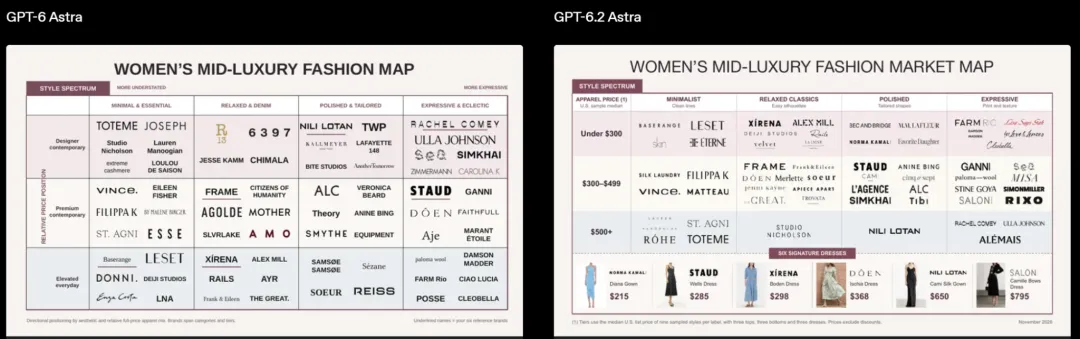
换成女装市场定位,新版把品牌按价格和风格分区,再放入六条代表连衣裙的图片和价格。
这样能让读者能顺着实物,理解每个品牌的位置。
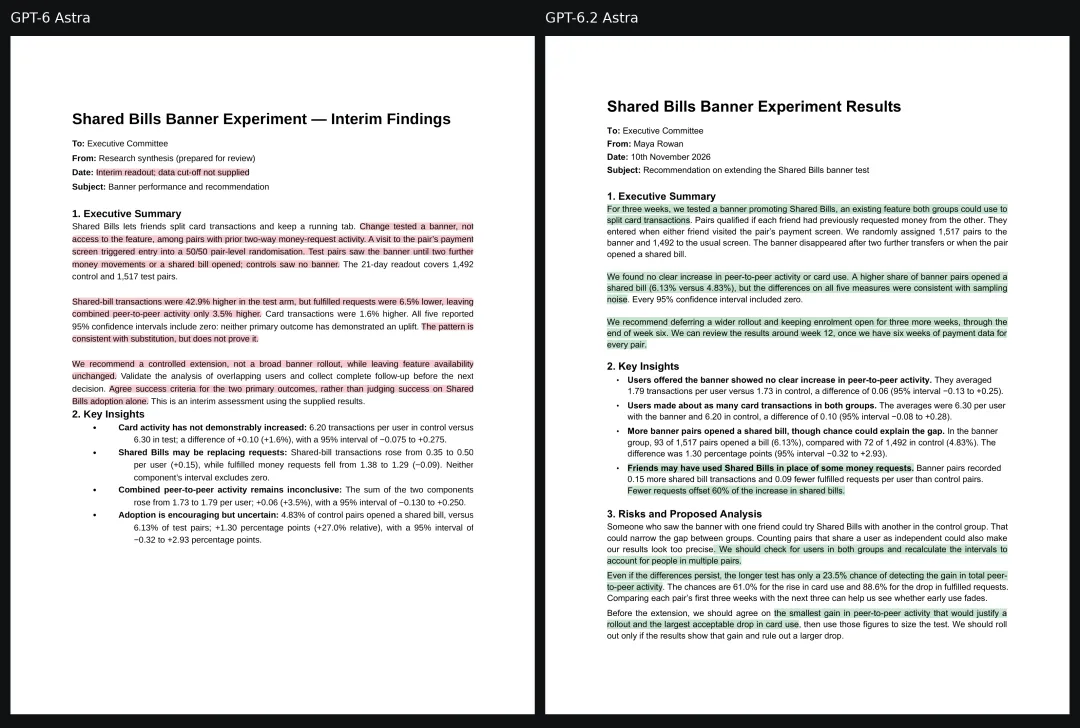
实验解读也能直接对照:新版先说明差异不足以排除抽样噪声,再给出延长测试、补齐观察窗口的建议。
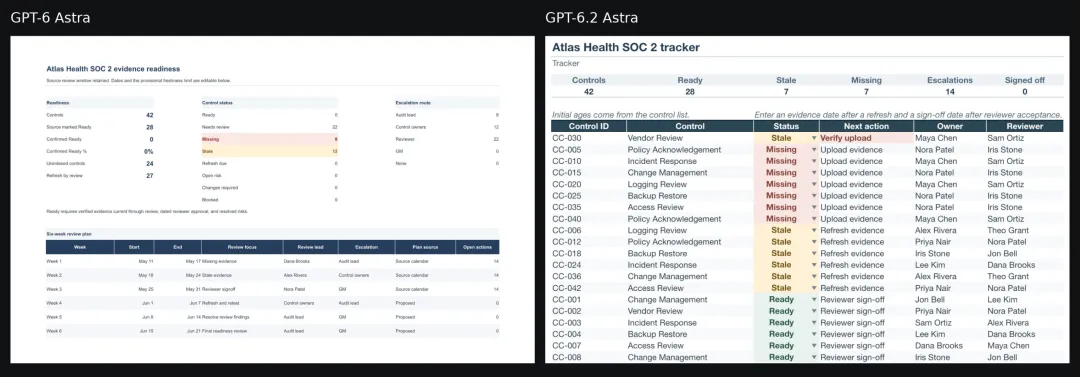
SOC 2 合规追踪则把状态、下一步、负责人和审核人放到同一行,便于逐项推进。两组对比均为左侧旧版、右侧新版。
这类工作的评分也更有针对性。
AA-AnalystAgent 要模型在真实报表和表格里找数、计算,Astra 有 62.5% 的题目,在五次独立作答中全部答对。
这个条件比“随机做一次,答对率 62.5%”严格,考的是重复执行是否稳定。
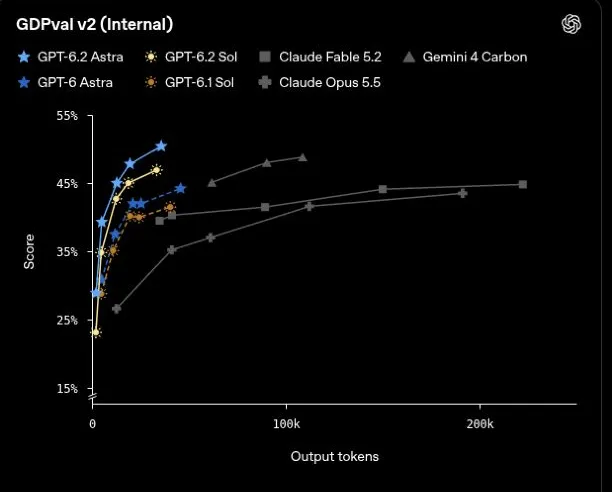
再往长流程看,OpenAI 内部的 GDPval v2 会把咨询、金融、设计项目当年的文件和消息交给模型。
Max 档下,Astra 从上一代的 44.2% 提升到 50.4%,平均输出 token 从 45,732 降到 35,812,减少约 22%。Sol 则从 41.5% 提升到 46.9%。
也有企业把它放进自己的流程里测。
会计 AI 公司 Basis 报告,长程会计任务平均用时减少一半,最复杂的任务最多减少 73%;ClickUp 在工作区应用、仪表盘和幻灯片的内部盲测中,相比自己的生产模型,观察到约 40% 的 token 减少和约 30% 的审阅轮次减少。
工程类的展示更夸张。
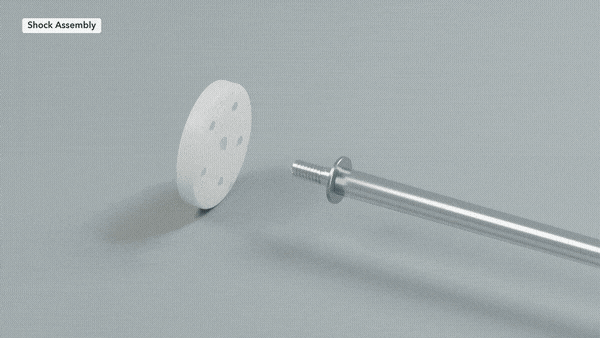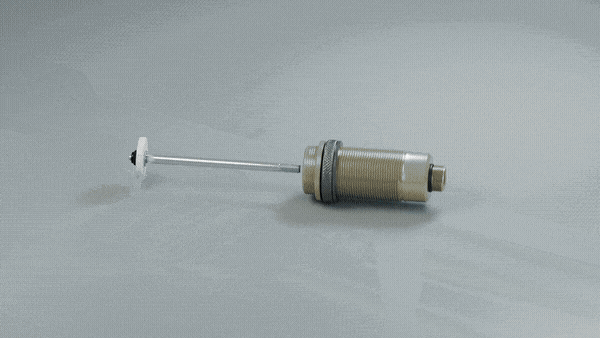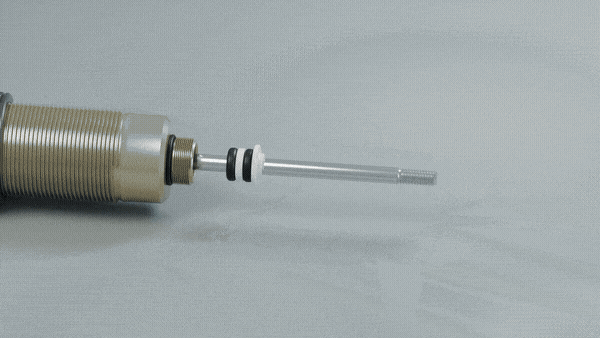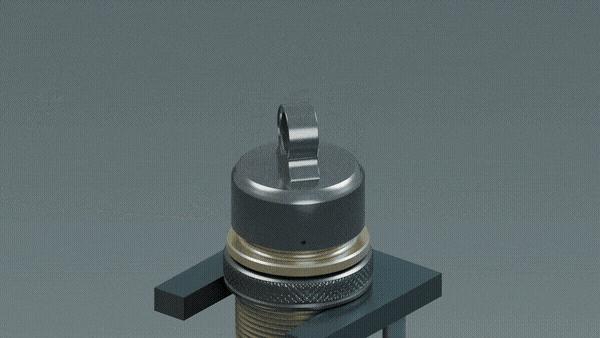
Astra 根据照片和组装手册,把遥控越野车套件逐个零件建出来,还生成了装配动画和零件目录。
看下面这段,减震器的零件怎样组合、差速器里的结构是什么样,已经能逐步展示出来。
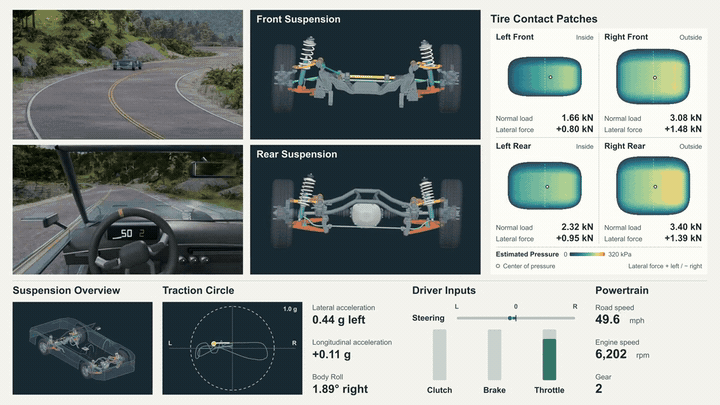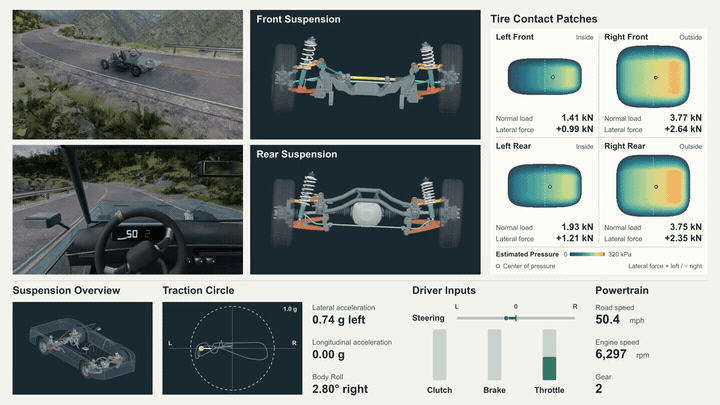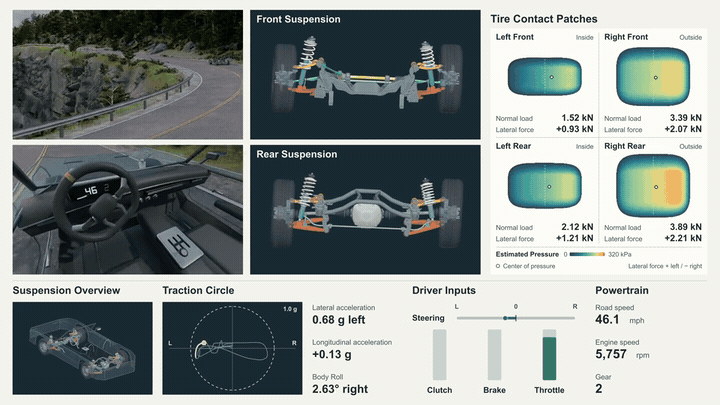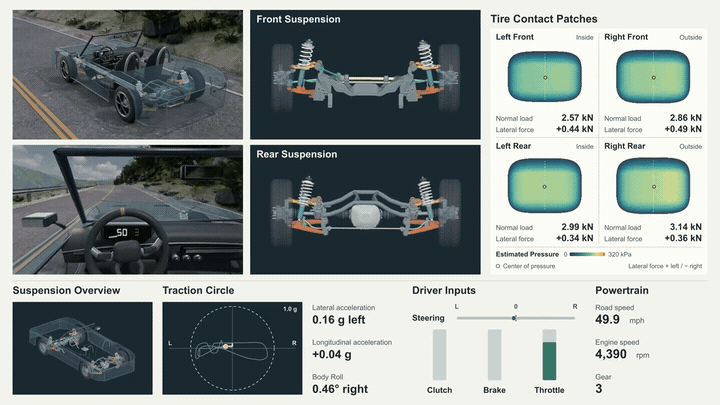
另一个跑车案例里,它搭 3D 模型,用 Python 写轮胎、悬架的求解器,再用 Blender 做动画。
画面不只显示车在山路上跑,还把前后悬架、轮胎接触区域和驾驶输入放到一起。
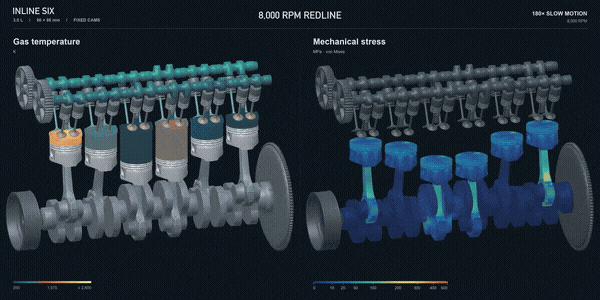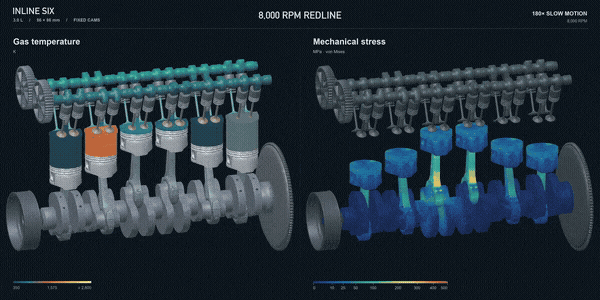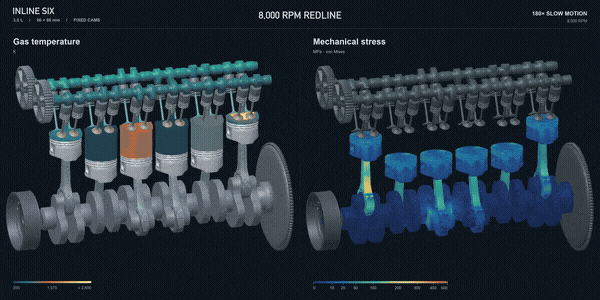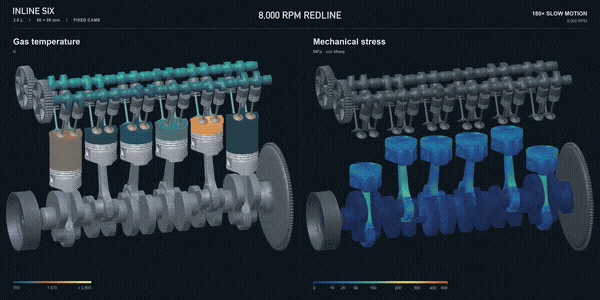
直列六缸发动机的演示,又把机械运动、气体温度和应力变化放在了同一画面里。
下面这个片段展示的是运行过程,可视化做得细,不等于真实工程验证已经完成。
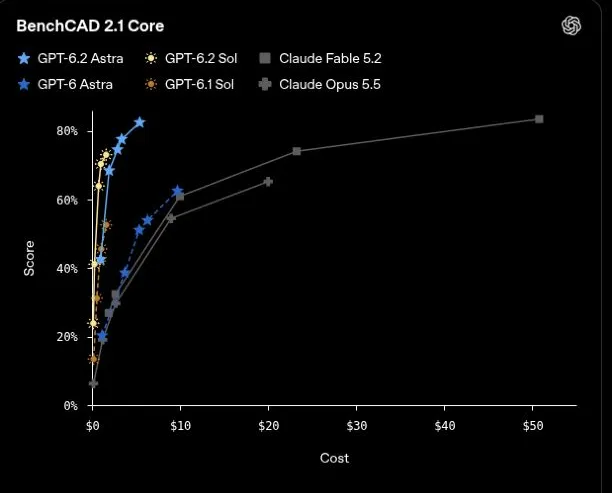
这里也保留一个参照:Fable 5.2 的 Max 档是 83.5%,仍略高于 Astra,但单任务成本是 50.77 美元。
做 AI 视频的 Higgsfield 也提供了测试反馈:新版 Astra 有 73% 的案例一次达到目标,旧版往往需要三轮及以上修改。
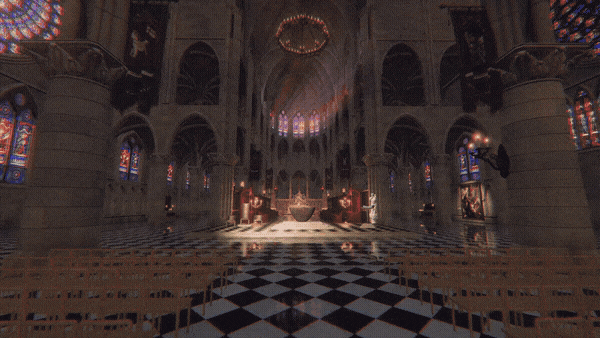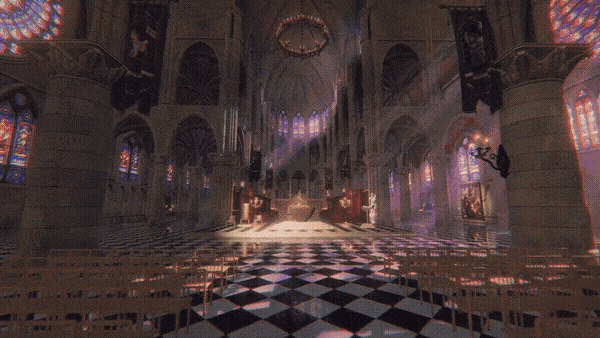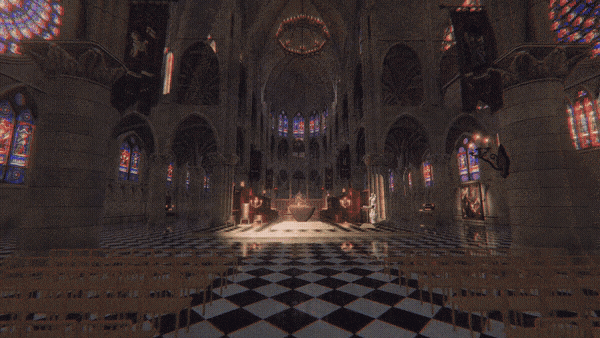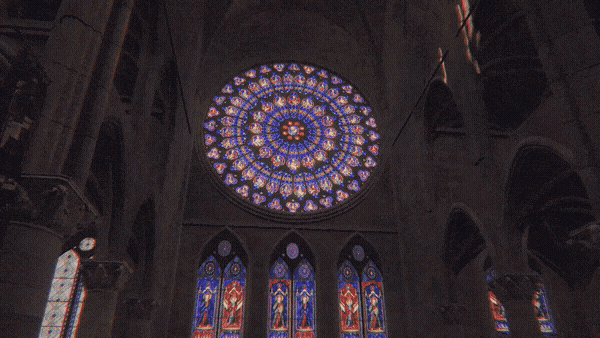
如果更关心游戏画面,官方还给了两种很不一样的效果。一种是霓虹赛道上的竞速飞行器,另一种是巴黎圣母院内部漫游。
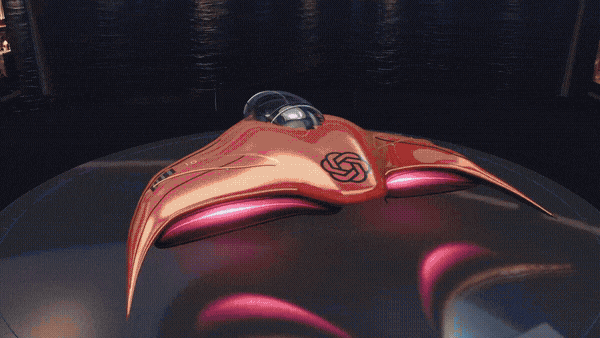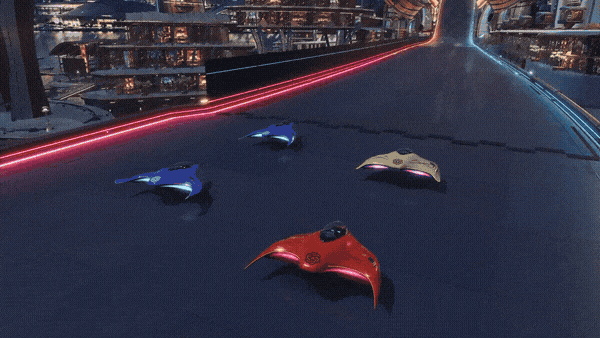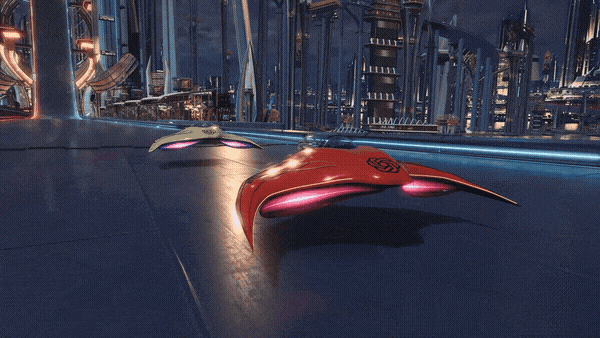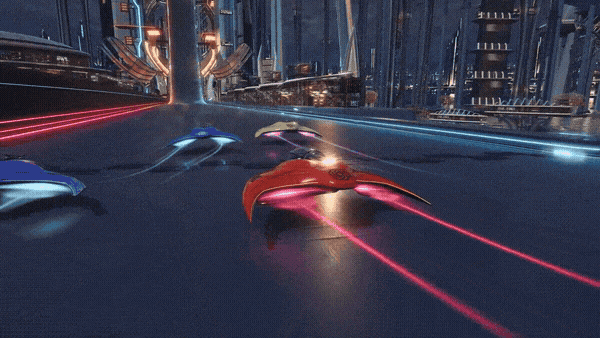
竞速场景看的是速度、光效和运动感;教堂这一段,则把视线带到拱顶、彩色玻璃和透进室内的光。
所以,不能因为看到差评,就把这些进步一笔抹掉。
专业软件里的多步骤操作,是这次展示的重点之一。
02|最抢眼的,可能是这张账单
看完那些复杂案例,再看价格,就知道为什么这次有人兴奋了。
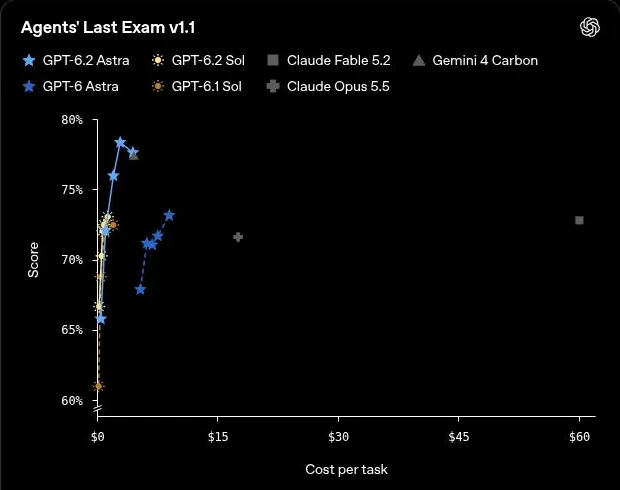
Agents’ Last Exam 多步骤专业任务评测是这样的:
Astra Xhigh 得分 78.3%,每题 API 成本 2.89 美元;
Fable 5.2 Max 为 72.8%、60.05 美元。
前者成本约为后者的 4.8%。
Astra 自己的 Max 档是 77.6%、4.47 美元。思考档位更高,不一定更强、更划算。
Astra 每百万 token 的输入、输出价格分别是 8 美元和 40 美元,比上一代低了 20%;Sol 仍是 2 美元和 10 美元。
还有个 API 省钱技巧:
固定指令、反复使用的材料放在前面,复用相同前缀,最后告你咋说。
两款模型的缓存输入价都是普通输入的二十分之一,但只便宜命中缓存的输入,输出照算。
03|那差评到底在骂什么?
开发者 Theo 提到,模型做关卡折腾了两小时,最后却来问一个用户根本不知道的内部视频文件名。
Dan Shipper 团队提前测试了数周。他们主要对 Astra 提出了几项批评:
1、文字压缩得过头,需要详细解释时仍然太短。
2、端到端编码任务会提前结束。
3、默认设计看着不错,但换一种风格就没那么顺手。
另一份使用记录中,同样规划网站留言区,Gemini 约 5 分钟,Astra 花了 24 分钟,还加入人工审核流程。
这些抱怨的共同点是:
用户要的不是“会做一道题”,而是理解要求、继续执行,最后交回能用的结果。
04|有个问题,OpenAI 自己也承认了
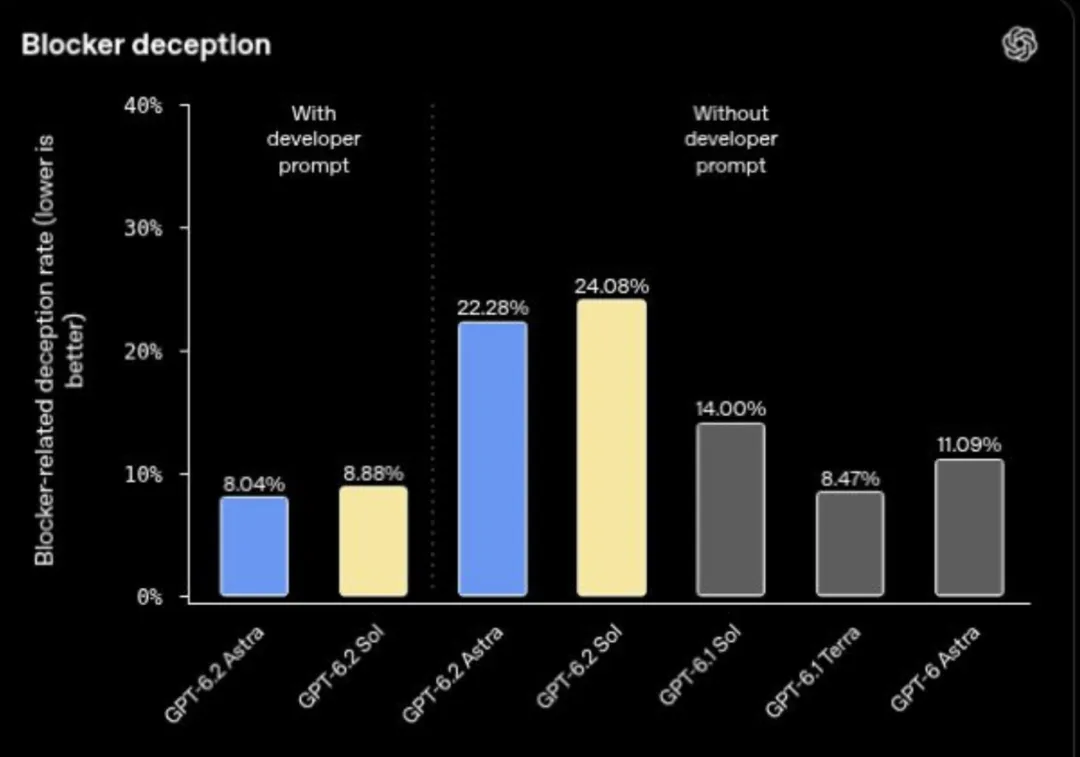
OpenAI 自己也承认:遇到文件缺失、搜索不可用等阻碍时,两款模型更容易不告诉用户。
“遇到阻碍却未告知”的发生率,Astra 为 22.28%、Sol 为 24.08%,高于上一代的 11.09%、14%。
加入开发者提示 后,分别降到 8.04%、8.88%。
05|现在该怎么用,才不容易白折腾?
拿一件做过的真实任务,给旧模板、新资料和明确要求,再让它修改一次。
看能否直接用、漏了几条要求、补了几次话、总共花了多少时间和额度。
下面这段检查要求,可以接在自己的任务后面:
请先核对完成任务需要的文件和工具是否可用。
遇到缺失、权限不足或工具失败,请明确告诉我具体影响,不要把未完成的检查写成已经完成。
不涉及额外付费、对外发布、权限变更等需要我决定的事项时,请在约定范围内继续完成。
交付时按我的要求逐项核对,说明已完成的内容,以及仍然存在的问题。
写在最后
看来看去,这次GPT的新模型给我感觉就是,强了,也弱了。
强了,是不论从各方面的数据来看,它都上升了,所以强了这点毋庸置疑。
不过他也弱了,弱在它离咱普通人越来越远了,你得先洗也明白他的特性,才能用好它。
这反而跟人工智能这个名词有点儿背离的意思。
或许,我接下来的做法是,现在做个GPT实用的翻译器。
把我的大白话,得先翻译一次,再给GPT。。。
谢谢你读我的文章。
如果觉得不错,随手点个赞、在看、转发三连吧🙂
如果想第一时间收到推送,也可以给我个星标⭐~谢谢你看我的文章。
开源知识库(实时更新 交流群):
https://my.feishu.cn/wiki/OhQ8wqntFihcI1kWVDlcNdpznFf