
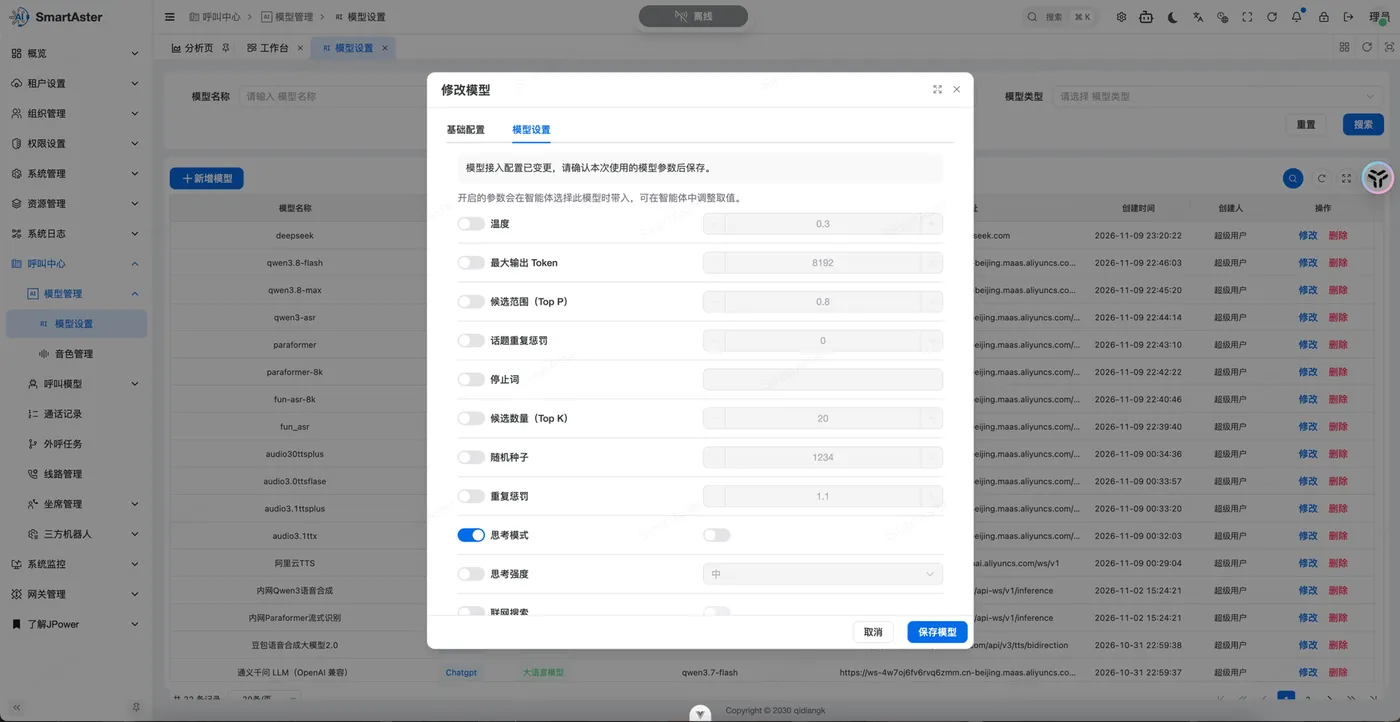
这是我维护的开源 AI 呼叫中心项目 SmartCall 的一篇开发记录。这次想聊的是最近上线的一个功能:模型参数的精细化配置。现在在模型管理里新增或修改模型时,「基础配置」旁边多了一个「模型设置」步骤,温度、最大输出 Token、思考模式、思考强度、联网搜索这些参数各自带一个开关,只有开启的参数才会在这个模型被智能体选用时带入,智能体还可以在自己的配置里继续调整取值。
这篇文章记录这个功能为什么这样设计、实现上的几个关键点,以及过程中踩到的坑。
一、问题:模型之间的参数差异比想象中大
SmartCall 的通话链路里,模型分为四个槽位:大语言模型(llm)、语音识别(asr)、语音合成(tts)、端对端实时模型(realtime)。最早写模型表单时我图省事,把温度、最大 Token 几个「通用参数」直接写死在页面上。接到二十几个模型之后,这个做法很快撑不住了:
- 参数集合对不齐。Qwen 的聊天模型有温度、Top P、Top K、随机种子、重复惩罚;走 OpenAI Responses 协议的型号只有思考强度、回答详略和最大输出 Token,根本没有温度;识别模型关心的是断句等待、热词表、识别语言;合成模型关心语速、音量、音调、采样率。
- 同一个含义在不同适配器下路径不同。最大输出 Token 在一个适配器里叫
max_tokens,在另一个里叫max_completion_tokens;思考强度在一个协议里是嵌套路径reasoning.effort,在另一个里是平铺的reasoning_effort。 - 参数有前置条件。思考强度开启时再传温度、Top P 这类采样参数,厂商接口会直接报错;联网搜索只在多模态生成接口下生效;思考强度要先开了思考模式才允许设置。
写死表单意味着每接一个新型号就要改一次页面。更麻烦的是,页面拦不住「配置了模型不支持的参数」,这类错误要到通话真正拨出时才暴露,排查成本很高。
二、思路:参数目录放在服务端,前端只负责渲染
我的结论是前端不应该持有参数清单。参数目录、校验规则、运行时消费方必须是同一份数据源,否则前端渲染出来的控件和后端实际放行的参数迟早会对不上。
具体做法是:后端按模型的「身份五元组」——槽位类型、厂商、模型名、适配器、接入地址——解析出一份参数目录,结构大致是:
adapter:这份配置最终落到的通话适配器;custom:是否为预设已验证模型,未收录的模型为 true;fields:参数映射表,每项包含显示名、控件类型(string、number、integer、boolean、json、select 六种)、请求路径(点号表示嵌套)、默认值、是否默认开启、数值范围与步长、下拉选项。
前端通过「模型参数模板」接口拿到目录后通用渲染:预设模型只出现「开关 + 值控件」;未收录的模型进入自定义分支,允许追加参数,自己填显示名、请求路径、控件类型、取值范围,甚至开关在请求层的两个映射值。这样我没验证过的模型也有可用的出路,而出路本身仍然受服务端校验约束。
模型名匹配时还有一个细节:厂商的型号常带日期后缀(例如 -0902、-2026-01-01 这类版本尾巴),精确匹配会漏掉同一系列的新批次。解析时先按正则把结尾的日期段削掉,用基础名去匹配目录,才保证了目录的命中率。
三、两层所有权:模型决定「传不传」,智能体决定「传什么值」
一个参数从配置到通话,要经过两层:
第一层是模型。模型的扩展参数字段里存的内容很克制:预设参数只存开关和默认值,自定义参数才额外保留映射信息。保存时服务端按当前目录逐项校验,并剥掉不该入库的展示字段,顺便把解析出的适配器回写到模型记录上。
第二层是智能体。智能体绑定模型时,后端用模型目录和模型层开关生成一份「参数快照」:只有开启的参数进入快照,快照项携带显示名、路径、控件类型、范围、选项和当前值,随绑定关系一起保存。智能体配置页对快照只渲染值控件,开关和映射在这一层不可改,对应界面上那句提示:开启的参数会在智能体选择此模型时带入,可在智能体中调整取值。
快照机制还带来两个约束:
- 智能体保存时,快照会按模型的当前目录重新校验。如果模型的接入配置后来变了,快照里的路径已经不存在,错误会在保存时报出来,而不是在通话中。
- 通话运行时只消费快照。装配会话配置时,点号路径被逐层展开成嵌套结构(
reasoning.effort展开为reasoning下的effort),交给通话运行时执行,运行时不再回读模型层的开关。
这个设计的代价是:模型层后来改了默认值,不会同步到已绑定的智能体。收益是智能体的行为由绑定时确认过的快照决定,不会被目录变更悄悄改动。在电话场景里我认为这笔交易划算,一通进行中的通话对「行为突然变化」的容忍度,比一个聊天窗口低得多。
四、前端:一个通用渲染器吃掉六种控件
模型表单在新增时是两步向导(基础配置、模型设置),编辑时是两个标签页。表单里维护一个身份键,由厂商、类型、模型名、适配器、地址序列化而来:身份键一变就重新拉取目录,并在参数页顶部提示「模型接入配置已变更,请确认本次使用的模型参数后保存」;提交时如果身份键变了且用户还没看过参数页,会强制跳回参数页确认,避免把旧参数存到新接入配置上。
控件渲染收敛在一个组件里:boolean 渲染开关,number 和 integer 渲染数字输入(整数锁精度、按目录步长步进),select 渲染下拉,json 渲染文本域并做宽容解析(解析失败就按字符串保留草稿,不丢用户输入),string 渲染输入框。自定义参数的映射编辑面板收在折叠块里,预设模型的界面保持干净。
还有一个异步时序问题:快速切换模型时,参数目录的请求会乱序返回,旧请求的响应可能覆盖新选择。模型表单和智能体抽屉里都用了自增的请求序号,响应回来时序号对不上就直接丢弃。这类问题不复杂,但一旦漏掉就是偶现的「参数面板和所选模型对不上」,很难查。
五、坑位记录:校验规则都是踩出来的
目录里的校验规则几乎每条都对应一次真实的报错,摘几条有代表性的:
- 适配器推断与一致性。大语言模型和 realtime 槽的适配器由服务端推断(例如走推理协议的型号强制 Responses 适配器,百炼 realtime 按型号分到 omni 或 audio 适配器),其余槽位则要求用户指定的适配器与解析结果一致,不一致直接拒绝保存。
- 参数互斥。Responses 适配器下思考强度不为「关闭」时,禁止设置温度和 Top P;生成适配器下设置思考强度前必须先开思考模式;断句方式不是静音断句时,断句等待参数不生效,一并拦下。
- 参数与接口地址绑定。启用联网搜索时,模型地址必须指向百炼的多模态生成接口;某型号走聊天兼容协议时,地址必须是 compatible-mode 路径。这类约束放在保存时校验,比等通话报错早了一步。
- 开关在请求层未必是布尔值。有的接口用字符串表示开关状态,所以布尔参数支持配置开、关两个映射值,运行时按开关状态替换成对应的请求值。
- 路径前缀冲突。自定义参数如果一个映射到
reasoning、另一个映射到reasoning.effort,展开嵌套结构时会互相覆盖。校验时对所有路径做前缀重叠检查,重叠即拒绝。 - 过期快照。模型目录是会演进的,旧快照里可能残留已下线的路径,所以智能体保存时必须重新过一遍校验,而不是信任库存数据。
六、边界:做到了什么,没做什么
说清楚边界,方便评估是否适合自己的场景:
- 参数目录目前覆盖我接入并验证过的厂商与适配器:百炼的 Qwen 聊天、Omni 与 Audio 实时、语音合成、FunASR 与 Qwen ASR,OpenAI 兼容的聊天与 Responses 协议,DeepSeek,火山语音合成,阿里云 NLS 识别与合成等。未收录的模型走自定义分支,参数正确性由配置者自行验证。
- 目录本身是 Java 代码,不是数据。新增一个已验证型号意味着改代码、发版,这是当前阶段的取舍:校验规则和运行时消费绑在同一份代码里,安全性优先于配置灵活性。把目录做成可配置数据、或从厂商元数据生成,是留给后续和二开空间的方向。
- 快照只在保存时校验,不做运行期热更新。通话进行中改配置不会影响当次通话,这是有意为之。
七、项目与地址
SmartCall 是我在维护的开源 AI 呼叫中心与语音智能体项目,包含外呼任务、智能体编排、IVR 流程、音色管理、通话记录与坐席等工作,采用 Apache 2.0 协议开源。
参数配置这个功能本身不算惊艳,但它把一个原本散落在各处的隐性知识——哪个模型支持什么参数、什么前提下支持——收敛成了一份可校验、可消费的结构。如果你也在做多模型接入的系统,希望这篇记录能帮你少踩几个坑。
