
导读:上一篇讲了批处理的三条路,这一篇补上流的这一半。重点不是罗列算子,而是把三件「决定作业生死」的事讲透:时间怎么定义、状态怎么扛住重启、写入怎么保证唯一。所有代码基于 Flink 2.3 实测写法。
一、最小可运行的流作业
StreamExecutionEnvironment env =
    StreamExecutionEnvironment.getExecutionEnvironment();

env.fromSource(kafkaSource, strategy, "orders")
   .map(this::parse)
   .keyBy(Order::getUserId)
   .window(TumblingEventTimeWindows.of(Time.minutes(1)))
   .reduce(new OrderAgg())
   .sinkTo(kafkaSink);

env.execute("stream-aggregation");
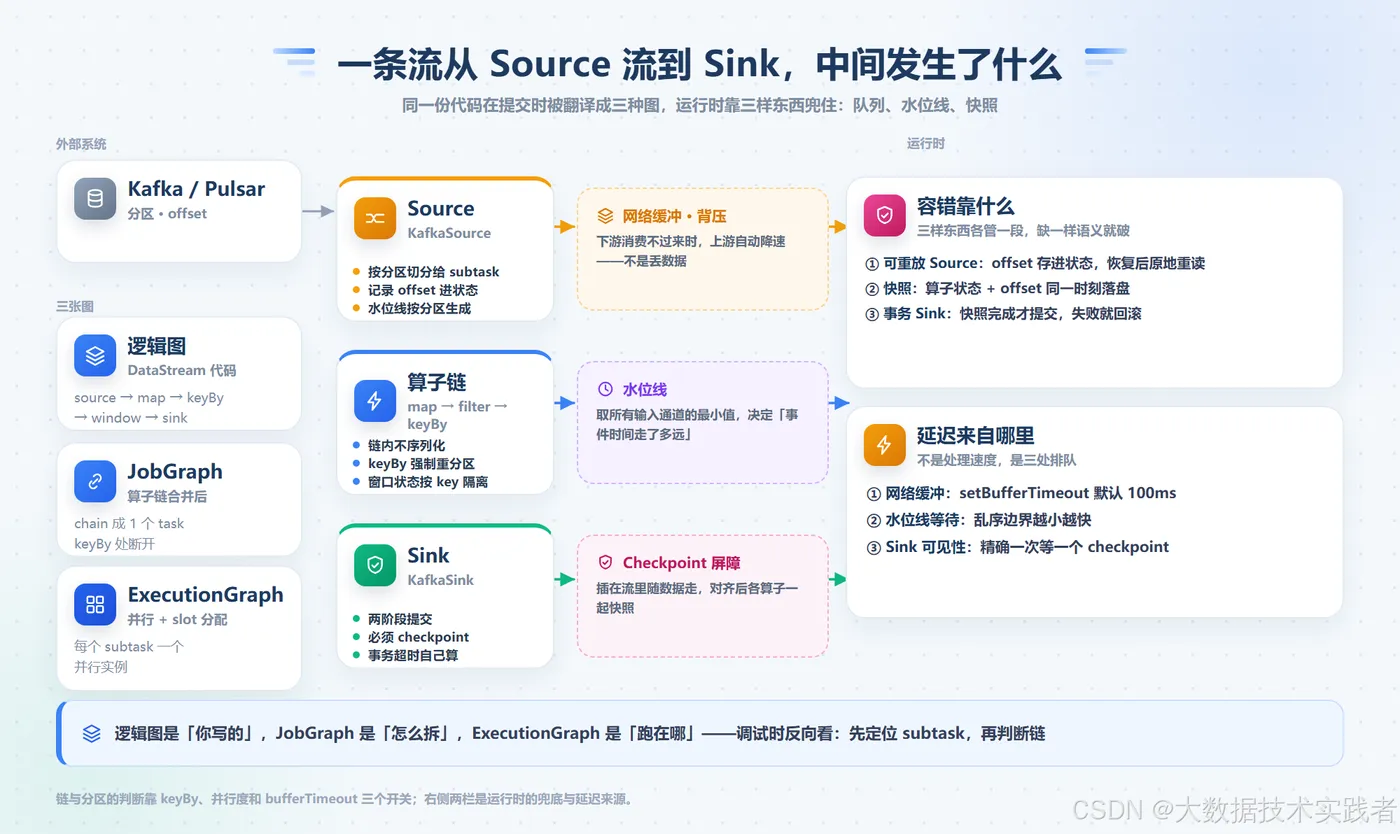
七行骨架,信息密度却很高:fromSource 接的是 Source V2 接口(2.x 唯一的路),keyBy 之后的每个算子按 key 隔离状态,window 等一个叫水位线的东西来关闭,sinkTo 决定失败时数据是重复、丢失还是刚好一次。这四行分别对应下面的四节。
还有个容易忽略的点:main 方法里所有代码都是「登记」,真正执行发生在 env.execute()。理解了惰性执行,就理解了为什么配置写在 execute 之后不生效。
提交时的翻译过程分三步:代码先变成逻辑图(你写的算子拓扑),再把无网络传输的相邻算子 chain 成一个 task(JobGraph),最后按并行度展开成 ExecutionGraph 分给 slot。三张图不是废话——Web UI 排障时看的就是后两张。
二、keyBy 之后:并行度、算子链与背压
env.setBufferTimeout(10);                    // 网络缓冲最长等待,默认 100ms
stream.map(this::enrich).name("enrich").uid("enrich-v1");
stream.disableChaining();                    // 强制该算子单独占一个 task
三件事决定了吞吐和延迟的形状:
- 算子链:
map → filter这类 1-to-1 算子默认链在一起,同链内数据在线程里直接传,零序列化开销。链是性能的命根子,disableChaining只该用在需要隔离慢算子的场景; - bufferTimeout:元素默认攒满缓冲区或等 100ms 才发。调小到 10ms 换低延迟,设 -1 只在缓冲区满时刷(吞吐最大)。不要设 0——每条记录一次网络往返,性能断崖;
- uid 必须显式指定:算子的唯一标识是状态在快照里的地址。不写的话 Flink 会按拓扑结构自动生成,拓扑一改(哪怕加个 filter),恢复时状态全部对不上号。改拓扑不丢状态,靠的就是 uid 稳定。
背压本身不用配——下游消费不过来,网络缓冲自动让上游降速。要看的是 Web UI 的反压指标:哪个算子 busy/backpressured,瓶颈就在它的下游。
三、Source:从 Kafka 读,先想清楚三件事
KafkaSource<String> source = KafkaSource.<String>builder()
    .setBootstrapServers("broker:9092")
    .setTopics("orders")
    .setGroupId("flink-demo")
    .setStartingOffsets(OffsetsInitializer.committedOffsets(
        OffsetResetStrategy.EARLIEST))
    .setValueOnlyDeserializer(new SimpleStringSchema())
    .build();
- 从哪开始读。
committedOffsets接着消费组上次的位置走,没有位置就退回 earliest——比裸的earliest()安全,升级重启不会重刷全量; - 分区发现。默认每 5 分钟发现新分区,
partition.discovery.interval.ms可调。Kafka 扩容不用重启作业,这是 Source V2 白送的; - 水位线给谁。策略直接挂在
fromSource的第二个参数上,Flink 会按 Kafka 分区分别生成再合并——比挂在算子后面精确得多。
补一个边界情况:Source 默认无界(流式),同一个类跑批处理时用 setBounded(offset) 限死停止位置——和上一篇批处理讲的「同一份代码 + 运行时模式」在这里接上了。分区乱序是另一个隐形坑:每个分区内时间戳有序,但并行消费多个分区后交错乱序,所以水位线必须按分区生成再合并,这正是把策略挂在 Source 上的理由。
四、时间:水位线是唯一的主角
WatermarkStrategy<Order> strategy =
    WatermarkStrategy
        .<Order>forBoundedOutOfOrderness(Duration.ofSeconds(5))
        .withTimestampAssigner((o, ts) -> o.getEventTime())
        .withIdleness(Duration.ofMinutes(1));
三个参数各管一件事:
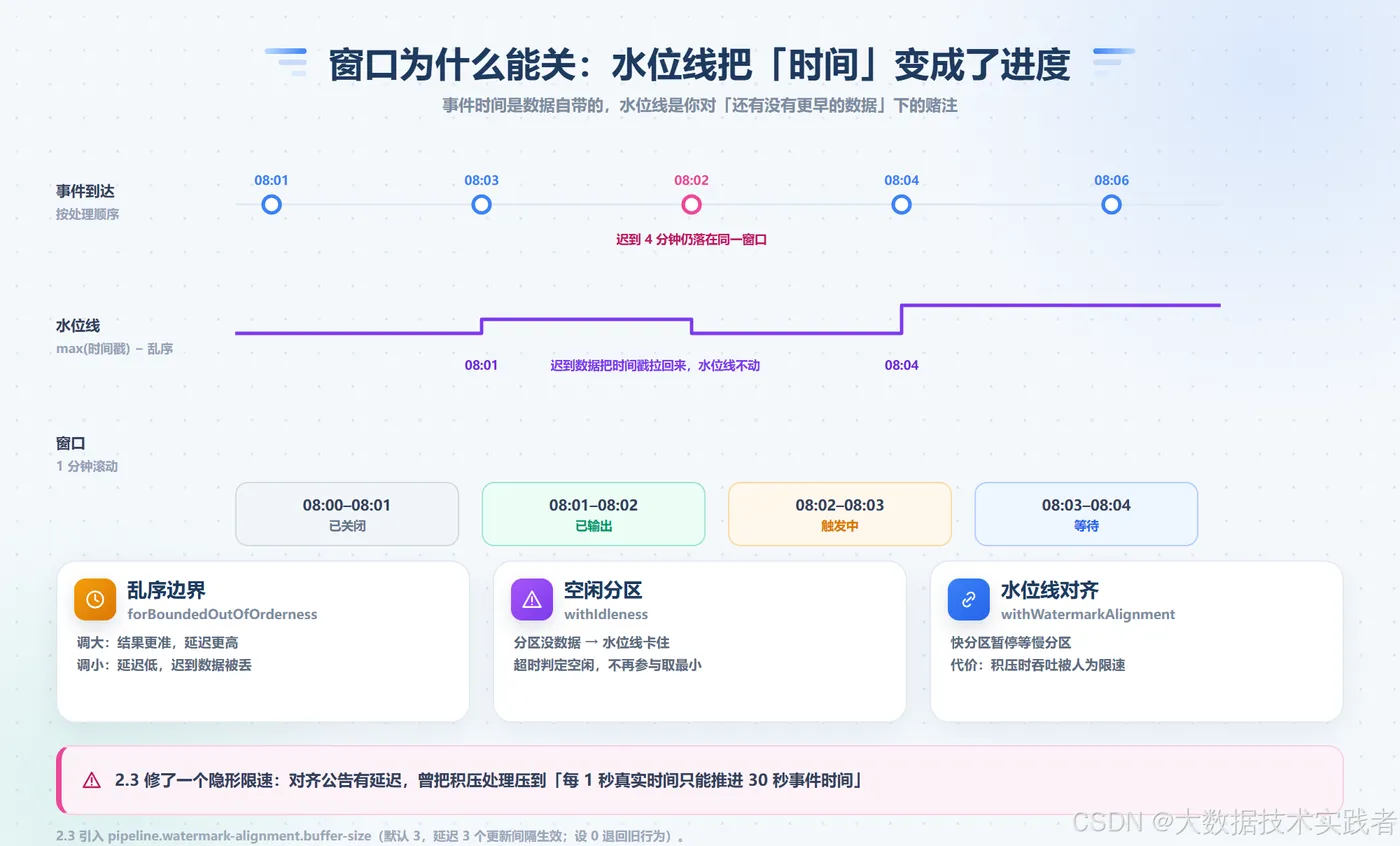
- 乱序边界(5 秒):水位线 = 见过的最大事件时间 − 5 秒。它越过窗口终点,窗口就关闭。这个值直接等于端到端延迟的下限——容忍 30 秒乱序,结果至少晚 30 秒出来;
- 时间戳分配器:从 Kafka 读时通常可省,记录自带时间戳;
- withIdleness:并行度大于分区数时,空 subtask 会把全局水位线卡死(水位线取所有输入的最小值)。超时判空闲,是救命参数。
2.3 还修了一个隐形限速:水位线对齐的公告有延迟,之前积压处理被压到「每 1 秒真实时间最多推进 30 秒事件时间」。新配置 pipeline.watermark-alignment.buffer-size 默认 3,把对齐延后三个更新间隔生效,设 0 退回旧行为。
五、窗口:语义在批流之间不变
窗口算子本身没多少可配置的,关键是想清楚按什么时间切:
| 时间语义 | 切分依据 | 什么时候用 |
|---|---|---|
| 事件时间 | 数据自带时间戳 | 统计口径要对(默认选择) |
| 处理时间 | 机器时钟 | 只要「大概每分钟一档」 |
事件时间窗口的输出是「水位线到达终点时一次性发出」,迟到数据三个去处:水位线没过终点就正常进窗口(allowedLateness 内重新触发);过了终点进侧输出流,人工兜底。没有任何配置能让迟到数据「自动算对」,边界必须显式定义。
六、状态:业务逻辑的最后一张牌
窗口和聚合覆盖不到的逻辑(去重、会话化、状态机、不规则窗口)用 KeyedProcessFunction 写。状态不再是黑盒,而是你直接持有的变量:
public class Dedup extends KeyedProcessFunction<String, Order, Order> {

    private transient ValueState<Boolean> seen;

    @Override
    public void open(Configuration cfg) {

        ValueStateDescriptor<Boolean> d =
            new ValueStateDescriptor<>("seen", Boolean.class);
        StateTtlConfig ttl = StateTtlConfig
            .newBuilder(Time.hours(24))
            .setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)
            .build();
        d.enableTimeToLive(ttl);
        seen = getRuntimeContext().getState(d);
    }

    @Override
    public void processElement(Order o, Context ctx, Collector<Order> out)
            throws Exception {

        if (seen.value() == null) {

            seen.update(true);
            out.collect(o);
        }
    }
}
这段代码里最重要的是 TTL:状态不会自己消失,seen 这种去重标记如果不配过期,会随 key 的数量无限增长,最后把 Checkpoint 拖垮——这是流作业状态膨胀的头号来源。规则很简单:每一个自己 update 的状态,都要能回答「它什么时候可以扔」。
按 key 访问的状态存在 RocksDB 或堆里(上一篇讲过后端选型),Checkpoint 时和 offset 一起落盘。这也是「重启不丢计算结果」的全部含义:状态在快照里,不在代码里。
七、状态与容错:Checkpoint 的最小正确配置
env.enableCheckpointing(60_000);
CheckpointConfig ck = env.getCheckpointConfig();
ck.setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE);
ck.setMinPauseBetweenCheckpoints(30_000);
ck.setCheckpointTimeout(120_000);
ck.setTolerableCheckpointFailureNumber(2);
ck.setExternalizedCheckpointRetention(
    ExternalizedCheckpointRetention.RETAIN_ON_CANCELLATION);
四个数各有讲究:
- 间隔 60 秒:故障恢复 = 重放这段时间的数据。间隔越大恢复越慢、对 Sink 事务的持有时间越长;
- min-pause 30 秒:强制两次快照之间留出实际处理的空档,否则快照本身会把作业拖垮。设了它,
maxConcurrentCheckpoints就不用管了(互斥); - 容忍 2 次失败:默认 0,第一次快照失败整个作业重启——生产上这个默认值过于激进;
- RETAIN_ON_CANCELLATION:手动停止作业后快照还在,改完并行度可以从断点续跑。
存储记得指向文件系统,默认的 JobManager 内存只适合本地调试:
execution.checkpointing.storage: filesystem
execution.checkpointing.dir: s3:///flink/ck/stream-demo
背压严重的作业再考虑非对齐 Checkpoint(enableUnalignedCheckpoints):快照不再等屏障对齐,耗时大幅下降,代价是在途数据要存进快照,状态变大。2.3 还允许恢复期间就打新快照(execution.checkpointing.unaligned.during-recovery.enabled),大状态作业重启后不再出现「几小时打不出一个快照」的窗口。
八、Sink:精确一次是一条时序,不是一个开关
KafkaSink<Order> sink = KafkaSink.<Order>builder()
    .setBootstrapServers("broker:9092")
    .setRecordSerializer(KafkaRecordSerializationSchema.builder()
        .setTopic("orders-agg")
        .setValueSerializationSchema(new OrderSchema())
        .build())
    .setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
    .setTransactionalIdPrefix("order-agg-prod")
    .setProperty("transaction.timeout.ms", "900000")
    .build();
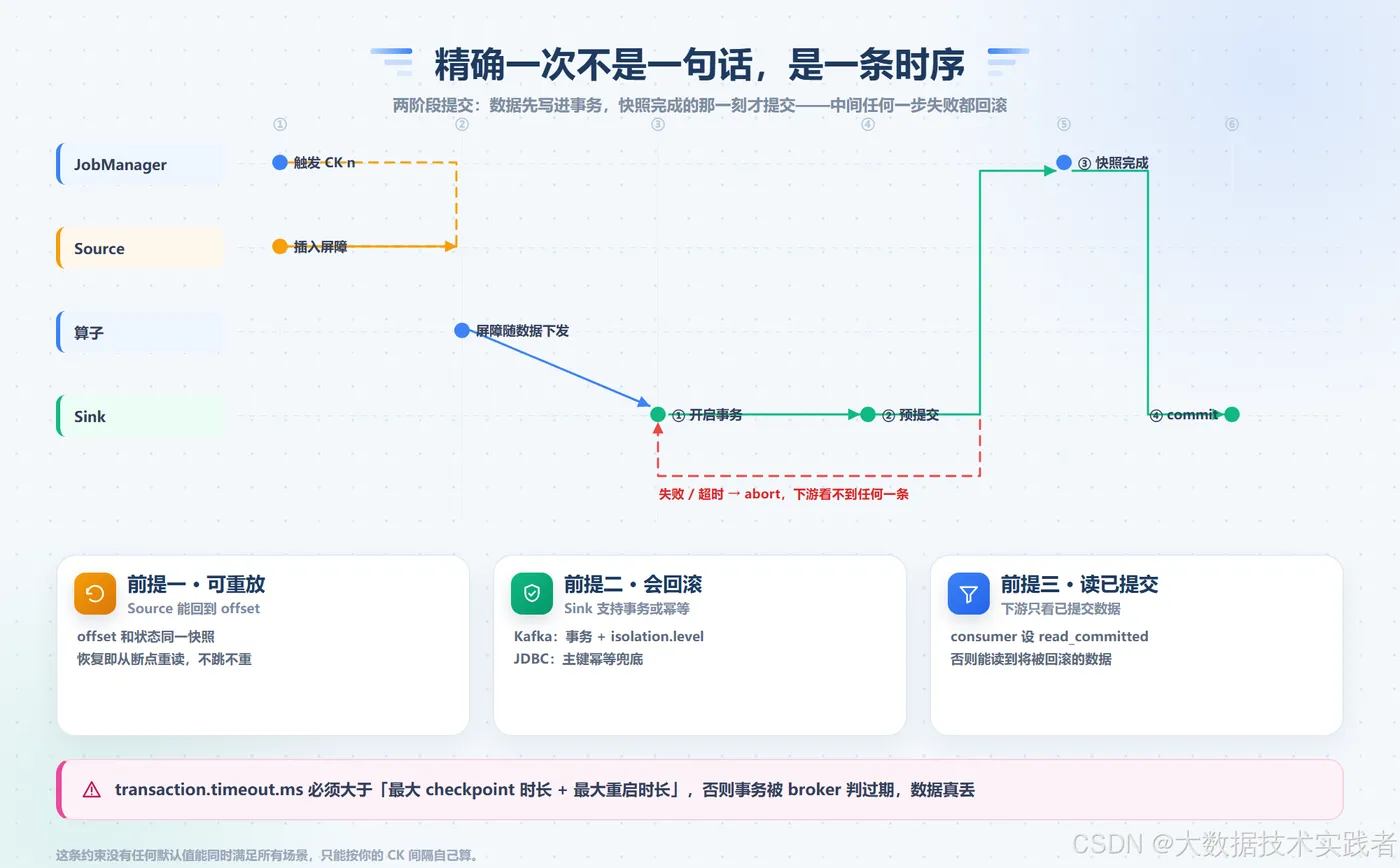
EXACTLY_ONCE 的机制是两阶段提交:数据先写进 Kafka 事务,Checkpoint 完成的那一刻才 commit。三个参数缺一个语义就破:
transactionalIdPrefix必须全局唯一——两个作业共用一个前缀,事务会互相干扰,这是文档加粗强调的坑;transaction.timeout.ms(示例 15 分钟)必须大于「最大 CK 时长 + 最大重启时长」,且不能超过 broker 的transaction.max.timeout.ms(默认 15 分钟)。生产者默认 1 小时直接撞 broker 上限,被拒后作业起不来;- 下游消费者要设
isolation.level=read_committed,否则能读到将被回滚的数据,精确一次形同虚设。
还要接受一个代价:消息在 Checkpoint 完成前对下游不可见。CK 间隔 60 秒,下游就最多延迟 60 秒见数。要低延迟又不必强一致,AT_LEAST_ONCE 配合下游幂等去重是更便宜的组合。
三档语义可以按 Sink 分别选,同一个作业里不同输出用不同保证完全合法:监控指标走 NONE(丢几条无所谓),业务事实表走 EXACTLY_ONCE,大流量中间结果走 AT_LEAST_ONCE + 幂等。语义是按输出逐个决定的成本项,不是作业级开关。
九、五个上线必撞的硬约束
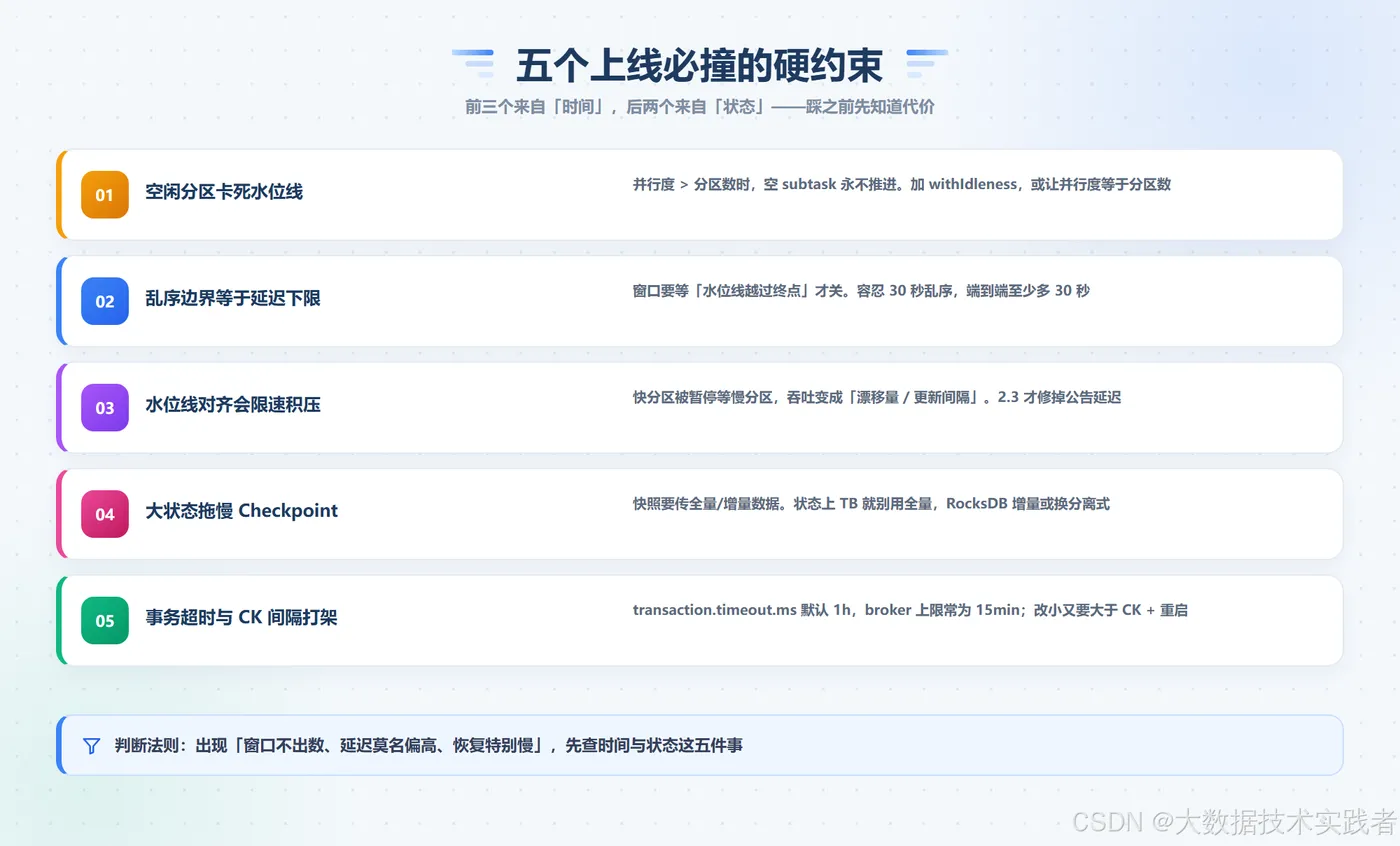
文档写在「注意事项」里、教程从不提:
- 空闲分区卡死水位线(见第三节);
- 乱序边界等于延迟下限(见第三节);
- 水位线对齐会限速积压(见第三节,2.3 已修);
- 大状态拖慢 Checkpoint:快照越来越慢 → min-pause 内处理时间不够 → 恶性循环。上 TB 就该换 RocksDB 增量快照;
write*()系列方法不参与 Checkpoint:失败即丢,只配调试用。上生产一律sinkTo。
十、提交与验证
flink run \
  -c com.demo.StreamAggregation \
  target/stream-demo-1.0.jar
验证顺序建议固定:先在 Web UI 的 Checkpoint 页确认快照稳定完成且大小正常;再杀掉 TaskManager 验证恢复;最后用 kafka-console-consumer --isolation-level read_committed 确认下游看到的数据无重复。三步都过,这个作业才算真正上线。
# 验证恢复:杀掉一个 TM 后作业应自动重启并从断点续跑
kafka-console-consumer.sh \
  --bootstrap-server broker:9092 --topic orders-agg \
  --isolation-level read_committed --from-beginning
监控上最值得看的三个数:Checkpoint 的 duration/pause(快照是否在挤压处理时间)、算子的 busyTime(瓶颈在哪一环)、Watermark 与系统时间的差值(时间维度是否健康)。这三个数稳定,作业就稳。
流处理的复杂度不在 API——API 就这七行骨架——而在时间、状态、一致性三个维度上每个参数的取舍。把这篇的约束清单过一遍,大部分「窗口不出数」「延迟莫名高」「恢复特别慢」都能在上线前拦住。
