摘要:为什么你的 Spark 任务 CPU 利用率只有 30%?为什么有些 Task 1 秒跑完有些要 10 分钟?这背后都是并行度(Partition 数 = Task 数) 的问题。本文从并行度公式推导、三条来源路径、spark.default.parallelism 与 spark.sql.shuffle.partitions 配置指南、数据倾斜三大解决方案(加盐/广播/AQE)、repartition vs coalesce 对比、AQE 自适应优化六个维度,配合 1 张原创深色架构图 + 完整配置示例 + 真实优化案例,助你彻底攻克 Spark 并行度调优。
关键词:Spark 并行度, Partition, shuffle.partitions, 数据倾斜, repartition, coalesce, AQE, 推测执行
一、开篇:并行度的核心公式
并行度 = Partition 数 = Task 数

理想值: 并行度 = 总 Core 数 × 2~3
最小值: 并行度 ≥ 总 Core 数(避免 CPU 空闲)
最大值: 避免单 Task 数据量 < 128MB(调度开销 > 计算收益)
反例:10 Executors × 4 Cores = 40 Cores,但 spark.sql.shuffle.partitions=200(默认值)→ 200/40 = 5 波 → 合理。如果改到 10 → CPU 浪费 75%。
二、并行度全景图
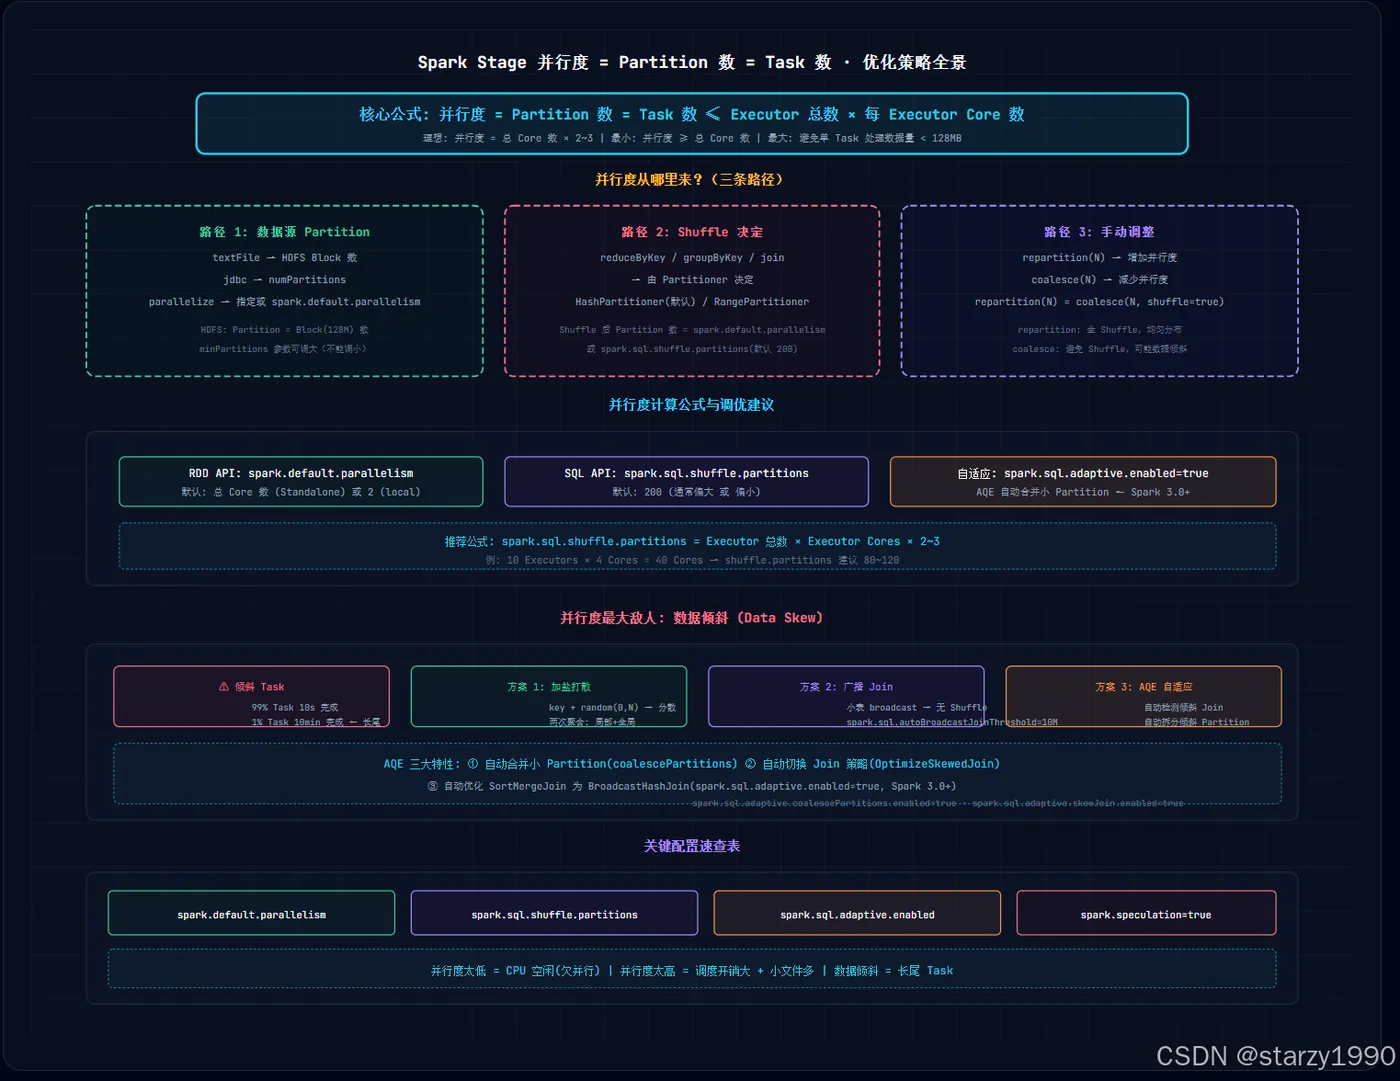
三、并行度三条来源路径
路径 1:数据源决定
| 数据源 | Partition 数 | 可调? |
|---|---|---|
textFile("hdfs://...") |
HDFS Block 数 | textFile(path, minPartitions) 可调大 |
jdbc(...) |
1 | numPartitions / partitionColumn 可调 |
parallelize(seq) |
spark.default.parallelism |
parallelize(seq, N) |
| Kafka | Topic Partition 数 | source 端调整 |
路径 2:Shuffle 决定
// Shuffle 后 Partition 数由以下配置决定:
// RDD API
spark.default.parallelism    // 默认: 总 Core 数

// SQL/DataFrame API
spark.sql.shuffle.partitions  // 默认: 200
路径 3:手动调整
rdd.repartition(100)   // 全 Shuffle → 均匀分布
rdd.coalesce(50)       // 无 Shuffle → 可能数据倾斜
// 规则: repartition(N) = coalesce(N, shuffle=true)
| 方法 | Shuffle | 均匀性 | 场景 |
|---|---|---|---|
repartition(N) |
✅ | ✅ 均匀 | 增加并行度 |
coalesce(N) |
❌ | ⚠️ 可能倾斜 | 减少并行度(N < 当前) |
四、关键配置与推荐值
# === RDD API 并行度 ===
--conf spark.default.parallelism=80     # 推荐: 总Core × 2~3

# === SQL/DF Shuffle 后并行度 ===
--conf spark.sql.shuffle.partitions=120 # 推荐: 总Core × 2~3 (而非默认 200)

# === 自适应执行 (Spark 3.0+) ===
--conf spark.sql.adaptive.enabled=true  # 自动合并小 Partition
--conf spark.sql.adaptive.coalescePartitions.enabled=true
--conf spark.sql.adaptive.skewJoin.enabled=true  # 自动处理倾斜 Join

# === 推测执行 (解决长尾 Task) ===
--conf spark.speculation=true
--conf spark.speculation.interval=100ms
--conf spark.speculation.multiplier=3
五、数据倾斜:并行度的头号杀手 🔥
5.1 三种解决方案
方案 1:加盐打散(两次聚合)
// 原始:key 倾斜
rdd.map((key, 1)).reduceByKey(_ + _)

// 加盐:key + random(0, N)
rdd.map { case (k, v) => ((k, Random.nextInt(10)), v) }
   .reduceByKey(_ + _)                      // 第一次聚合(分散后)
   .map { case ((k, _), v) => (k, v) }
   .reduceByKey(_ + _)                      // 第二次聚合(汇总)
方案 2:广播 Join
import org.apache.spark.sql.functions.broadcast
smallDF.join(broadcast(largeDF), "key")  // 小表广播,避免 Shuffle
--conf spark.sql.autoBroadcastJoinThreshold=10485760 # 10MB
方案 3:AQE 自动倾斜优化(Spark 3.0+)
--conf spark.sql.adaptive.skewJoin.enabled=true
--conf spark.sql.adaptive.skewJoin.skewedPartitionFactor=5
--conf spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes=256MB
# AQE 自动检测倾斜 Partition → 自动拆分为多个子 Task
六、真实优化案例
场景:某 ETL 任务 10 Executor × 4 Core,shuffle.partitions=50。
问题:CPU 利用率仅 62%,Stage 2 中 2 个 Task 耗时 8 分钟(其他 30s)。
诊断:并行度不足(50 < 40×3=120)+ 数据倾斜。
优化:
--conf spark.sql.shuffle.partitions=120     # 提升并行度
--conf spark.sql.adaptive.enabled=true      # 开 AQE
--conf spark.sql.adaptive.skewJoin.enabled=true
效果:CPU 利用率 → 91%,最长 Task → 45s,总耗时减少 68%。
七、总结
| 要点 | 总结 |
|---|---|
| 公式 | 并行度 = Partition = Task ≤ 总 Core × 2~3 |
| 配置 | RDD: default.parallelism · SQL: shuffle.partitions · AQE 自适应 |
| 倾斜方案 | 加盐打散 / 广播 Join / AQE 自适应倾斜优化 |
| 工具 | repartition(增) / coalesce(减) · 推测执行防长尾 |
金句:并行度太低,CPU 唱空城计;并行度太高,调度开销吃掉计算收益。数据倾斜是并行度的头号杀手——99 个 Task 干完等 1 个 Task,再高的并行度也白搭。
作者:starzy | AI Data Engineer / 大数据技术实践者
博客:blog.starzy.cn | GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践