用 hdfs dfs -put 上传一个文件,命令几秒钟就返回了。但在这几秒里,客户端、NameNode、三台 DataNode 之间完成了一次远比"复制文件"复杂的协作:建文件、切包、搭管线、串行转发、ack 确认、节点故障时还得动态修补。
很多人背得出"数据切成 block 存到 DataNode",却说不清 block 是怎么一个包一个包流到三台机器的,更说不清写的过程中一台 DataNode 突然挂了会怎样。这篇把 HDFS 写文件流程(Write Pipeline)从头到尾拆开。
30 秒心智模型
一次写文件分四件事:
- 建文件:客户端找 NameNode 在元数据里登记一个空文件,此时一个字节数据都没写;
- 切包:数据被切成 64KB 的 packet,放进"数据队列";
- 搭管线:NameNode 返回三台 DataNode,客户端把 packet 发给第一台,第一台转给第二台、第二台转给第三台——一条串联的复制管线;
- 确认与容错:packet 沿管线写完逐层回 ack,某台 DataNode 挂了就把它踢出管线,剩下两台继续写,副本不足由 NameNode 事后补齐。
一、第一步只是建文件,不写数据
很多人以为上传一开始就把数据发给 DataNode,其实不是。客户端先创建 DistributedFileSystem,向 NameNode 发一个 RPC:"我要创建一个文件,名叫 /user/x/a.parquet"——请求里不包含任何 block 数据。
NameNode 收到后做一连串检查:这个文件存不存在?客户端在这个目录有没有写权限?检查通过,它才在内存里建好文件元数据、并把这次"创建文件"操作写入 edits log。这一步失败会直接抛 IOException,客户端根本不会开始传数据。
为什么要这么"较真"?因为 NameNode 是元数据的唯一裁决者,它必须先确保"文件被允许存在",后面的 block 写入才有意义。等 NameNode 放行,客户端才拿到一个 FSDataOutputStream,真正开始写数据。
二、数据不是按 block 发,是按 64KB 的 packet 发
拿到输出流后,客户端并不会攒满 128MB 再发。它把数据切成一个个 packet,默认 64KB(参数 dfs.client-write-packet-size,默认 65536 字节),写入一个叫"数据队列(Data Queue)"的内部缓冲区。
这里有两个队列同时在跑:
- 数据队列:还没发出去的 packet;
- 确认队列(Ack Queue):已经发出、等待 DataNode 回 ack 的 packet。
一个叫 DataStreamer 的线程负责从数据队列取 packet,每攒满一个 block 的量就去问 NameNode:"这个 block 该写在哪三台 DataNode?"拿到地址列表后,把 packet 沿管线发出去;packet 在管线里全部写成功后,才从确认队列移除。
为什么要切到 64KB 这么细?因为写是边切边传的,不需要等整个 block 落盘才开始下一段;小 packet 也让 ack 和故障恢复的粒度更细——一台机器卡了,最多重传一个 packet,而不是整个 128MB。
三、复制管线:不是客户端写三遍,是串流传
NameNode 返回的三台 DataNode,会按顺序排成一条管线(Pipeline)。DataStreamer 把 packet 发给管线里的第一台 DataNode:
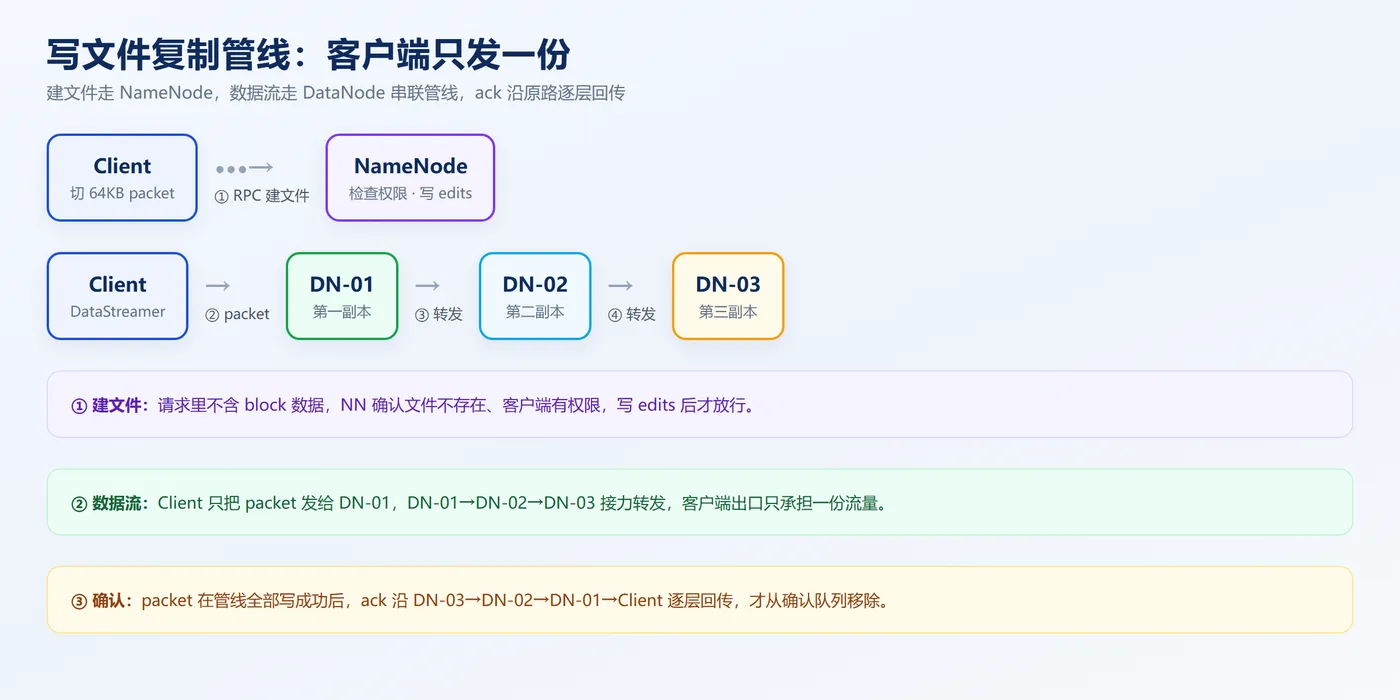
关键点:客户端只把 packet 发给 DN1,剩下的由 DataNode 之间互相转发。DN1 收到后转 DN2,DN2 再转 DN3;ack 则沿相反方向逐层回传。这样客户端出口只承担一份数据流量,三副本是 DataNode 之间"接力"完成的。
这和上一篇讲的副本放置策略正好咬合:NameNode 返回的三台 DataNode,就是按"第一副本本地、第二副本跨机架、第三副本同机架"选出来的,所以管线本身就天然控制了跨机架流量。
四、写一半某台 DataNode 挂了怎么办
这是写流程里最能体现容错设计的一段。packet 发送途中某台 DataNode 故障,HDFS 不会让整个写失败,而是做四件事:
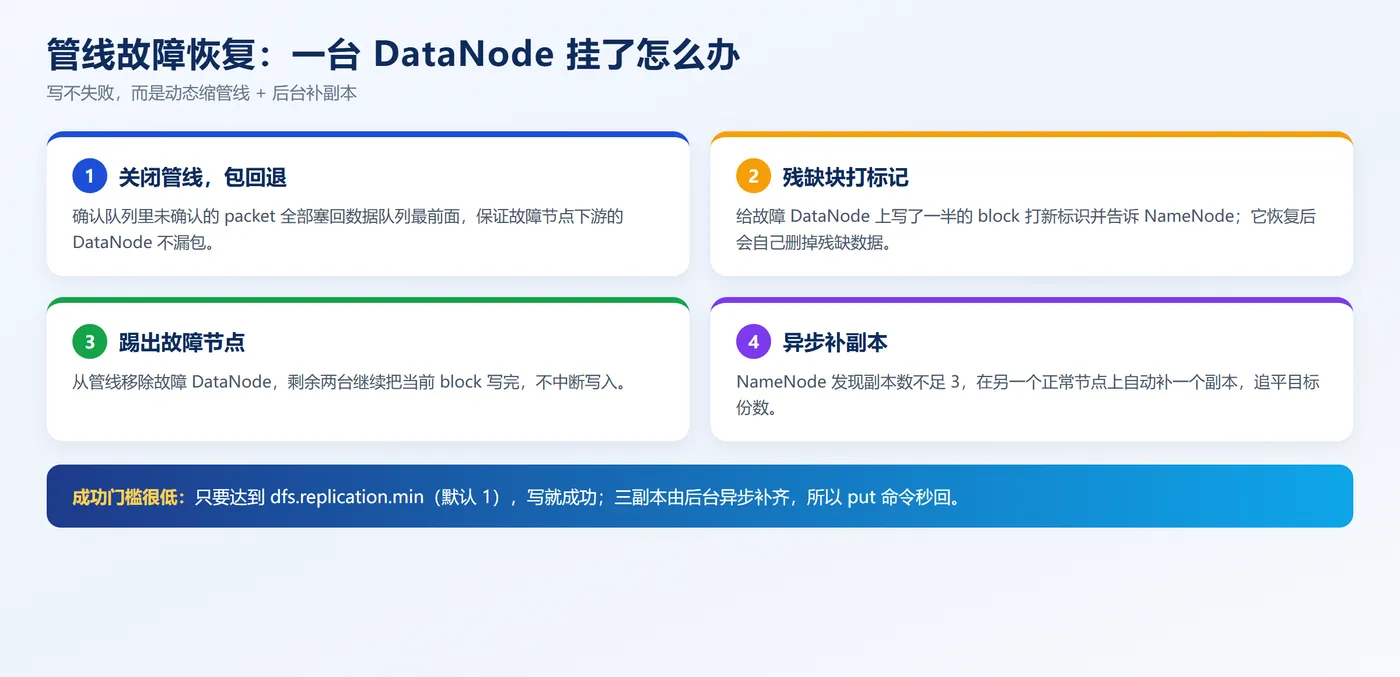
- 关闭管线:把确认队列里还没确认的 packet 全部塞回数据队列最前面,保证故障节点下游的 DataNode 不漏包;
- 打标记:给故障 DataNode 上已经写了一半的那个 block 打一个新标识,告诉 NameNode;等这台机器恢复后,它自己会删掉这块残缺数据;
- 踢出管线:从管线里移除故障节点,剩余两台 DataNode 继续把这个 block 写完;
- 异步补副本:NameNode 发现这个 block 副本数不够 3,会在另一个正常节点上自动补一个副本。
这里有个容易被忽略的设计:写返回成功的门槛很低。只要达到 dfs.replication.min(默认 1),客户端的写就算成功——哪怕此刻只写成功了一台 DataNode,剩下的副本由集群在后台异步补齐。这就是为什么你 put 命令秒回,但磁盘上的三副本可能要过几秒才齐。
五、为什么这么设计
整套写流程背后是三条工程取舍:
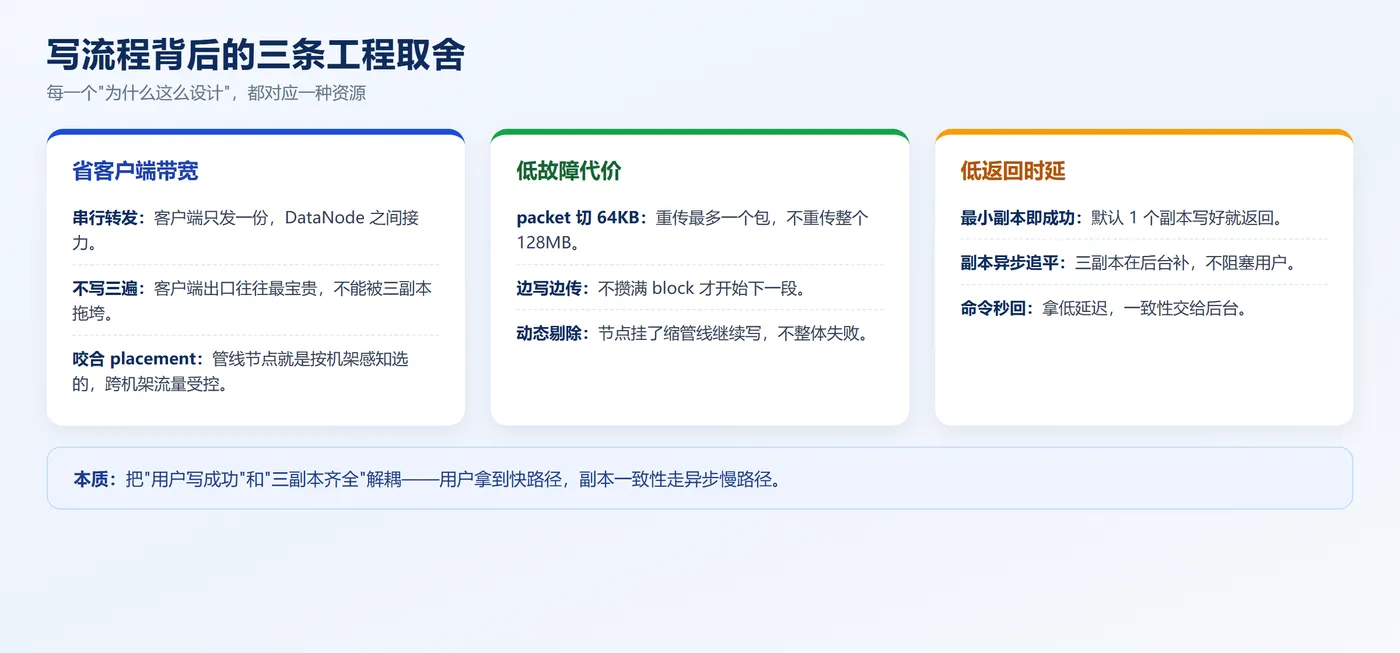
- 串行转发而不是客户端写三遍:客户端出口带宽往往最宝贵,让 DataNode 之间接力,客户端只发一份;
- packet 切得小:故障重传代价低、边写边传不攒大块;
- 最小副本成功即返回:把"写成功"和"三副本齐"解耦,用户拿低延迟,副本一致性交给后台异步追平。
六、常见误区
- 误区一:上传一开始就写数据。 第一步只是 NameNode 建元数据,数据在
FSDataOutputStream拿到后才开始流。 - 误区二:客户端同时往三台机器各发一份。 不是,只发第一台,其余 DataNode 之间转发。
- 误区三:命令返回 = 三副本已经写齐。 返回只代表达到最小副本数(默认 1),三副本是异步补齐的。
- 误区四:写的过程中一台 DataNode 挂了,文件就写失败。 不会,管线动态剔除故障节点,剩余节点继续写。
查看某文件当前 block 与副本分布:
# 查看文件 block、所在 DataNode 与机架
hdfs fsck /path/to/file -files -blocks -locations
写在最后
HDFS 的写流程,本质是把"一次写文件"拆成了元数据登记、细粒度切包、串联复制、逐层确认、动态容错五个独立环节。客户端只管把 64KB 的 packet 交给第一台 DataNode,剩下的接力、确认、补副本都由管线和 NameNode 协同完成。理解了这条 pipeline,再去看 HBase 的 WAL、Spark 的 RDD 写入,会发现分布式系统"串行转发 + ack 队列 + 故障剔除"是一套反复出现的套路。
下次上传大文件时,可以在另一个终端用 hdfs fsck 盯着 block 从 UNDER_RECOVERY 一步步变成三副本齐全——那条异步补副本的链路,就是这条写管线容错设计的现场。