一、前言
现在我们做大模型应用时,基本都不需要从零搭建全新系统。很多时候我们需要在现有的业务系统上进行扩展完善,手上本来就跑着一套Python Flask后端,SQLite存业务数据,还有Playwright写的网页爬虫采集模块,业务跑起来稳定,但缺少智能能力。
直接推翻重写成本太高,这里也容易通常容易遇到这个情况:强行把大模型硬塞进原有接口,出现数据不一致、采集任务与LLM调用互相阻塞、数据无法向量化,后期想拆成微服务更是寸步难行。今天就从已有存量系统出发,结合实际的应用经验,和大家深度探讨怎么将大模型集成进这套Flask+SQLite+Playwright的现有工程。先完成原型融合,再解决数据流转问题,最后平滑演进到生产数据库、向量数据库,拆解微服务改造思路。
二、存量系统基础梳理
1. 原有模块架构
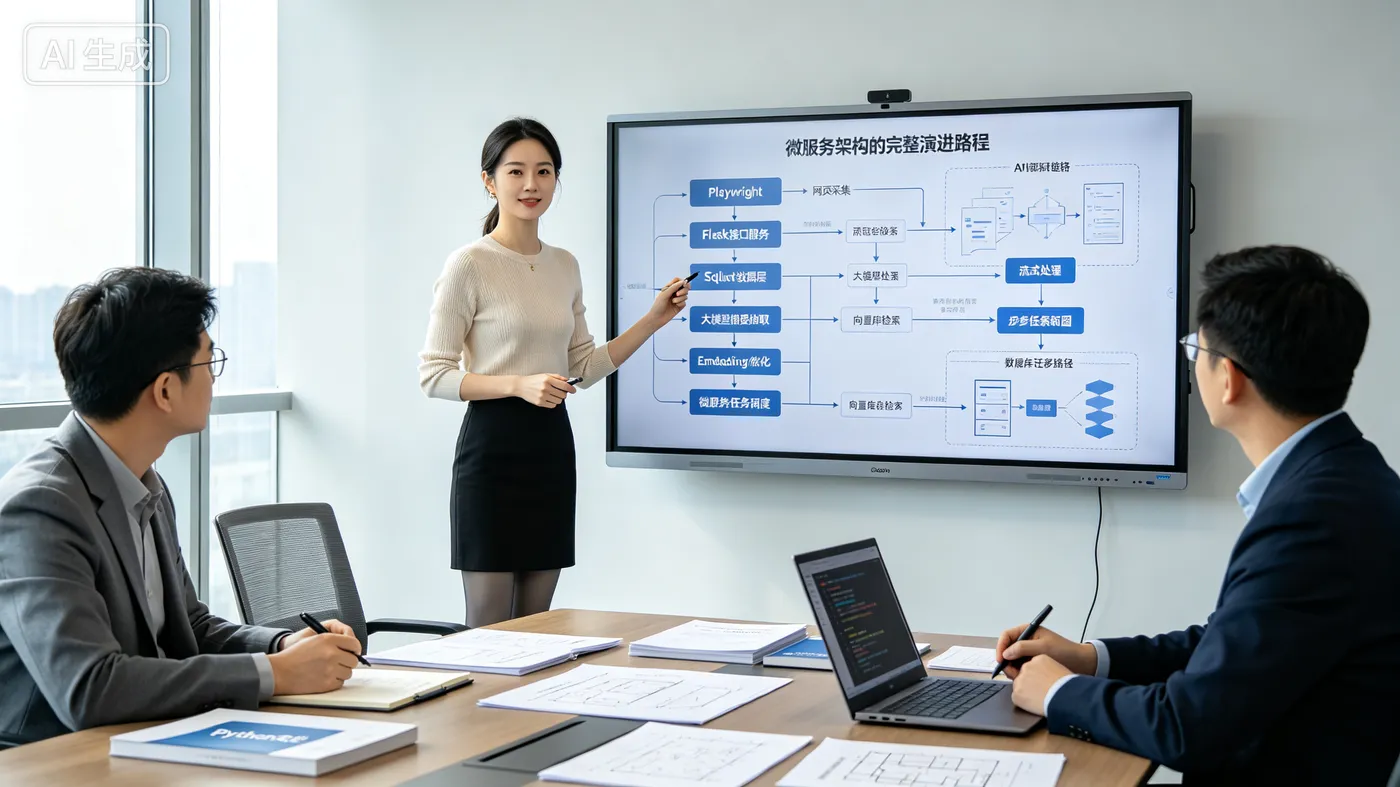
在接入大模型前,我们先要了解现有系统的各个组件,理清边界,避免改代码时牵一发而动全身。整个原有系统分为三大核心模块:Flask Web服务、SQLite数据持久层、Playwright网页采集模块。
- Flask服务:对外提供HTTP接口,接收前端请求,负责业务逻辑分发、参数校验,是整个系统入口。接口包含任务提交、采集结果查询、数据导出等能力,是业务流量入口。
- SQLite数据层:轻量本地数据库,存储采集任务配置、网页原始文本、任务状态、采集时间等业务数据,适合原型阶段快速开发,无需单独部署数据库服务。
- Playwright采集模块:自动化浏览器引擎,访问目标网页,渲染JS页面,提取网页正文、表格、截图,将采集后的原始数据回写到SQLite。
这套架构优势很明显:开发速度快,依赖少,本地一键启动,适合验证业务想法。但短板同样突出,尤其是接入大模型之后,短板会被放大。SQLite并发能力弱,不支持大规模查询;所有逻辑耦合在同一个服务内,采集任务会阻塞接口响应;没有向量检索能力,大模型只能一次性读取全文,长文本上下文极易超限。
我们的改造思路不是一次性替换全部组件,而是先集成大模型做能力增强,再逐步拆分、升级存储,最后拆成微服务。增量迭代,每一步都能保留原有业务能力,随时可以回滚。
2. 模块间数据流转
先梳理存量系统原生的数据流向,方便后续插入大模型能力节点。
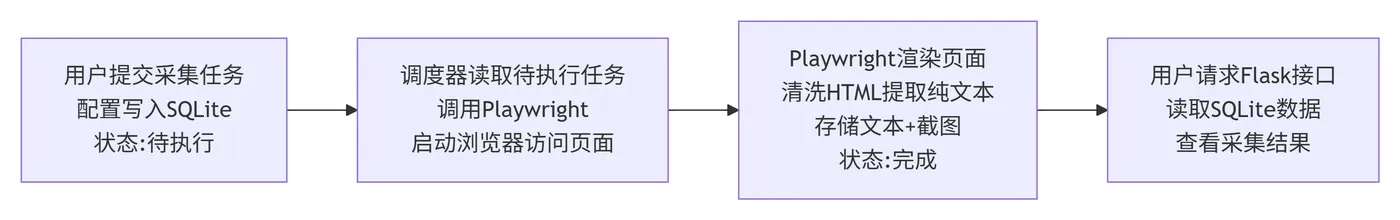
- 1. 用户通过Flask接口提交网页采集任务,任务配置写入SQLite,任务状态标记为待执行。
- 2. 后台调度器读取SQLite中的待执行任务,调用Playwright启动浏览器访问目标页面。
- 3. Playwright完成页面渲染,清洗网页HTML,提取纯文本内容,将原始页面文本、截图路径写入SQLite,任务更新为完成。
- 4. 用户再次请求Flask接口,读取SQLite内存储的网页原始数据,查看采集结果。
在原生链路里,数据采集完成就存储,没有二次加工、理解、摘要、检索的环节。接入大模型,就是在这条数据流上新增节点:网页采集完成之后,调用大模型对文本做摘要、抽取实体、生成标签,同时向量化文本,存入向量库。
这里有一个关键设计原则:原有采集链路保持不变。大模型作为附加处理环节,不修改Playwright采集逻辑,不改动原有SQL表结构,原型阶段直接复用原有数据。只有验证业务有效后,再升级生产数据库。
3. 原型阶段基础示例
下面是存量系统提取的极简原型,Flask+SQLite+Playwright基础骨架,为后续接入大模型做铺垫。
# app.py 存量基础服务 from flask import Flask, request, jsonify import sqlite3 from playwright.sync_api import sync_playwright import os app = Flask(__name__) DB_PATH = "crawl_data.db" # 初始化sqlite表 def init_db(): conn = sqlite3.connect(DB_PATH) cursor = conn.cursor() cursor.execute(''' CREATE TABLE IF NOT EXISTS crawl_task ( id INTEGER PRIMARY KEY AUTOINCREMENT, url TEXT, status TEXT DEFAULT 'pending', raw_content TEXT, create_time TIMESTAMP DEFAULT CURRENT_TIMESTAMP ) ''') conn.commit() conn.close() # playwright采集函数 def crawl_page(url): with sync_playwright() as p: browser = p.chromium.launch(headless=True) page = browser.new_page() page.goto(url, timeout=30000) content = page.locator("body").text_content() browser.close() return content .route("/task", methods=["POST"]) def create_task(): data = request.get_json() target_url = data.get("url") conn = sqlite3.connect(DB_PATH) cur = conn.cursor() cur.execute("INSERT INTO crawl_task(url, status) VALUES (?, 'pending')", (target_url,)) task_id = cur.lastrowid conn.commit() conn.close() return jsonify({"task_id": task_id, "msg": "任务创建成功"}) .route("/task/run/<int:task_id>", methods=["POST"]) def run_task(task_id): conn = sqlite3.connect(DB_PATH) cur = conn.cursor() cur.execute("SELECT url FROM crawl_task WHERE id=?", (task_id,)) row = cur.fetchone() if not row: return jsonify({"msg": "任务不存在"}),404 url = row[0] raw_text = crawl_page(url) cur.execute("UPDATE crawl_task SET raw_content=?, status='finished' WHERE id=?", (raw_text, task_id)) conn.commit() conn.close() return jsonify({"task_id":task_id, "content_len":len(raw_text)}) if __name__ == "__main__": init_db() app.run(debug=True, port=5000)

运行说明:安装依赖pip install flask playwright,执行playwright install chromium,启动服务后可以提交网页采集任务,网页文本存入SQLite。这个就是我们用来接入大模型的原始底座。
三、大模型集成原型改造
1. 在存量链路插入LLM能力
原型阶段,我们不改动原有采集和存储逻辑,在采集完成回调处,增加大模型调用。网页拿到原始文本后,调用大模型完成文本摘要、关键信息抽取,把LLM输出结果额外存入SQLite。
这里说明一下,为什么选择这个位置:
- 采集得到原始文本之后,是数据处理的天然节点。
- 原始网页内容噪声多,大模型负责提炼有效信息,业务接口后续可以直接读取LLM处理后的摘要,不用每次传递超长网页文本。
同时要做好边界控制:
- 增加文本截断,防止超长网页超出大模型上下文窗口;
- 增加异常捕获,LLM调用失败时不阻塞采集任务,任务状态依然标记成功,LLM结果留空,后续支持重试。
新增数据表字段,用来存放大模型输出:摘要、关键词、实体抽取结果。原型阶段直接扩展原有表,不需要新建表,降低改造复杂度。
2. 同步调用与异步任务选型
这里有两种接入方案,各有取舍。
- 同步调用:采集完成立刻调用大模型,简单、代码少,适合小流量原型。缺点是页面采集+LLM推理串行执行,任务耗时拉长,并发高的时候接口超时风险大。
- 异步任务:采集完成,提交LLM任务到任务队列,后台单独消费。接口立刻返回,不会阻塞前端,适合后续向生产环境演进,也是微服务改造的前置基础。
原型验证阶段优先同步方案快速验证效果;一旦业务流量上涨,直接切换异步队列。我们示例代码先用同步方式,方便调试。
3. 接入大模型完整示例
基于上面存量代码,增加大模型调用逻辑,我们接入LLM做网页内容摘要与关键词提取,这里用通用大模型API接口,方便替换各类国产LLM。
# 在原有app.py基础上新增代码 import requests LLM_API_KEY = "your_api_key" LLM_ENDPOINT = "https://xxx/v1/chat/completions" def llm_extract_info(raw_text): prompt = f""" 请对下面网页文本做两件事:1.生成200字摘要;2.提取5个核心关键词。 文本:{raw_text[:6000]} 输出JSON格式,包含summary、keywords两个字段 """ headers = {"Authorization":f"Bearer {LLM_API_KEY}", "Content-Type":"application/json"} payload = { "model":"xxx", "messages":[{"role":"user","content":prompt}], "temperature":0.3 } resp = requests.post(LLM_ENDPOINT, headers=headers, json=payload, timeout=40) res = resp.json() return res["choices"][0]["message"]["content"] # 修改数据库初始化,新增llm_result字段 def init_db(): conn = sqlite3.connect(DB_PATH) cursor = conn.cursor() cursor.execute(''' CREATE TABLE IF NOT EXISTS crawl_task ( id INTEGER PRIMARY KEY AUTOINCREMENT, url TEXT, status TEXT DEFAULT 'pending', raw_content TEXT, llm_result TEXT, create_time TIMESTAMP DEFAULT CURRENT_TIMESTAMP ) ''') conn.commit() conn.close() # 修改任务执行接口,采集完成后调用大模型 .route("/task/run/<int:task_id>", methods=["POST"]) def run_task(task_id): conn = sqlite3.connect(DB_PATH) cur = conn.cursor() cur.execute("SELECT url FROM crawl_task WHERE id=?", (task_id,)) row = cur.fetchone() if not row: return jsonify({"msg": "任务不存在"}),404 url = row[0] raw_text = crawl_page(url) try: llm_output = llm_extract_info(raw_text) except Exception as e: llm_output = f"LLM处理失败:{str(e)}" cur.execute("UPDATE crawl_task SET raw_content=?, llm_result=?, status='finished' WHERE id=?", (raw_text, llm_output, task_id)) conn.commit() conn.close() return jsonify({"task_id":task_id, "content_len":len(raw_text), "llm_result":llm_output})

执行后,采集网页的同时自动调用大模型解析页面信息,结果保存在SQLite。原型阶段到此完成:Flask服务、Playwright采集、SQLite存储+大模型能力全部打通,可以快速演示业务效果。
但原型不等于生产环境。随着任务变多,SQLite锁问题、长文本检索、接口阻塞等问题会陆续暴露,下一步就要开始分层演进。
四、向生产数据库迁移
1. SQLite到生产数据库的痛点
原型用SQLite开发简单,但并发写入、多实例部署、大数据量场景下存在硬伤。
- 文件级锁:多进程同时写入时,容易出现锁等待、写入失败。Flask多线程后台调度采集任务,并发任务一多就会触发锁异常。
- 不支持远程访问:SQLite是本地文件,多台机器部署无法共享数据,后续拆微服务无法共用数据源。
- 缺少完善事务隔离、备份、主从能力,生产环境数据安全、故障恢复难以保障。
当任务量上涨、需要多实例部署时,就需要迁移到MySQL/PostgreSQL这类生产关系型数据库。迁移不是一次性割接,推荐双写方案平滑迁移:原型同时写SQLite与新数据库,校验两边数据一致性,验证无误后切换主库,最后下线SQLite。
2. 数据分层存储设计
迁移数据库的时候,建议做数据分层,不要把原始大网页文本全部塞进关系库。
- 关系数据库:存储任务元信息,URL、任务状态、采集时间、关键词、大模型摘要这类结构化小字段,用于查询、任务调度。
- 对象存储:网页完整原始文本、截图文件,放到对象存储(MinIO/OSS),数据库仅保存文件路径。
- 向量数据库:文本切片、Embedding向量,独立存储,专门做语义检索。
分层的核心思想:不同数据交给最合适的存储。关系库管业务元数据,向量库管语义检索,对象存储存超大原始文本,各司其职。
3. 数据库迁移示例代码
简单演示SQL数据写入PostgreSQL示例,替换原有SQLite写入逻辑。
import psycopg2
PG_CONFIG = {
    "host":"127.0.0.1",
    "port":5432,
    "dbname":"crawl_prod",
    "user":"postgres",
    "password":"xxx"
}
def write_to_pg(task_id, url, raw_text, llm_result):
    conn = psycopg2.connect(**PG_CONFIG)
    cur = conn.cursor()
    sql = """
    INSERT INTO crawl_task (id, url, raw_content, llm_result, status)
    VALUES (%s,%s,%s,%s,%s) ON CONFLICT(id) DO UPDATE
    SET raw_content=%s, llm_result=%s, status='finished'
    """
    cur.execute(sql, (task_id, url, raw_text, llm_result, "finished", raw_text, llm_result))
    conn.commit()
    cur.close()
    conn.close()

五、向量数据库接入改造
1. 向量库的定位与价值
前面我们用大模型拿到网页摘要,但是如果需要根据用户问题,检索历史采集网页里相关内容,直接全库文本检索效率极低,关键词检索无法理解语义。向量数据库就是用来解决语义检索。
流程改造:网页文本清洗后,切分文本块,调用Embedding模型转为向量,存入向量数据库。用户提问时,问题向量化,在向量库做相似度检索,拿到相关片段,再交给大模型做RAG问答。
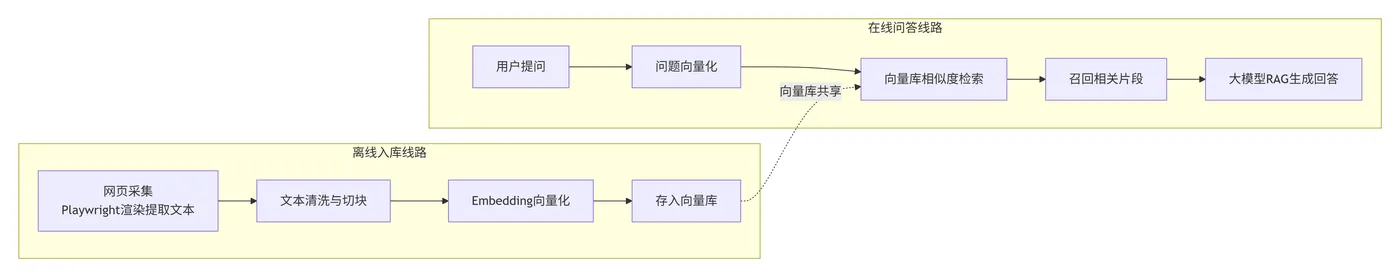
向量库不替代关系数据库,二者互补。关系库保存任务业务元数据;向量库保存文本分片+向量,负责语义召回。
2. 文本切分、Embedding生成流程
完整链路:Playwright采集原始网页→清洗去除HTML噪声→文本分片→Embedding编码→向量入库,同时保存分片对应的任务ID,方便关联回业务数据库。

- 分片策略很关键,分片太长,向量语义混杂;
- 分片太短,丢失上下文。一般设置chunk大小500~1000字符,重叠20%,保证段落之间上下文不中断。
3. 向量库基础代码示例
使用Chroma演示向量入库与检索逻辑。
from chromadb import Client
import requests
client = Client()
collection = client.get_or_create_collection("web_crawl_embedding")
def get_embedding(text):
    emb_url = "https://xxx/v1/embeddings"
    resp = requests.post(emb_url, json={"input":text, "model":"embedding-model"})
    return resp.json()["data"][0]["embedding"]
def save_embedding(task_id, chunk_text):
    vec = get_embedding(chunk_text)
    collection.add(
        embeddings=[vec],
        documents=[chunk_text],
        ids=[f"task_{task_id}_{hash(chunk_text)}"]
    )
# 语义检索
def search_by_query(query, top_n=3):
    q_vec = get_embedding(query)
    res = collection.query(query_embeddings=[q_vec], n_results=top_n)
    return res["documents"][0]

接入后,系统就具备RAG能力:用户提问,检索历史采集网页内容,让大模型基于真实采集网页回答,减少幻觉。
六、微服务架构演进设计
1. 单体服务拆分原则
当业务稳定,流量持续上涨,单体Flask服务会遇到瓶颈:网页采集、LLM调用、接口请求全部跑在同一个进程。浏览器Playwright非常消耗内存,采集任务多时,会挤占LLM推理和Web接口资源。
拆分思路:按职责边界拆微服务,尽量不一次性全部拆分,逐个剥离。
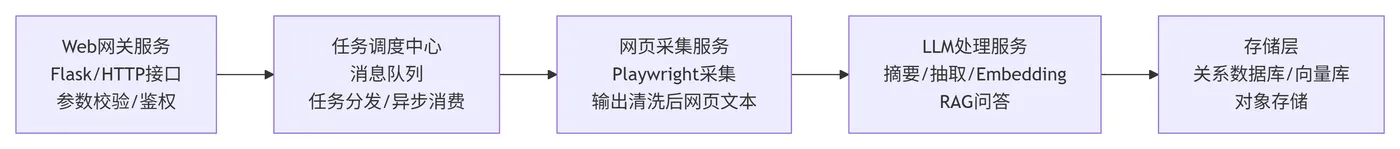
- 1. Web网关服务:保留Flask,对外HTTP接口,接收用户请求,做参数校验、鉴权。不再包含采集、LLM处理逻辑。
- 2. 网页采集服务:独立微服务,只负责Playwright网页采集,接收采集任务,输出清洗后的网页文本。
- 3. LLM处理服务:独立微服务,负责摘要、抽取、Embedding、RAG问答,封装所有大模型相关调用。
- 4. 任务调度中心:消息队列(RabbitMQ/Redis Queue)解耦,任务分发,异步消费。
- 5. 存储层:关系数据库、向量库、对象存储独立部署。
拆分之后,每个服务可以独立扩缩容。采集任务压力大,单独扩容采集实例;大模型调用高峰,扩容LLM服务,互不影响。
微服务架构说明:
| 服务 | 职责 | 技术栈 |
| Web网关服务 | 对外HTTP接口,参数校验、鉴权,不含业务逻辑 | Flask |
| 网页采集服务 | 独立微服务,负责Playwright网页采集,输出清洗文本 | Playwright |
| LLM处理服务 | 独立微服务,负责摘要、抽取、Embedding、RAG问答 | 大模型+向量库 |
| 任务调度中心 | 消息队列解耦,任务分发,异步消费 | RabbitMQ/Redis Queue |
| 存储层 | 关系数据库、向量库、对象存储独立部署 | MySQL/PG/对象存储 |
架构特点:
- 职责拆分:网关、采集、LLM三服务独立,各司其职
- 异步解耦:消息队列支撑任务分发,避免同步阻塞
- 存储独立:关系库、向量库、对象存储各自独立部署,互不干扰
- 可扩展:各服务独立扩容,采集压力大时可单独扩展采集服务实例
2. 消息队列解耦任务
微服务架构的核心是异步消息队列,把同步调用改成事件驱动。完整新链路:
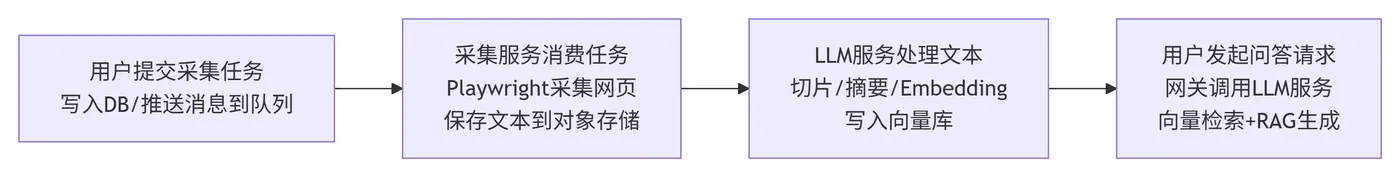
- 1. 用户提交采集任务到Web网关,写入数据库,推送任务消息到队列。
- 2. 采集服务监听队列,消费任务,Playwright采集网页,保存原始文本到对象存储,推送“采集完成”事件。
- 3. LLM服务监听采集完成事件,读取网页文本,切片、生成摘要、Embedding写入向量库。
- 4. 用户发起问答请求,网关调用LLM服务,执行向量检索+RAG生成答案。
消息队列隔离各个服务,某个服务临时故障,任务保存在队列,不会丢失,天然支持重试,大幅提升系统可靠性。
3. 微服务任务调度示例
# redis队列简单任务分发示例
import redis
import json
r = redis.Redis(host="127.0.0.1", port=6379, decode_responses=True)
# web网关提交任务
def submit_crawl_task(url, task_id):
    msg = json.dumps({"task_id":task_id, "url":url})
    r.lpush("crawl_task_queue", msg)
# 采集服务消费任务
def consume_crawl_task():
    while True:
        msg = r.brpop("crawl_task_queue", timeout=2)
        if not msg:
            continue
        data = json.loads(msg[1])
        task_url = data["url"]
        task_id = data["task_id"]
        raw_txt = crawl_page(task_url)
        # 推送采集完成事件,交给LLM服务消费
        finish_msg = json.dumps({"task_id":task_id, "raw_text":raw_txt})
        r.lpush("llm_process_queue", finish_msg)

七、生产环境风险与优化
1. 系统稳定性风险点
整套系统在生产运行,有几类高频风险需要提前做好防护。
- Playwright浏览器稳定性:长时间运行内存泄漏,浏览器进程崩溃。解决方案:设置浏览器自动重启、单任务结束关闭浏览器实例,进程监控与自动恢复。
- LLM接口限流、超时:大模型API都有QPS限制,增加限流、重试、熔断机制,避免雪崩。
- 向量库性能:海量网页分片后,检索延迟上涨,增加索引优化、冷热数据分离。
- 数据一致性:异步多服务场景,任务状态流转容易不一致,增加状态机,每个任务只有固定状态流转路径,增加定时巡检任务补偿失败项。
2. 监控与可观测建设
接入日志、指标监控,重点监控这些指标:采集成功率、LLM调用失败率、向量检索耗时、队列堆积长度。
- 采集模块:页面加载超时率、浏览器崩溃次数。
- LLM模块:接口耗时、token消耗、失败次数。
- 消息队列:队列长度、消费速率,队列堆积提前告警。
3. 限流、重试与熔断示例
import time
def llm_with_retry(prompt, max_retry=3):
    retry_count = 0
    while retry_count < max_retry:
        try:
            return llm_extract_info(prompt)
        except Exception as e:
            retry_count +=1
            time.sleep(1.5 * retry_count)
    raise Exception("大模型调用多次失败")

八、总结
从存量Python Flask+SQLite+Playwright系统出发,演示大模型渐进式集成方案。不需要推翻原有业务系统,先在原型中接入LLM实现网页智能解析,验证业务价值。当业务增长之后,分阶段完成架构升级:从SQLite迁移到生产关系数据库,引入向量数据库实现语义检索,最后拆分为多微服务,使用消息队列异步解耦各个模块。
整个演进路径是增量迭代:原型验证→存储升级→向量检索→微服务拆分。每一步都可以独立上线,随时验证效果,降低大规模重构带来的风险。实操过程里也有很多需要注意的重点,Playwright长时间运行容易内存泄漏,大模型API会有限流超时,异步场景还要保障任务状态一致性,这些生产细节一定要提前考虑,加上重试、监控机制。理解是一回事,实际上手估计还会有各种奇奇怪怪的问题,但办法总比困难多,好好琢磨,都会迎刃而解。