
Qwen4-Max预览版已开放调用,同步开放的还有限时2折的调用折扣。对开发者来说,真正需要判断的不是"折后多少钱",而是三件事:这个模型适合什么任务、2折的边界在哪里、预览版在生产环境能不能用。本文按定位、计费、接入、实测、避坑五个部分展开,命令可直接复制执行。
一、首发信息与定位
Qwen4-Max属于旗舰级通用模型,命名中的Max表示同代产品里的最高规格档位,"预览版"则表示模型能力仍在迭代,接口与效果可能随版本更新调整。详情👉访问阿里云百炼大模型服务平台页面 了解。
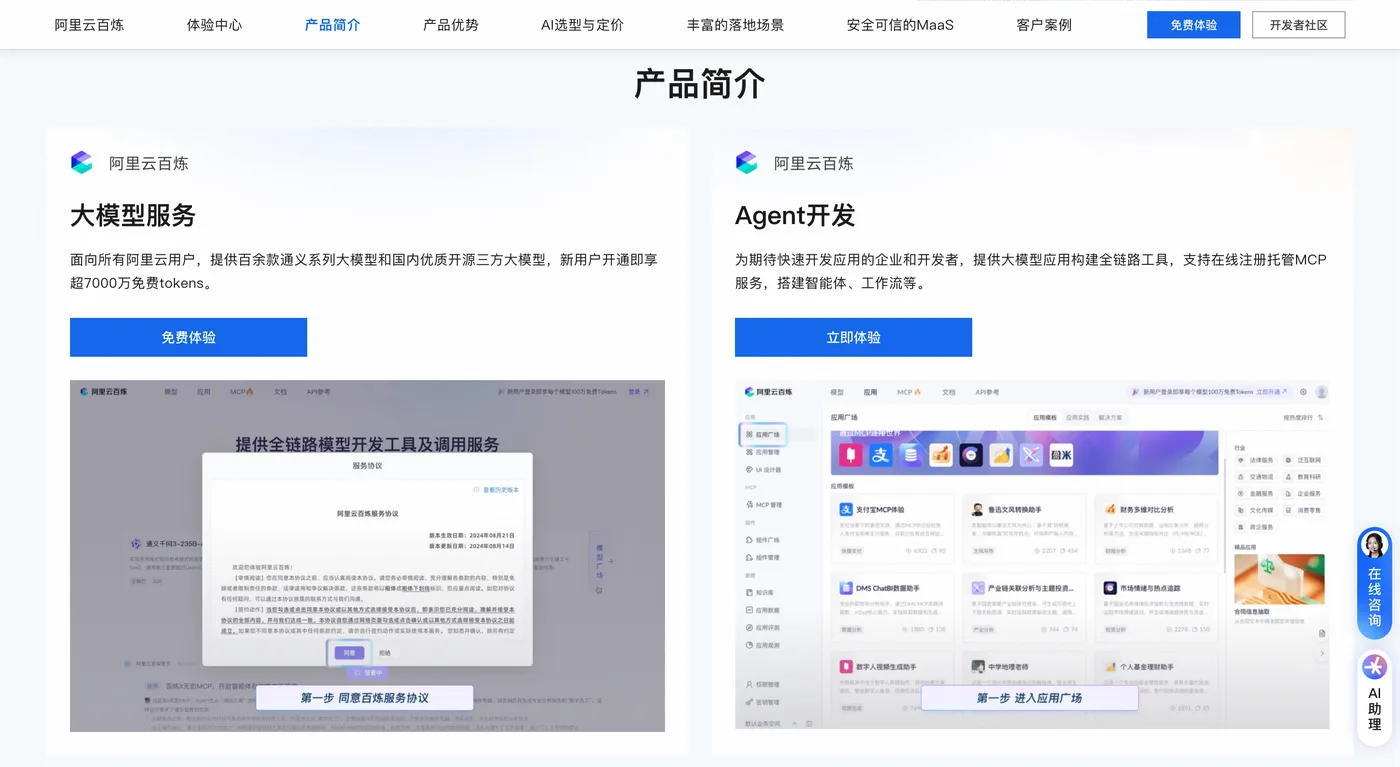
它的定位与轻量档位不同:Qwen4-Max面向的是复杂推理、长文档理解、多步骤任务编排、高质量内容生成这类"对结果质量敏感"的场景;对延迟和成本敏感的高并发简单任务,仍应使用Flash或Plus档位。
预览版阶段的两个现实约束:一是模型行为可能随版本更新变化,同样的提示词在不同时间点产出可能不同;二是价格与限流策略属于临时性安排,以控制台与模型列表页展示为准。
二、2折的边界
限时2折针对的是模型调用费用,即按Token计费的输入与输出部分。需要明确几条边界:
适用模型范围:折扣通常限定在特定模型标识上,同一系列的其他档位不共享折扣。
时间范围:属于限时安排,到期后回归标准价,长周期项目要按标准价做预算。
叠加规则:折扣价通常不与免费额度之外的资源包、节省计划折扣叠加,具体以结算页判定为准。
计费维度:输入Token与输出Token分别计价,输出单价一般高于输入,因此"少输出、多约束"的提示词设计能直接降低费用。
换句话说,2折省钱的前提是"调用量集中在Qwen4-Max上"。如果只是偶尔试几次,省下的钱有限;如果有稳定的大批量调用,2折期间做迁移和压测才是正确用法。详情👉访问阿里云百炼大模型服务平台页面 了解。
三、计费与额度结构
按Token计费,输入输出分开。抵扣顺序为:免费额度 → 资源包 → 节省计划 → 按量付费。
免费额度:新用户实名后,每款主流模型通常有百万Token量级、有效期为90天的免费额度,地域多限华北2(北京)。用它先把模型能力和调用链路跑通,是最省的方式。
资源包:按容量预购,适合用量平稳的场景,单价低于按量。
节省计划:以承诺用量换单价,适合可预测的长期调用。
按量:兜底方式,用多少算多少。
一个实用建议:把免费额度用在效果验证上,把2折期用在压测和迁移上,把资源包留给稳定期。三者混用会把成本曲线搞乱。详情👉访问阿里云百炼大模型服务平台页面 了解。
四、接入与核验命令
先用curl验证密钥与模型是否可用(OpenAI兼容模式):
export DASHSCOPE_API_KEY="sk-xxxxxxxx"
curl [https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions](https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions) \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen4-max-preview",
    "messages": [{"role":"user","content":"用三句话说明这个模型适合什么任务"}],
    "temperature": 0.3
  }'
流式调用,用于验证首字延迟:
curl [https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions](https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions) \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen4-max-preview","stream":true,"messages":[{"role":"user","content":"写一段200字的项目背景"}]}'
Python SDK方式,便于接入业务代码:
pip install openai -U
python - <<'PY'
from openai import OpenAI
client = OpenAI(api_key="sk-xxxxxxxx",
                base_url="[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)")
resp = client.chat.completions.create(
    model="qwen4-max-preview",
    messages=[{"role": "user", "content": "把这段需求拆成任务清单:上线一个带缓存的商品接口"}],
    temperature=0.2,
)
print(resp.usage)
print(resp.choices[0].message.content)
PY
resp.usage里的prompt_tokens与completion_tokens就是本次计费的依据,用它核算实际单价是否落在2折档。
查看可用模型列表,确认模型标识与状态:
curl [https://dashscope.aliyuncs.com/compatible-mode/v1/models](https://dashscope.aliyuncs.com/compatible-mode/v1/models) \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY"
核对账单,确认是否按折扣价结算:
aliyun bssopenapi QueryAccountBill --BillingCycle $(date +%Y-%m) --Granularity MONTH
五、实测关注点
长文档理解:预览版在长上下文任务上的稳定性通常优于小档位,但要实测你的真实文档长度,而不是用短样本推断。
结构化输出:要求输出JSON时,建议显式给出字段名与取值约束,并设置较低temperature,减少格式漂移。
函数调用:多步骤任务编排是旗舰档位的主要价值点,实测时应把工具描述写清、参数类型明确,否则容易产生无效调用。
延迟与吞吐:旗舰档位的单次延迟高于轻量档位,高并发场景要提前压测QPS与配额上限。
预览版风险:效果可能随版本更新变化,生产环境建议保留降级到稳定档位的开关。
六、避坑清单
模型标识写错会直接报模型不存在,先用模型列表核验。
2折是限时安排,长周期预算要按标准价复算。
输出Token单价高于输入,冗长输出是成本主因。
免费额度有地域限制,跨地域调用不抵扣。
预览版行为可能变化,生产链路需保留降级开关。
折扣不与资源包、节省计划叠加,混用前先看结算页。
高并发要确认配额上限,避免压测时被限流。
温度设置过高会放大格式漂移,结构化输出建议低于0.3。
总结
Qwen4-Max预览版的价值在于"复杂任务一次做对",2折则是把这种能力临时拉到可承受的成本区间。正确用法是:用免费额度验证效果,用2折期完成压测与迁移,用资源包承接稳定期用量。同时记住预览版的三个变量——模型可能迭代、价格限时、折扣不叠加。把这些边界写进预算表,2折才是真的省。
