
Qwen4-Max预览版这轮对外释放的信息集中在两个方向:编程能力与Agent能力,同时开放了最低1折的体验档。对开发者而言,值得关注的是"能力升级落在哪些具体任务上",以及"1折体验的边界在哪",而不是折扣数字本身。本文按能力拆解、体验规则、接入命令、实测要点四部分展开。
一、升级落在两类任务上
编程能力:旗舰档位的编程能力体现在跨文件改动、依赖理解、测试生成与错误定位。与小档位相比,差别不在"能不能写出代码",而在"改代码时能否理解上下文"。一个真实仓库里的需求很少是单文件函数补全,多是"在既有结构上改一处并保持其他行为不变",这类任务对上下文理解要求高。详情👉访问阿里云百炼大模型服务平台页面 了解。
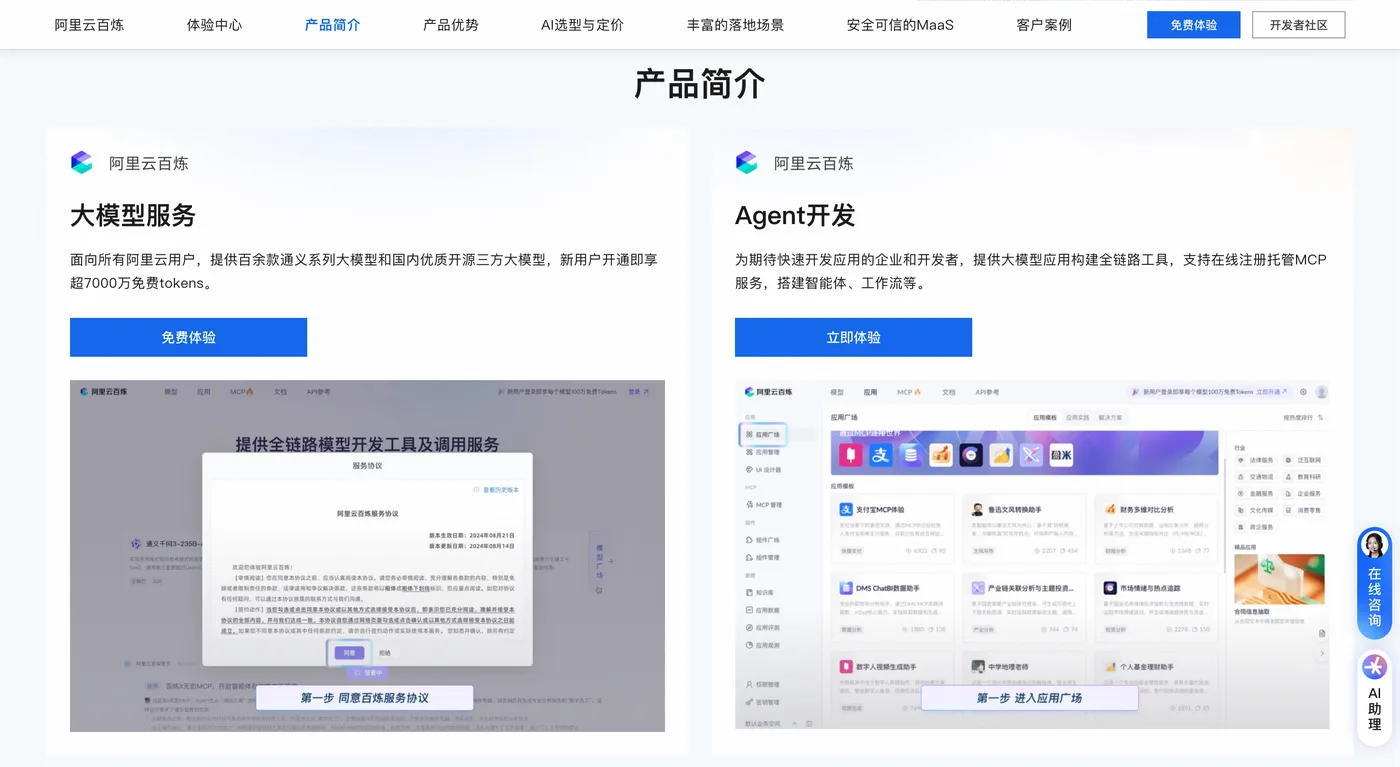
Agent能力:指模型能自主完成多步骤任务——拆解目标、选择工具、读取结果、判断是否继续、最后汇总。它依赖三项底层能力:稳定的函数调用格式、长程上下文保持、失败后的自我修正。
预览版阶段的提示:能力在迭代,同一提示词在不同时间点的产出可能不同;涉及生产变更的自动化流程,应保留人工审核与回滚开关。
二、编程能力的验证方法
不要用"写一个快速排序"这种题判断旗舰档位。有效的验证方式是拿你自己仓库里的真实任务:
第一类,跨文件改动。给一个接口签名变更需求,看它能否找出所有调用点并同步修改。
第二类,依赖理解。给一段不熟悉的模块代码,问它这段逻辑的输入输出边界与副作用。
第三类,测试生成。要求它按现有测试风格补用例,看是否覆盖边界条件。
第四类,错误定位。贴一段真实堆栈,看它能否定位到具体行并给出原因而非泛泛建议。
第五类,保持约束。在需求里加入"不许改动对外接口""必须保持返回结构",看它是否遵守。
这五类的通过率比任何跑分都更能说明问题。实测中旗舰档位在前四类的表现通常明显优于小档位,第五类则依赖提示词是否把约束写死。详情👉访问阿里云百炼大模型服务平台页面 了解。
三、Agent能力的验证方法
Agent效果的关键不在模型,而在工具描述与循环设计。验证时按这个顺序:
先测函数调用的稳定性——同样的工具描述,连续调用十次,格式是否一致。
再测多步任务——给一个需要三步才能完成的目标(查数据、算结果、写报告),看它是否按顺序执行而非跳步。
再测失败恢复——故意让某个工具返回错误,看它是重试、换路径还是直接放弃。
最后测长程一致性——任务超过十几步后,是否还记得最初的约束条件。
这三项的短板通常出现在长程一致性与失败恢复上,也是预览版最需要压测的地方。
四、1折体验的边界
详情👉访问阿里云百炼大模型服务平台页面 了解。
适用模型:通常限定在特定模型标识上,同系列其他档位不共享。
时间与额度:属限时安排,体验额度用尽或到期后回归标准价;长周期项目要按标准价做预算。
账号资格:多为新用户或首次调用该模型,实名主体限一次。
地域:调用地域有限制,跨地域不抵扣。
计费维度:输入输出Token分别计价,输出单价更高,冗长输出是成本主因。
结算:不与资源包、节省计划折扣叠加,具体以结算页为准。
结论:1折适合"验证能力",不适合"长期承载"。正确的用法是在体验期内把上面那五类编程任务与三项Agent测试全部跑完,再决定是否迁移。
五、接入命令
先用curl验证模型可用与额度扣减:
export DASHSCOPE_API_KEY="sk-xxxxxxxx"
curl [https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions](https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions) \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen4-max-preview","messages":[{"role":"user","content":"解释这段代码的副作用:def f(x): x.append(1); return x"}],"temperature":0.2}'
带工具定义,验证函数调用格式是否稳定:
curl [https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions](https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions) \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen4-max-preview",
    "messages": [{"role":"user","content":"查询订单A1001的物流状态"}],
    "tools": [{"type":"function","function":{"name":"get_order_status","description":"查询订单物流状态","parameters":{"type":"object","properties":{"order_id":{"type":"string"}},"required":["order_id"]}}}]
  }'
Python侧搭一个最小Agent循环,观察它的规划与失败恢复:
pip install openai -U
python - <<'PY'
import json
from openai import OpenAI

client = OpenAI(api_key="sk-xxxxxxxx",
                base_url="[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)")

tools = [{"type": "function", "function": {
    "name": "calc",
    "description": "计算表达式,返回数值",
    "parameters": {"type": "object",
                   "properties": {"expr": {"type": "string"}},
                   "required": ["expr"]}}}]

msgs = [{"role": "user", "content": "先算 128*37 再算 (128*37)/4,最后汇总一句话"}]

for step in range(6):
    r = client.chat.completions.create(model="qwen4-max-preview",
                                       messages=msgs, tools=tools, temperature=0.1)
    msg = r.choices[0].message
    msgs.append(msg)
    if not msg.tool_calls:
        print("最终输出:", msg.content)
        print("token用量:", r.usage)
        break
    for tc in msg.tool_calls:
        args = json.loads(tc.function.arguments)
        res = eval(args["expr"])           # 演示用途,生产环境请用安全求值
        msgs.append({"role": "tool", "tool_call_id": tc.id, "content": str(res)})
        print(f"步骤{step} 调用{args['expr']} = {res}")
PY
核对账单,确认是否走体验折扣:
aliyun bssopenapi QueryAccountBill --BillingCycle $(date +%Y-%m) --Granularity MONTH
六、实测关注点
编程能力在跨文件改动与依赖理解上提升明显,能找全调用点;短板是改动范围偶尔偏大,需要限制"只改必要行"。
Agent的函数调用格式稳定性较好,多步任务能按序执行;长程任务超过十几步后对初始约束的保持会衰减。
失败恢复依赖提示词,若未写明重试策略,模型倾向于直接放弃。
延迟高于轻量档位,交互式编码场景要接受更长的响应时间。
1折体验期内适合做完整压测,额度消耗以文件量与上下文长度为主要驱动。详情👉访问阿里云百炼大模型服务平台页面 了解。
七、避坑清单
模型标识写错会报不存在,先用模型列表核验。
1折为限时安排,长周期预算按标准价复算。
输出Token单价高于输入,冗长输出是主要成本。
体验额度与免费额度不是同一套,别混算。
预览版行为可能随版本更新变化,生产链路保留降级开关。
跨文件改动需限定改动范围,否则容易过度修改。
函数调用参数类型不明确会导致无效调用。
跨地域调用不抵扣额度。
总结
Qwen4-Max预览版的价值在"复杂任务的完成度":编程侧看能否理解既有结构并只改必要处,Agent侧看能否稳定调用工具并在失败后自恢复。1折体验是把这套能力拉进可承受成本的临时窗口,正确的用法是在窗口内把五类编程任务与三项Agent测试跑完,用真实仓库的真实需求做判断,而不是拿跑分或演示题下结论。
