
2026 年 9 月,阿里云正式推出面向下一代 AI 训练集群的新一代全栈自研存储 CPFS(Cloud Parallel File Storage)。随后,CPFS 于 9 月 30 日在北京、乌兰察布、新加坡三地正式推出商业化服务。
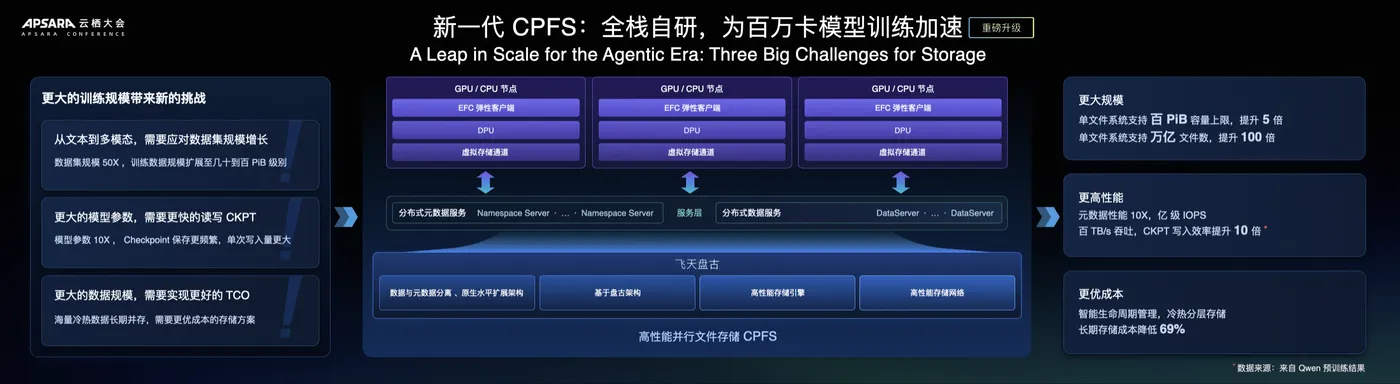
随着大模型迈入十万亿级参数规模,预训练阶段如何持续提升模型 Checkpoint 的读写性能成为大模型训练企业的核心关切。新一代全栈自研 CPFS 提供高达百 TB/s 级吞吐和亿级 IOPS,单文件系统规模提升 5 倍至 100 PiB,可支撑大规模模型训练和多模态数据处理。在实际模型训练中,可将模型启动平均耗时降低 50%、峰值算力利用率提升 30%、AI存储成本降低 69%,业务承载能力翻倍,使 GPU 从“等待数据”转向持续高效计算。
面向百万 GPU 卡训练负载,新一代 CPFS 基于飞天盘古底座和高性能存储网络,通过从后端存储到 DPU 加速通道,再到 EFC 弹性客户端全链路自研链路,形成从客户端、协议处理到数据落盘的全链路能力。
其中在数据与元数据侧,CPFS 采用数据与原数据相分离、独立 Scale-out 的分布式架构。相较于上一代 CPFS 架构,新一代 CPFS 文件系统容量规模提升 5 倍、元数据性能提升 10 倍、文件数量规模提升 100 倍,单文件系统可扩展至百 PiB 并承载万亿级文件。
弹性客户端侧,通过软硬一体优化的全链路零拷贝与 RDMA 网络,单客户端吞吐可达 40GB/s。CPFS 的 EFC 弹性客户端提供与本地文件系统一致的时延体验,最大提供单客户端 100 万 IOPS。
在成本方面,新一代 CPFS 支持按需加载 OSS 数据(Lazyload),配合元数据自动同步与智能淘汰机制,将训练数据就绪时间从小时级缩短至分钟级,冷数据常驻低成本对象存储,降低整对文章存在错误之处体存储成本。
针对冷热数据长期并存带来的成本压力,CPFS还提供智能生命周期管理和冷热分层存储,使不同访问频率的数据自动匹配合适的存储介质,在保障训练性能的同时,整体存储成本最高降低 69%。
面向大规模 AI 训练与数据治理方面,新一代 CPFS 以统一命名空间与数据洞察两大能力承接生产负载:前者聚合分散在多套文件系统中的训练数据,简化数据管理与调度,后者覆盖热点分析、容量分析与元数据投递三维度,由此,CPFS 让存储成本治理从经验驱动转向数据驱动。企业无需为不同训练阶段反复拆分或迁移数据,即可在统一文件系统中管理训练语料、模型参数、Checkpoint 和实验结果,并随 GPU 集群同步扩展容量与吞吐。以 Qwen 大模型训练为例,采用新一代 CPFS 后,模型启动平均耗时降低 50%,峰值算力利用率提升 30%,业务承载能力翻倍。
目前,新一代 CPFS 已在小鹏汽车、黑芝麻智能、爱诗科技等客户生产环境投入使用,支撑智驾模型训练、芯片研发与大规模仿真验证、多模态模型训练等业务场景。
新架构 CPFS 的商业化,标志着阿里云 AI 智算存储底座又一次完成架构级换代。未来,阿里云存储继续为 AI 而生,延续全栈自研路线,追求性能和成本的极致突破。与 AI 共长,阿里云存储持续支撑数百万家 AI 大模型公司客户跑通从数据集处理、模型训练到推理落地的全流程,为大模型训练和 AI 应用提供高性能、可扩展且成本可持续优化的存储底座。

