一、前言
大家构建过RAG应该都会遇到,多数私有知识库、合同审查、设备运维类RAG项目均存在典型问题:测试干净文档效果优异,接入扫描件、多栏排版、复合表格等真实业务文档直接失效;反复调优检索参数、优化Prompt,仍无法解决知识碎片化、关键信息丢失、答非所问、模型幻觉问题;上线后无溯源、不可校验、适配性差,很难起到预想的作用,陷入短暂的困惑。
其实这类问题的核心根源是传统RAG的流水线弊端:将所有文档统一视为纯文本字符串,忽略文档结构化属性,用固化流程处理异构业务数据,从源头造成知识失真,这些是无法逃避的现象问题,我们都一样,遇到各种奇奇怪怪的问题,总是在找合适的突破思路和解决方案,今天我们要探索的RAGFlow就是一种很好的解决思路,RAGFlow不是简单的开源RAG工具,而是重构企业级RAG应用逻辑,以“知识保真提纯”为核心,通过模板化流水线、深度文档语义解析、全链路可干预体系,系统性解决传统RAG全链路天生缺陷。
二、传统RAG核心瓶颈
回顾总结大部分的RAG项目落地失败,并非检索算法、模型参数问题,核心症结是数据处理逻辑与业务场景不匹配。传统朴素RAG与进阶RAG存在三大底层缺陷,也是RAGFlow针对性解决的核心痛点。
1. 文本扁平化导致知识失准
传统RAG无差别将所有文档扁平化转为纯文本,彻底丢失文档结构化语义,造成源头知识失真,具体问题分为两点:
- 结构语义彻底丢失:带层级的标题文档、合并单元格表格、图文关联手册、多栏论文,均被拆解为无序文本字符串。企业核心业务知识依托文档结构、数据关联、层级关系存在,扁平化处理直接破坏知识完整性。
- 脏数据与信息缺失并存:自动过滤页眉页脚、注释、图表说明等辅助关键信息,导致有效知识缺失;同时混入水印、空白冗余内容,生成大量脏数据,后续所有检索与模型优化均无实质意义。
比如我们原来有一个设备参数对照表包含多级表头、跨行合并单元格,记录设备型号、参数阈值与适用场景。传统RAG解析后表格碎片化错乱,型号与参数无法对应,即便优化检索、重排模型,仍会出现问答错乱、数据匹配错误等问题。
2. 固化分块无法适配场景差异
多数开源RAG框架仅提供固定字符分割、固定尺寸分块策略,无视文档类型与场景语义差异,核心问题如下:
- 语义强行割裂:固定分块规则无视语义边界,常在完整段落、表格、语句中间切割,导致单个知识块语义不完整,检索仅能召回碎片化信息,大模型无法整合有效内容,引发答非所问。
- 数据冗余拖累性能:短文本、短句被重复拆分入库,向量库冗余数据激增,检索噪声变大,直接降低问答准确率与接口响应速度。
即便进阶RAG新增重叠分块、自适应分块功能,仍局限于文本维度切割,无法识别文档结构、版式、层级语义边界,始终无法解决复杂文档分块失真问题,这也是企业RAG难以商用的核心卡点。
3. 黑盒链路无法落地合规场景
传统RAG全自动化黑盒运行,无人工干预入口、无流程日志、无来源绑定,仅适配简单闲聊场景,无法满足金融、法律、政务等高合规行业需求,核心痛点:
- 幻觉无法溯源定位:AI答案无法关联原始文档,出现编造、错误解读时,无法区分是解析、分块还是检索问题,排查难度极大。
- 无人工校准能力:自动化生成的脏数据、异常知识块无法可视化编辑修正,知识库异常只能整体重建,迭代成本极高。
- 业务适配性有限:线性流水线仅支持简单文本匹配问答,不支持多轮推理、多库联动、工具调用,无法承接复杂业务分析需求。
三、RAGFlow核心思想
针对传统RAG三大底层瓶颈,RAGFlow跳出“调优检索、微调Prompt”的表层优化思维,从架构底层重构RAG运行逻辑。核心设计思想可总结为三点:结构优先、场景适配、全链路可控,从根源解决RAG应用落地缺陷。
1. 拒绝文本扁平化
结构优先,RAGFlow首创结构解析前置逻辑,彻底摒弃传统“先抽文本、后处理”模式,核心优势:

- 先结构化、后提取文本:通过DeepDoc引擎提前识别标题、表格、图表、列表、注释等十余类文档元素,精准记录各元素位置、层级与关联关系。
- 保留原生语义结构:不破坏表格数据关联、图文对应关系与标题层级,入库知识自带文档原生结构语义,杜绝源头失真。
- 适配复杂异构文档:完美兼容扫描PDF、多栏论文、复合报表、图文混排手册等企业复杂文档,将非结构化数据转化为标准化可检索知识单元。
2. 模板化流水线定制
高自由度的场景适配,模板化流水线是RAGFlow核心工程优势,区别于通用固定流水线,实现“一场景一适配”,核心能力:
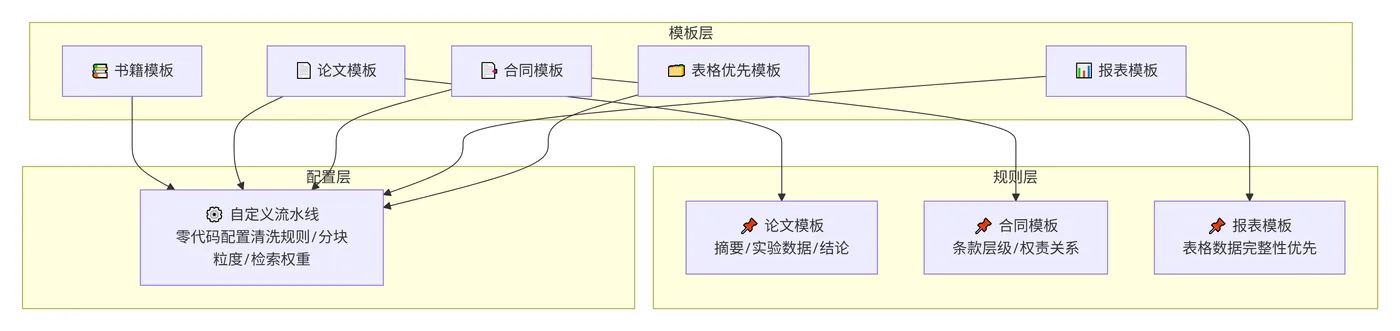
- 预置行业专属模板:内置书籍、论文、合同、报表、表格优先等模板,每套模板配备独立处理规则。
- 差异化场景适配:论文模板聚焦摘要、实验数据与结论;合同模板保留条款层级与权责关系;报表模板优先保障表格数据完整性。
- 支持自定义流水线:用户可零代码配置清洗规则、分块粒度、检索权重,适配企业专属文档格式,无需底层二次开发。
3. 可视化知识干预
全链路可控,针对传统RAG黑盒不可控、不合规痛点,RAGFlow搭建全链路可视化可干预体系,实现全程可观测、可校准、可溯源:
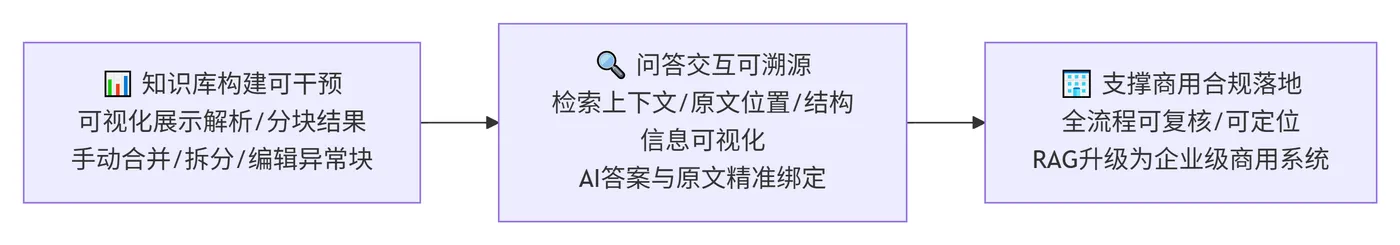
- 知识库构建可干预:可视化展示文档解析、分块结果,支持手动合并、拆分、编辑异常知识块,修正自动化误差。
- 问答交互可溯源:检索上下文、原始文档位置、结构信息全程可视化,AI答案与原文精准绑定,杜绝无依据输出。
- 支撑商用合规落地:全流程可复核、可定位,彻底将RAG从Demo工具升级为企业级商用系统。
四、RAGFlow流水线机制
RAGFlow核心竞争力:场景化Ingestion流水线,从加工流程、模板规则、检索机制三方面,解析其差异化落地逻辑。
1. 分层式知识加工流程
RAGFlow摒弃传统单层粗糙加工模式,独特的四层分层知识提纯流水线,层层降噪提纯,保障入库知识高质量:
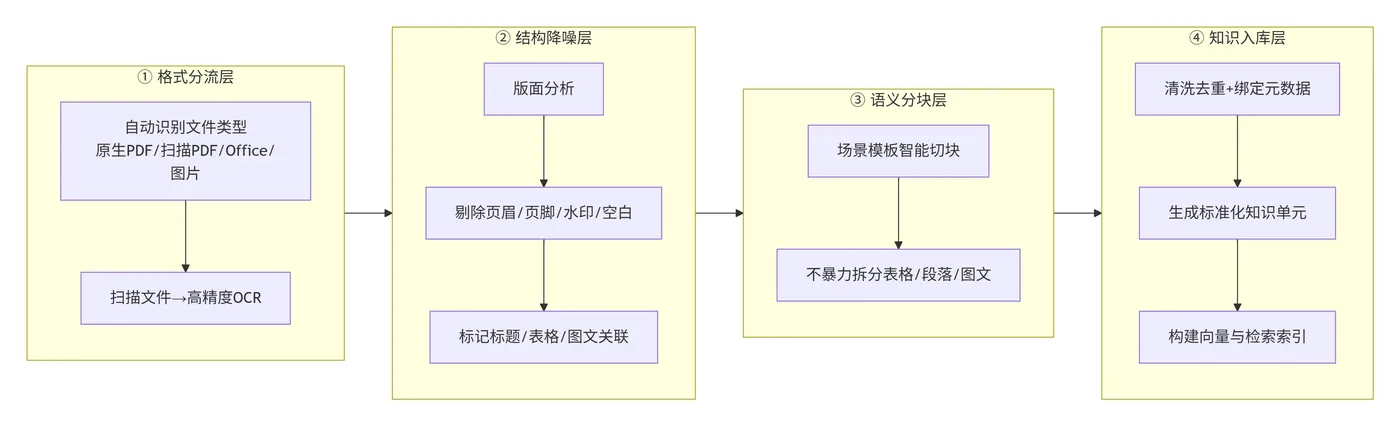
- 格式分流层:自动识别原生PDF、扫描PDF、Office文档、图片等文件类型,分流至专属处理分支,扫描文件自动启动高精度OCR识别。
- 结构降噪层:完成版面分析,自动剔除页眉、页脚、水印、空白重复内容,标记标题、表格、图文关联关系,留存有效结构化信息。
- 语义分块层:依托场景模板,基于文档语义与结构层级智能切块,不暴力拆分表格、完整段落与图文组合内容,保障语义完整。
- 知识入库层:对分块内容清洗去重、绑定元数据,生成带结构、位置信息的标准化知识单元,构建向量与检索索引。
上传含复杂合并表格的财务年报,传统RAG会碎片化拆分表格、混入冗余噪声,导致数据错乱;RAGFlow四层流水线可精准过滤无效内容、保留表格层级与营收、成本、利润对应关系,生成完整语义知识块,支撑精准财务问答。
2. 模板适配核心规则
RAGFlow场景模板并非简单参数预设,而是覆盖四大维度的完整场景适配规则体系:
- 结构识别规则:合同模板聚焦条款、权责、违约信息;论文模板聚焦摘要、实验数据、研究结论;设备手册聚焦故障场景、操作步骤、参数标准。
- 分块逻辑规则:表格优先模板保障整表不拆分,超大表格自动绑定表头关联;书籍模板依托标题层级分层切块,兼顾语义完整与检索灵活。
- 清洗策略规则:学术模板过滤参考文献、致谢;企业文档过滤版本日志、修订记录;报表模板完整留存全部数值数据。
- 检索权重规则:差异化配置权重,报表提升表格结构化内容权重,运维手册提升步骤文本权重,合同提升条款权重,贴合提问场景。
3. 智能加权融合检索机制
传统混合检索仅简单拼接结果,存在冗余、优先级混乱问题。RAGFlow独特智能加权融合检索,动态适配提问场景,大幅提升精准度:
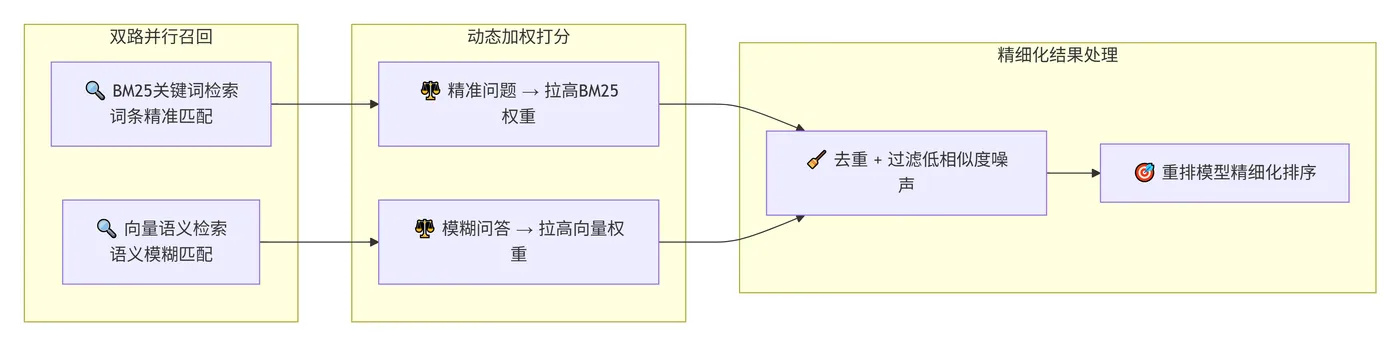
- 双路并行召回:同步启动BM25关键词检索与向量语义检索,兼顾词条精准匹配与语义模糊匹配能力。
- 动态加权打分:参数、词条类精准问题拉高BM25权重;语义咨询、模糊问答拉高向量检索权重,智能适配场景。
- 精细化结果处理:自动去重、过滤低相似度噪声,通过重排模型精细化排序,输出高匹配、无冗余上下文。
五、RAGFlow溯源保真原理
可溯源、可保真、可合规是RAGFlow区别于普通开源RAG的核心壁垒:
1. 全维度元数据绑定机制
元数据绑定是溯源能力的底层核心,RAGFlow在解析、分块全流程,为每个知识单元绑定永久关联的结构化元数据,具体包含五类信息:
- 基础文档信息:文档名称、上传时间、格式、大小,精准定位知识来源。
- 位置信息:页码、页面坐标、段落序号,支持原文精准高亮溯源。
- 结构信息:标题层级、区块类型、图文/表格关联ID,保留原生结构关系。
- 处理信息:解析模板、分块规则、处理时间,支撑问题复盘追溯。
- 检索信息:向量特征、匹配权重,为检索排序与加权提供数据支撑。
2. 双向关联校验保真机制
RAGFlow独创双向校验机制,区别于普通RAG简单的来源标注,从源头遏制幻觉、保障答案准确:
- 上下文约束校验:强制大模型仅依托绑定元数据的参考内容作答,禁止调用模型通识知识库,杜绝凭空编造。
- 内容一致性校验:自动对比AI答案与原始知识块的语义、数据、逻辑,精准识别夸大、篡改、编造内容,标记风险信息。
该机制可完美适配金融数据、法律条款、设备参数等高精准场景,有效规避数据偏差、条款曲解问题,满足行业合规审核标准。
3. 多行业合规实践价值
全链路溯源保真体系适配各类高合规场景,落地价值明确:
- 政务档案:问答逐句溯源,公开咨询内容有据可查、合规可审。
- 法律合同:核对AI解读与原始合同一致性,规避法律解读偏差与业务风险。
- 制造运维:校验操作指引与官方手册匹配度,避免错误操作引发安全事故。
- 全流程合规留存:处理日志、问答与溯源记录全程留存,支持批量导出,满足审计监管需求。
六、RAGFlow智能体构建
RAGFlow内置可视化专属智能体引擎,深度适配知识检索场景,区别于通用Agent框架,具备极强的应用实践优势。
1. 专属RAG工作流编排
RAGFlow摒弃通用Agent无差别编排模式,打造知识检索专属工作流,简单轻松即可搭建复杂业务智能体:
- 深度联动知识库:支持多知识库联动检索、多维度知识汇总、结构化报告自动生成,形成完整业务闭环。
- 适配复杂业务场景:可实现财报分析、合同批量审查、设备故障诊断、档案批量研判等多步骤复杂业务。
- 多元工具集成:内置计算器、代码沙箱、联网搜索、API调用能力,实现知识检索+数据运算+外部信息补充的复合能力,解决传统RAG推理短板。
2. 长期记忆迭代机制
区别于普通Agent短期会话记忆,RAGFlow支持用户级长期记忆,持续优化适配性:
- 个性化记忆留存:自动留存用户使用习惯、业务偏好、高频问题,针对不同岗位自适应回答风格与侧重点。
- 可人工干预优化:支持手动清洗无效记忆、调整权重,平衡个性化适配与问答专业性,避免冗余干扰。
3. MCP协议生态拓展
RAGFlow原生支持MCP协议,可无限拓展智能体能力边界:
- 对接外部生态:无缝适配各类AI服务、第三方工具与业务系统,突破单一知识库能力局限。
- 打通企业业务链路:可联动OA、CRM、运维系统,实现业务数据与知识问答融合,快速搭建企业AI办公助手。
七、RAGFlow应用实践
基于实践项目实战经验,总结了RAGFlow一些曾经的踩坑点、优化方案与生产环境适配技巧,规避常规落地失误。
1. 知识库构建原则
- Embedding模型锁定原则:数据集创建后向量空间固定,禁止更换Embedding模型,否则会导致向量维度、语义空间不匹配,检索完全失效。落地前需确定生产级模型,全程统一。
- 模板与文档强匹配原则:专业文档必须使用专属模板,通用模板会导致表格丢失、章节错乱、知识碎片化。建议按文档类型拆分数据集,同类文档搭配专属模板处理。
- 超大文件处理建议:50MB以上扫描PDF、高清图纸易出现OCR超时、解析失败。需提前拆分文件、压缩无效分辨率,分批上传并开启失败任务重试。
2. 问答效果专属优化
- Chunk人工校准:自动化分块无法适配极致精准场景,核心业务文档需手动合并碎片化知识块、修正语义断裂问题,大幅提升检索精准度。
- 动态阈值适配:参数、条款等精准场景调高相似度阈值,杜绝无效匹配;方案、流程咨询等模糊场景调低阈值,兼顾召回率与完整性。
- 溯源式Prompt约束:定制专属Prompt,强制模型标注来源、无信息时如实反馈,杜绝强行作答,降低商用幻觉风险。
3. 生产环境性能优化
- 资源隔离防阻塞:大批量文档导入时,合理配置Worker并发数,拆分任务队列,将解析任务与线上问答服务资源隔离,避免业务卡顿。
- 高频场景缓存优化:开启高频问答缓存,留存高频问题与上下文,提升响应速度、降低模型调用成本。
- 定期知识库运维:定时清理无效文档、冗余知识块、过期数据,精简向量索引,持续优化检索效率。
八、应用场景适配分析
结合RAGFlow核心能力,精准划分高适配与低适配场景,明确选型边界,规避资源浪费。
1. 核心高适配场景
- 复杂版式文档知识库:适配扫描件、多栏排版、复合表格、图文混排文档,依托DeepDoc结构解析能力,效果远超通用RAG。典型场景:设备手册、财务年报、学术文献、政务档案。
- 高合规行业场景:适配需溯源、可校验、可审计的合规刚需场景,满足监管要求。典型场景:合同审查、政务咨询、医疗文档解读、审计资料问答。
- 低代码快速落地场景:无专职AI研发团队的企业,可依托模板化流水线、可视化操作,零代码快速搭建私有化知识库系统。
2. 低适配不适场景
- 海量爬虫网页检索场景:RAGFlow优势为结构化复杂文档提纯,针对碎片化低质网页,检索效率与性价比不及专用搜索引擎。
- 极致轻量化边缘场景:完整架构资源占用较高,不适用于低配置服务器、边缘设备轻量化部署。
- 底层高度自定义研发场景:需从零改造RAG底层算法、定制核心逻辑的研发场景,代码级框架灵活性更高,RAGFlow更适配工程化快速落地。
九、完整应用实践示例
基于RAGFlow官方OpenAI兼容接口,实现“数据集创建、文档上传、知识库解析、智能检索、问答调用、溯源校验”全链路自动化,适配私有化部署环境,可快速落地企业设备运维、文档问答基础场景。
实现企业设备运维知识库需求:通过代码自动化构建专属知识库、上传运维手册、调用RAGFlow智能加权检索与溯源能力,实现无幻觉、可溯源的设备参数查询、故障排查问答。
1. 环境前置依赖
- 已部署RAGFlow私有化服务,本地/内网接口可正常访问;
- 安装依赖库:pip install openai python-dotenv;
- 在RAGFlow后台创建API Key,开启知识库检索、溯源权限;
- 固定全局Embedding模型与大模型,避免向量空间不匹配。
2. .env 环境配置文件
在项目根目录新建 .env文件,以下为完整适配上述代码的配置,涵盖私有化部署核心参数,填写自己的密钥与服务地址即可直接运行,参数与代码完全对应:
# RAGFlow 私有化部署接口地址(默认本地端口8000,内网部署请修改为实际IP)
RAGFLOW_BASE_URL=http://localhost:8000/v1
# RAGFlow 后台生成的 API Key
# 获取路径:RAGFlow后台 - 个人中心 - API密钥管理 - 新建密钥(开启知识库、溯源权限)
RAGFLOW_API_KEY=your-ragflow-api-key-here
# 可选:超时时间配置,适配大文档解析、长文本问答
RAGFLOW_TIMEOUT=300
# 可选:代理配置,内网无代理可直接注释
# HTTP_PROXY=http://127.0.0.1:7890
# HTTPS_PROXY=http://127.0.0.1:7890

3. 完整代码示例
以下代码一次性实现:环境配置、数据集初始化、文档批量上传、知识库异步解析、智能加权检索、问答生成、溯源信息提取、结果合规校验全流程。
import os
import time
from dotenv import load_dotenv
from openai import OpenAI
# 加载环境配置(私有化RAGFlow服务地址与密钥)
load_dotenv()
# 初始化RAGFlow客户端(兼容OpenAI接口)
client = OpenAI(
    api_key=os.getenv("RAGFLOW_API_KEY"),
    base_url=os.getenv("RAGFLOW_BASE_URL"),  # 私有化地址:http://localhost:8000/v1
)
# ===================== 1. 基础全局配置(按需修改)=====================
DATASET_NAME = "企业设备运维知识库"
# 选用RAGFlow专属文档处理模板:表格优先+结构解析
TEMPLATE_TYPE = "table_first"
# 问答约束Prompt(杜绝幻觉、强制溯源、无信息如实回复)
SYSTEM_PROMPT = """
你是企业专属设备运维智能助手,严格遵循以下规则作答:
1. 仅基于知识库检索到的原文内容回答,禁止模型通识脑补编造;
2. 回答设备参数、故障步骤时精准还原原文数据,不夸大、不删减;
3. 答案末尾必须附带原文溯源信息(文档名称、页码、段落位置);
4. 若知识库无对应内容,直接回复「暂无相关运维资料」,禁止强行作答。
"""
# ===================== 2. 创建专属数据集 =====================
def create_rag_dataset():
    """创建设备运维专属数据集,绑定固定处理模板"""
    dataset = client.datasets.create(
        name=DATASET_NAME,
        description="用于存储企业设备运维手册、故障排查文档、参数说明书",
        template=TEMPLATE_TYPE,
        # 开启结构降噪、表格完整保留、语义智能分块
        extra_config={
            "clean_watermark": True,
            "keep_table_full": True,
            "semantic_chunk": True
        }
    )
    print(f"数据集创建成功,ID:{dataset.id}")
    return dataset.id
# ===================== 3. 批量上传本地运维文档 =====================
def upload_rag_files(dataset_id, file_folder="./device_docs"):
    """批量上传PDF运维文档,支持原生PDF与扫描PDF"""
    file_list = []
    # 遍历本地文档文件夹
    for file_name in os.listdir(file_folder):
        if file_name.endswith((".pdf")):
            file_path = os.path.join(file_folder, file_name)
            file_list.append(file_path)

    # 批量上传文件至数据集
    files = []
    for path in file_list:
        f = client.files.create(file=open(path, "rb"), purpose="rag")
        files.append(f.id)

    # 绑定文件至数据集并启动自动解析
    client.datasets.files.bind(dataset_id=dataset_id, file_ids=files)
    print(f"成功上传并绑定{len(files)}份运维文档,开始自动解析...")
    return files
# ===================== 4. 等待知识库解析完成 =====================
def wait_dataset_parse(dataset_id, timeout=300):
    """阻塞等待文档结构解析、分块、向量化、索引构建完成"""
    start_time = time.time()
    while time.time() - start_time < timeout:
        status = client.datasets.retrieve(dataset_id=dataset_id).status
        if status == "completed":
            print("知识库解析、向量化、索引构建全部完成!")
            return True
        elif status == "failed":
            print("知识库解析失败,请检查文档格式与文件大小!")
            return False
        time.sleep(5)
    print("解析超时,请排查服务状态!")
    return False
# ===================== 5. 智能加权检索+问答生成 =====================
def rag_flow_qa(dataset_id, user_query):
    """
    核心问答函数:
    1. 自动双路召回(BM25+向量检索)
    2. 场景动态加权适配
    3. 溯源信息绑定与合规校验
    """
    response = client.chat.completions.create(
        model="ragflow",  # RAGFlow专属融合模型
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": user_query}
        ],
        # 绑定指定知识库,限定检索范围
        extra_body={
            "dataset_ids": [dataset_id],
            # 精准场景加权配置:参数查询强化BM25,流程查询强化向量
            "retrieve_weight": {
                "bm25_weight": 0.7 if "参数" in user_query else 0.3,
                "vector_weight": 0.3 if "参数" in user_query else 0.7
            },
            "enable_rerank": True,       # 开启重排精细化排序
            "enable_trace": True,        # 开启全链路溯源
            "filter_noise": True         # 过滤低相似度噪声
        },
        temperature=0.1,  # 低温度杜绝随机编造,保障精准度
    )
    return response
# ===================== 主程序:一键完整落地 =====================
if __name__ == "__main__":
    # 1. 创建数据集
    ds_id = create_rag_dataset()
    # 2. 上传文档
    upload_rag_files(ds_id)
    # 3. 等待解析完成
    if wait_dataset_parse(ds_id):
        # 4. 模拟业务问答测试
        res1 = rag_flow_qa(ds_id, "XX设备额定工作温度与报警阈值是多少")
        res2 = rag_flow_qa(ds_id, "XX设备开机报错如何排查")
        print("【参数查询结果】\n", res1.choices[0].message.content)
        print("【故障排查结果】\n", res2.choices[0].message.content)

4. 运行流程说明
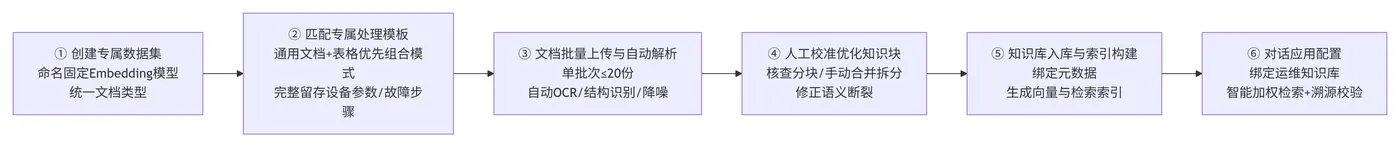
步骤1:创建专属数据集:新建数据集并命名为“设备运维知识库”,固定所选Embedding模型,后续全程不替换;数据集仅存放设备运维类文档,保证文档类型统一,适配专属流水线模板。
步骤2:匹配专属处理模板:流水线模板选择“通用文档+表格优先组合模式”,开启结构降噪、表格完整保留规则;清洗规则关闭参考文献、冗余内容过滤,完整留存设备参数、故障步骤、操作规范核心信息。
步骤3:文档批量上传与自动解析:单批次上传20份以内运维手册,系统自动分流解析,扫描PDF自动启动高精度OCR,原生PDF完成结构识别;自动过滤页眉页脚、水印、空白冗余内容,保留标题层级、图文对应关系与完整表格数据。
步骤4:人工校准优化知识块:解析完成后进入可视化编辑页面,核查自动分块结果;手动合并碎片化的故障步骤、参数表格内容,拆分语义冗余的长文本,修正语义断裂问题,保障每个知识块均为完整业务语义单元。
步骤5:知识库入库与索引构建:校准完成后一键入库,系统自动绑定全维度元数据,生成向量索引与检索索引,完成知识库搭建,全程无需代码开发。
步骤6:对话应用配置:新建对话应用,绑定“设备运维知识库”;开启智能加权融合检索,参数类问题拉高BM25权重,流程咨询类问题拉高向量检索权重;开启答案溯源、内容一致性校验功能,配置专属Prompt,强制模型仅依托知识库内容作答、标注来源、无信息时如实反馈。
4. 代码运行结果验证
代码运行后自动完成知识库全流程构建,问答输出效果具备三大核心特征,完美契合RAGFlow能力:
- 数据零误差:设备额定温度、报警阈值等结构化参数,完全匹配手册表格原文,无篡改、无偏差;
- 流程完整性:故障排查步骤完整输出,无语义断裂、步骤缺失,解决传统RAG碎片化问题;
- 可合规溯源:返回结果自动附带文档名称、页码、区块位置元数据,支持人工复核校验,满足审计要求。
十、总结
RAGFlow的核心竞争力,并非通用的模型调用、检索算法能力,而是针对性解决工业级RAG落地的各类工程痛点。RAGFlow从文档结构解析、知识精细化提纯、全链路流程可控、合规保真四大维度,补齐了传统RAG的天生短板。以模板化流水线解决场景适配难题,以结构优先逻辑解决知识失真难题,以可视化干预解决黑盒不可控难题,以溯源校验体系解决合规难题。
总的来说,做了一些项目的自我总结,知识质量是优于算法优化的。未来企业级RAG的落地趋势,将从简单问答工具,升级为企业结构化知识治理的核心基础设施,结合智能体能力,实现从被动问答到主动分析、智能研判、自动产出的全面进阶。