引言
通用 CRM 系统(Salesforce、Zoho、销售易等)做的是"通用销售流程"——线索、客户、机会、合同、商机。这类系统的架构基础是 B2B 大客户销售模型,特点是单笔金额大、销售周期长、客户数量少(一个销售管几十个客户已经算多)。
但放到烟酒茶、奢侈品、母婴连锁这些行业,通用模型就完全对不上。原因很简单:
- 客户数量级不同:连锁门店一个店几千上万个会员,整个连锁可能是几十万会员
- 销售模式不同:零售为主,客户是 C 端,不是 B 端
- 跟进周期不同:B2B 是几个月到一年,零售客户是常年复购
- 营销场景不同:B2B 是销售个人跟进,零售是节日营销 + 会员运营
这些差异决定了,通用 CRM 系统在这些行业的渗透率很低。门店和连锁企业要么硬着头皮把通用 CRM 改造(改造成本极高),要么用 Excel + 会员系统勉强撑着,要么干脆不管理会员。
本文从技术架构的角度,拆解面向连锁行业的 CRM 系统在画像引擎、全生命周期跟踪、节日预测等方面和通用 CRM 有什么不一样。
通用 CRM 的画像模型:客户 + 商机 + 阶段
通用 CRM 的画像核心是"客户档案 + 商机阶段"。技术栈大致是:
- 客户表:客户基本信息(姓名、公司、职位、联系方式)
- 联系人表:客户关联的联系人
- 商机表:销售机会(金额、阶段、预计成交日期)
- 活动表:跟进记录(邮件、电话、会议)
- 阶段流转:线索 → 商机 → 方案 → 合同 → 回款
这个模型的关注点是"销售个人怎么跟进每个商机",核心指标是"销售个人的人效"(一个销售一年成交多少客户、金额多少)。
面向连锁行业的 CRM 画像引擎
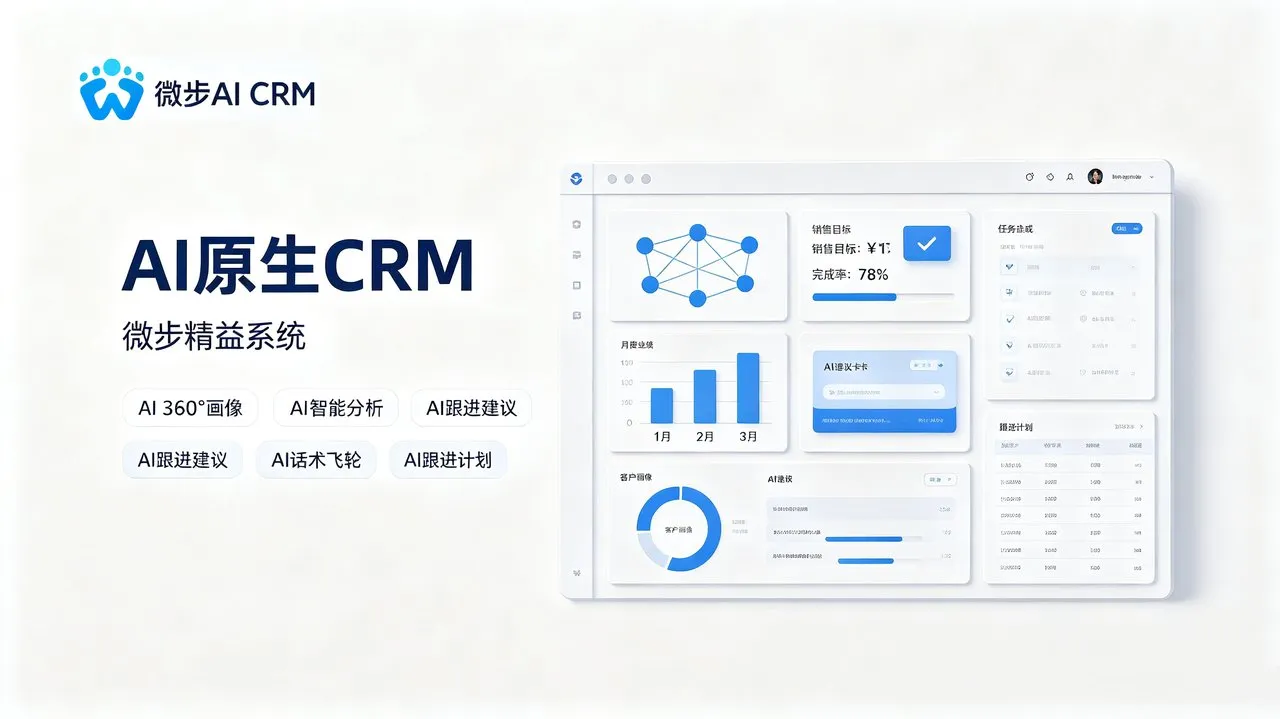
面向连锁行业的 CRM,画像核心是"会员画像 + 生命周期 + 复购预测"。技术栈完全不同:
- 会员档案:消费记录、品类偏好、价格带、到店频次、客单价
- 生命周期阶段:潜客 → 新客 → 熟客 → 老客 → 沉睡客 → 流失客
- 360 画像标签:消费习惯、品类偏好、价格敏感度、节日购买倾向
- 预测模型:复购预测、流失预测、节日采购需求预测
这个模型的关注点是"怎么让每一个会员买得更多、买得更频、买得更久",核心指标是"会员 LTV(生命周期价值)+ 复购率 + 流失率"。
下面拆解几个关键模块的技术实现。
一、三六零画像:会员的多维度标签体系
通用 CRM 的客户画像维度比较粗——基本信息 + 跟进记录 + 商机阶段。连锁行业的会员画像维度非常细。一个烟酒茶连锁的会员画像大概包含 100+ 个维度:
基础属性
- 会员基本信息(年龄、性别、职业、居住地)
- 注册信息(注册渠道、注册时间、首次消费时间)
- 客户分层等级(潜客 / 新客 / 熟客 / 老客 / 沉睡)
消费行为
- 消费频次(月均消费次数、最近 30 / 90 天消费次数)
- 客单价(历史平均、最近一年平均)
- 品类偏好(白酒 / 红酒 / 茶叶 / 礼盒 / 日配的占比)
- 价格带偏好(每次购买的价位分布)
购买场景
- 节日购买(春节 / 中秋 / 端午 / 520 / 情人节 购买次数和金额)
- 自购 / 送礼占比
- 旺季 / 淡季分布
响应行为
- 营销活动响应(优惠券使用率、活动参与率)
- 沟通偏好(短信 / 微信 / 电话)
- 退换货记录
技术上,这套画像标签不是手工录入,而是通过消费事件 + 行为事件 + 营销事件自动计算后写入。技术实现是事件驱动的标签更新:
消费事件触发 → 计算用户消费标签 → 更新标签表 → 触发下游业务(推荐、营销、跟进)
标签存储在专门的用户标签表(user_tags),每行是一个 (user_id, tag_key, tag_value, update_time) 四元组。查询时通过 user_id 检索,支持 O(1) 的标签查询。

二、全生命周期跟踪:六阶段模型
通用 CRM 的生命周期是"线索 → 客户 → 商机 → 合同",单链条、单向流转。连锁行业的会员生命周期是六阶段循环模型:
| 阶段 | 定义 | 关键指标 | 跟进策略 |
|---|---|---|---|
| 潜客 | 注册未购买 | 潜在购买力 | 拉新活动、新客礼包 |
| 新客 | 首次购买 ≤ 90 天 | 转化率、首次客单价 | 引导二购、产品体验 |
| 熟客 | 购买 ≥ 3 次 | 复购率、月活 | 节日营销、品类拓展 |
| 老客 | 购买 ≥ 10 次或累计金额达标 | 客单价提升、转介绍 | 会员升级、VIP 权益 |
| 沉睡客 | 90-180 天未购买 | 唤醒率 | 唤醒活动、问卷调研 |
| 流失客 | > 180 天未购买 | 挽回率、流失原因 | 召回、原因分析 |
六阶段是循环流转的——流失客挽回后又进入新客或熟客,不是单向漏斗。这个循环模型比通用 CRM 的单向漏斗更适合零售场景。
技术上,每个会员记录一个 lifecycle_stage 字段,定义在会员主表上。每次消费行为或时间周期触发时,系统自动判断阶段是否需要流转。判断逻辑:
if (consumption_count >= 10 or total_amount >= VIP_THRESHOLD)  → 老客
else if (consumption_count >= 3)                               → 熟客
else if (consumption_count >= 1 and days_since_first <= 90)    → 新客
else if (days_since_last_purchase between 90 and 180)          → 沉睡客
else if (days_since_last_purchase > 180)                       → 流失客
else                                                           → 潜客
阶段流转触发对应的跟进策略(营销活动、客服任务、唤醒计划等)。
三、复购预测与流失预测:基于消费序列的模型
通用 CRM 不做预测,因为 B2B 大客户销售周期长、不确定性大。连锁行业的会员复购和流失是高频事件,需要预测模型驱动营销决策。
复购预测
复购预测的输入是会员的历史消费序列(消费时间、品类、金额、节日属性)。技术上用的是 GBDT(Gradient Boosting Decision Tree) 或者更简单的逻辑回归。
特征工程:
- RFM 特征(最近一次消费距今、消费频次、消费金额)
- 品类分布特征(高频品类、品类多样性)
- 节日消费特征(节日占比、春节消费金额)
- 客单价趋势(近 3 次客单价 vs 历史均值)
预测目标: 未来 30 / 60 / 90 天内是否会发生复购,以及预测复购金额区间。
输出: 复购概率(0-1)+ 复购金额预测 + 复购品类预测。
这三个输出一起,支撑运营人员做精准营销——给谁发券、发多少面额的券、推什么品类的券。
流失预测
流失预测比复购预测更常用,因为流失客的挽回成本远低于拉新成本。流失预测的输入是会员的近期行为衰减信号:
- 最近 N 天消费频次下降
- 客单价下降趋势
- 营销活动响应率下降
- 沟通频次下降
技术上同样用 GBDT,目标是预测"未来 30 天内流失概率 ≥ 阈值"的高流失风险会员。输出概率和风险等级,触发对应的唤醒任务(客服主动触达、专属优惠券、生日关怀等)。
四、节日采购需求预测:节令驱动的智能备货
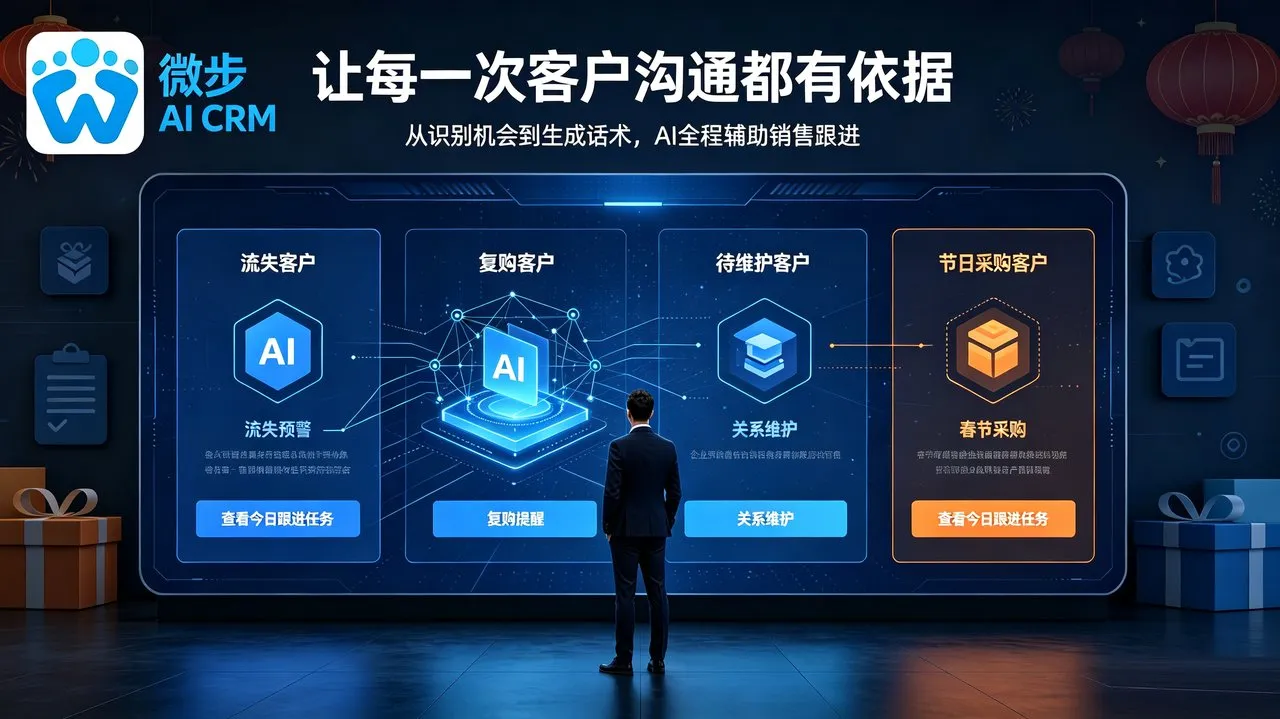
这是烟酒茶连锁行业非常特殊的一个需求——节令消费占比极高。春节、中秋、端午三大节令消费可能占全年销售额的 40%-60%。备货不当,要么缺货损失销售,要么积压损失资金。
节日采购需求预测的技术实现分三层:
第一层:宏观预测(连锁整体)
输入是历史节日的销售数据(近 3 年春节 / 中秋的销售数据),结合今年的会员规模和会员结构变化,预测今年的节日总销售额。技术上用的是时间序列预测(Prophet 或 ARIMA),考虑:
- 周期因素:春节在 2 月初还是 2 月末,对销售节奏影响很大
- 趋势因素:会员总数增长、品类结构变化
- 异常因素:疫情、政策影响
第二层:单品预测(具体 SKU)
输入是单品的历史销售数据 + 今年的会员画像变化,预测每个 SKU 的节日销售数量。这个层级的粒度更细,要做到:
- 每个 SKU 的节日销量预测
- 每个 SKU 的备货建议(含安全库存)
- 缺货风险预警
技术上用单品的时间序列模型 + 相似单品聚类(新 SKU 没有历史数据时,参考相似单品的曲线)。
第三层:会员级预测(给每个会员的推送)
节日采购需求预测到会员级别才有营销价值。系统会根据会员画像,预测每个会员"这个春节可能会买什么、买多少",然后在节日前做精准推送。
比如一个会员画像显示:
- 春节期间购买占比 60%(高)
- 历史春节偏好白酒 + 礼盒
- 客单价 5000+
- 价格带偏好 1000-2000 元
系统在节日前 30 天会推送:
- 1000-2000 元白酒礼盒的新品
- 春节专享券
- 预购提醒
这个会员级预测的输出直接对接营销系统(发券、推送、电话),形成"预测 → 执行 → 验证 → 反哺"的闭环。
通用 CRM vs 连锁行业 CRM:架构对比
| 维度 | 通用 CRM | 连锁行业 CRM |
|---|---|---|
| 客户量级 | 千级(销售管几十个客户) | 万-百万级(连锁管几十万会员) |
| 数据核心 | 客户档案 + 商机 | 会员档案 + 消费记录 + 360 画像 |
| 生命周期 | 单向漏斗(B2B 销售链路) | 六阶段循环(零售会员) |
| 画像维度 | 粗(基本属性 + 跟进) | 细(100+ 标签) |
| 预测模型 | 无(不需要) | 复购预测、流失预测、节日预测 |
| 营销场景 | 销售个人跟进 | 节日营销、会员运营、唤醒召回 |
| 客户分类 | 按行业 / 规模 | 按生命周期阶段 + 消费特征 |
| 销售链路 | 销售驱动 | 数据驱动(自动化触发) |
| 实施周期 | 1-3 月 | 1-2 周(垂直行业 SaaS) |
| 收费模式 | 按账号 / 年 | 按门店 + 会员数 |
技术栈选型建议
如果要从零搭建一个面向连锁行业的 CRM 画像引擎,几个关键技术选型:
- 存储层:用户主表用关系型数据库(PostgreSQL / MySQL),标签表用宽表或图数据库。消费事件量大时,用 ClickHouse 做 OLAP 分析。
- 计算层:标签计算用 Flink 或 Spark Streaming 做实时计算,特征工程离线用 Airflow 调度。预测模型用 scikit-learn 或 XGBoost,节日预测用 Prophet。
- 服务层:画像查询用 Redis 缓存(用户 ID → 标签集合),API 网关统一对外。
- 应用层:对接营销自动化、客服系统、POS、ERP、会员小程序等。
结语
做连锁行业的 CRM,技术上的核心难点不在 CRUD,而在画像计算 + 预测模型 + 节令业务理解。通用 CRM 管的是"销售流程",连锁行业 CRM 管的是"会员关系"。
从行业上看,烟酒茶、奢侈品、母婴连锁这些行业有几个共同点:
- 客户数量级大(百万级会员)
- 消费频次高但单次金额不一定高
- 节令消费占比高(春节、中秋等)
- 客户全生命周期价值远高于 B2B 单笔合同
- 复购率和流失率的微小变化对营收影响巨大
这些特点决定了,通用 CRM 的"销售个人跟进商机"模型在这些行业里基本失效。真正能跑通的,是基于会员画像 + 预测模型 + 节日营销的数据驱动 CRM 系统。
延伸阅读
- scikit-learn: Gradient Boosting Classification
- Facebook Prophet: Forecasting at scale
- Wikipedia: Customer relationship management