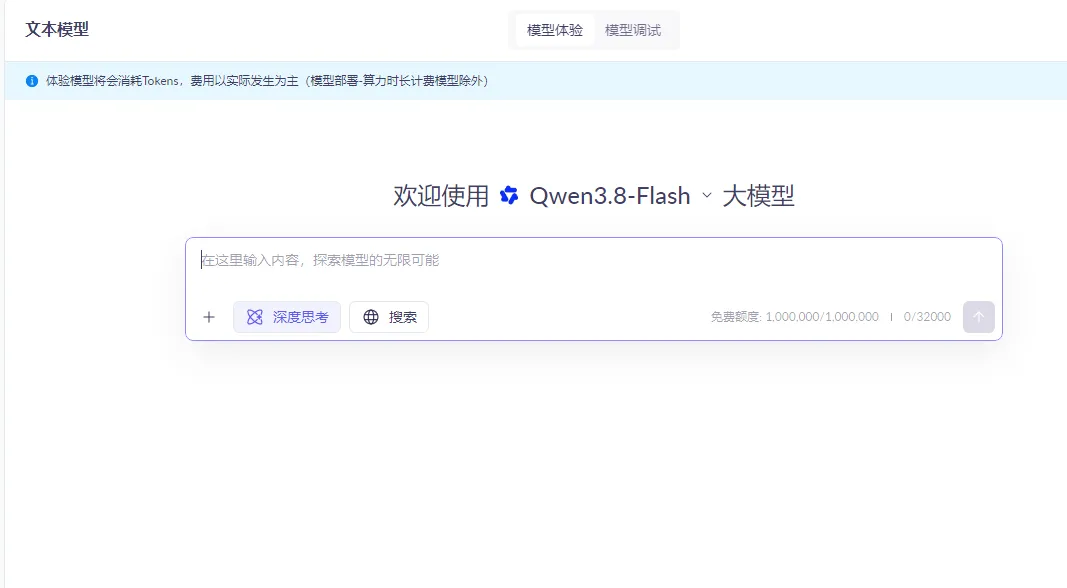
Qwen3.8-Flash 是通义千问最新推出的多模态大模型,兼具强大的理解与生成能力和出色的响应速度。模型原生支持百万级上下文窗口,能够一次性处理超长文档、代码仓库和复杂对话。在编程辅助、智能体协作、图文理解等场景中表现尤为出色——无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确、高质量的结果。同时兼容 OpenAI 与 Anthropic 主流接口协议,可无缝接入 Claude Code、Codex 等开发者工具,轻松构建高并发应用与智能工作流。凭借优异的性能与极具竞争力的推理成本,Qwen3.8-Flash 是开发者和企业在 AI 应用中兼顾效果与效率的理想选择。作为一款采用多模态混合专家(MOE)架构的高效模型,Qwen3.8-Flash 在保持旗舰级理解力的同时,以极低的时延与成本服务于高并发生产场景,真正实现了"鱼与熊掌兼得"的工程平衡。
一、阿里云Qwen3.8-Flash模型概述
Qwen3.8-Flash 是千问系列最新推出的多模态大模型,兼具强大的理解与生成能力和出色的响应速度,是面向开发者与企业级应用场景打造的"效果与效率兼得"的理想选择。该模型原生支持百万级上下文窗口,能够一次性处理超长文档、代码仓库和复杂对话,彻底打破了传统模型在处理长文本时的容量瓶颈。过去,开发者面对数十万字的招投标文件、上万行代码的工程仓库或跨越数周的会议记录时,往往只能分段截断、分批摘要,信息在切割中不断损耗;而 Qwen3.8-Flash 的百万级上下文窗口让"全文载入、全局理解"成为常态,模型可以在完整的语境中检索细节、把握脉络、给出结论。
在实际应用场景中,Qwen3.8-Flash 的表现尤为全面:在编程辅助、智能体协作、图文理解等场景中表现尤为出色——无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确、高质量的结果。在编程辅助方面,模型不仅能补全函数、解释报错,更能理解跨文件的依赖关系,定位缺陷根因并给出可直接合入的修复补丁;在智能体协作方面,它能够自主规划步骤、调度工具、校验结果,胜任桌面应用操作等长链路任务;在图文理解方面,无论是柱状图、流程图还是时长可观的视频内容,模型都能提取关键信息并完成推理分析。
与此同时,该模型兼容 OpenAI 与 Anthropic 主流接口协议,可无缝接入 Claude Code、Codex 等开发者工具,帮助开发者轻松构建高并发应用与智能工作流,大幅降低迁移与集成成本。这意味着团队无需重写已有代码,只需更换模型名称与接口地址,即可将现有应用平滑迁移到 Qwen3.8-Flash 之上。凭借优异的性能与极具竞争力的推理成本,Qwen3.8-Flash 已成为开发者和企业在 AI 应用中兼顾效果与效率的理想选择。
从模态支持能力来看,Qwen3.8-Flash 支持文本与代码输入输出,同时支持非实时图像理解与非实时视频理解,输入侧涵盖图像(Image)、文本(Text)、视频(Video)等多种模态,输出侧以文本(Text)为主,充分体现了其多模态大模型的定位。多模态 MOE 架构的引入,使模型在处理不同模态与不同任务时能够动态激活最合适的专家网络,在保证响应速度的同时最大化参数利用效率,这也是其"Flash"级速度背后的技术根基。
二、阿里云Qwen3.8-Flash模型功能
Qwen3.8-Flash 在功能层面提供了丰富而完善的特性支持,具体包括以下几项:
前缀补全:支持前缀补全能力,可根据给定前缀续写内容,适用于代码补全、文本续写等场景。在 IDE 与编辑器集成中,模型能够依据已有代码的命名风格、缩进习惯与逻辑脉络无缝续写后续实现;在写作场景中,则可延续既定语气与篇章结构完成长文创作,保证风格的高度统一与连贯。
缓存:支持上下文缓存机制,命中缓存的输入 token 可享受大幅价格优惠,显著降低重复调用成本。对于需要反复引用同一份手册、知识库或代码仓库的应用而言,缓存机制让首轮加载之后的每一轮对话都以极低边际成本进行,是长上下文应用降本增效的关键利器。
批量任务:支持 Batch 批量处理模式,通过 Batch File 与 Batch Chat 两种方式提供折扣价格,适合离线大批量推理任务。企业可以利用批量模式在夜间或低峰时段集中处理语料标注、数据清洗、批量摘要等任务,以近乎半价的成本完成规模化推理。
函数调用:支持 Function Calling,模型可自主调用外部函数与工具,是构建智能体(Agent)应用的核心能力。借助函数调用,模型能够查询数据库、调用业务 API、触发工作流,把"语言智能"转化为"行动能力",打通大模型与企业业务系统之间的最后一公里。
结构化输出:支持 JSON 等结构化格式输出,便于程序化解析与下游系统集成。结构化输出避免了自由文本解析的脆弱性,使模型结果可以直接进入下游程序逻辑,显著降低工程侧的容错与清洗成本。
联网搜索:支持联网搜索能力,模型可获取实时信息,提升回答的时效性与准确性。无论是最新政策、实时行情还是突发新闻,模型都能借助联网检索给出有据可查、时效性强的答案。
需要说明的是,微调功能当前暂未开放支持。总体而言,Qwen3.8-Flash 的功能矩阵覆盖了从基础推理到智能体构建的完整链路,能够满足绝大多数生产级应用的需求。
三、阿里云Qwen3.8-Flash模型能力(多地域部署)
Qwen3.8-Flash 已在阿里云百炼平台多个地域部署上线,覆盖国内、国际与全球部署范围,不同地域的能力支持情况如下:
华北2(北京)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
新加坡
部署范围:国际
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
德国(法兰克福)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 不支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
日本(东京)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 不支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
美国(弗吉尼亚)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 不支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
从能力对照表可以看出,五大地域在输入模态(Image、Text、Video)、输出模态(Text)、模型体验、Function Calling、结构化输出、前缀续写与上下文缓存等核心能力上保持高度一致;差异主要体现在联网搜索的地域开放情况上:华北2(北京)与新加坡地域支持联网搜索,而德国(法兰克福)、日本(东京)、美国(弗吉尼亚)等全球部署范围地域暂不支持联网搜索。多地域部署为出海企业与跨国团队提供了就近接入、数据合规的灵活选择,用户可根据业务所在区域与合规要求自由选择部署范围,在全球范围内获得一致的低时延推理体验。
四、阿里云Qwen3.8-Flash模型定价
Qwen3.8-Flash 的定价体系分为"模型调用"与"内置工具"两部分,价格极具竞争力,充分体现了其"效率旗舰"的定位。下文仅展示模型调用原价,不包含限时优惠等活动信息,详情可通过百炼平台了解:https://www.aliyun.com/product/bailian
模型调用定价:
- 输入:¥0.8 / M tokens;
- 输入(缓存命中):¥0.1 / M tokens,仅为标准输入价格的八分之一;
- 输出:¥2.7 / M tokens;
- 输入(Batch File):¥0.4 / M tokens,批量文件模式享受半价优惠;
- 输出(Batch File):¥1.35 / M tokens,同样为标准输出价格的五折;
- 显式缓存创建:¥1.25 / M tokens;
- 显式缓存命中:¥0.1 / M tokens;
- 输入(Batch Chat):限时5折,由 ¥0.8 降至 ¥0.4 / M tokens;
- 输出(Batch Chat):限时5折,由 ¥2.7 降至 ¥1.35 / M tokens。
内置工具定价:
- 代码解释器(code_interpreter):免费;
- 网页抓取(web_extractor):免费;
- web_fetch:免费;
- 以文搜图(t2i_search):¥24 / K 调用;
- 以图搜图(i2i_search):¥48 / K 调用;
- 联网搜索(web_search):¥4 / K 调用;
- PDF 理解(pdf_parsing):¥0.02 / 页;
- web_search:¥4 / K 调用。
可以看出,Qwen3.8-Flash 在保证模型能力的同时,通过缓存命中折扣、Batch 批量折扣和限时五折活动等多重优惠机制,将推理成本压缩到极低水平。隐式缓存命中与显式缓存命中均低至 ¥0.1 / M tokens,意味着长文档反复问答的边际成本几乎可以忽略不计;Batch File 与 Batch Chat 的半价优惠则让规模化离线推理的预算再降一半。与此同时,代码解释器、网页抓取、web_fetch 等高频工具免费开放,PDF 理解按页计费低至 ¥0.02 / 页,进一步降低了智能体应用的综合使用成本。尤其适合高并发、长上下文、大批量的生产级应用,是追求极致性价比团队的首选模型。
五、阿里云Qwen3.8-Flash模型速率限制与上下文
在速率限制与上下文容量方面,Qwen3.8-Flash 提供了业界领先的参数配置:
- 最大输入:991K tokens;
- 最大输入(思考模式):983K tokens;
- 上下文:1M tokens(百万级上下文窗口);
- TPM(每分钟 token 数):5M;
- 最大输出:131K tokens;
- 最大输出(思考模式):131K tokens;
- 最大思维链:262K tokens。
百万级上下文意味着模型可以一次性载入整部法律卷宗、整套代码仓库或数小时的会议记录进行分析;高达 5M 的 TPM 限额则为高并发服务提供了充足吞吐保障,远超同级别模型的并发承载能力,特别适合面向海量用户的在线服务;而 262K 的思维链长度上限,确保了模型在深度思考模式下仍能进行充分、细致的推理,兼顾了"快"与"深"的双重需求。即便在开启思考模式后,最大输入仍保持在 983K 的高水位,最大输出维持 131K 不变,意味着深度推理与超长上下文可以同时启用、互不妥协。
六、阿里云Qwen3.8-Flash模型内置工具
Qwen3.8-Flash 内置了八大工具,覆盖代码执行、多模态检索、网页信息获取与文档解析等能力:
- 代码解释器(code_interpreter):基于 Responses API,支持在对话中执行代码,完成计算、数据分析与图表绘制,免费使用;
- 以图搜图(i2i_search):基于 Responses API,支持以图像检索相似图像,适用于版权溯源、商品比对等场景,¥48 / K 调用;
- 以文搜图(t2i_search):基于 Responses API,支持以文本检索图像,为多模态创作与资料收集提供素材支撑,¥24 / K 调用;
- 网页抓取(web_extractor):基于 Responses API,支持抓取并解析网页正文内容,免费使用;
- 联网搜索(web_search):基于 Responses API,支持实时联网检索,¥4 / K 调用;
- PDF 理解(pdf_parsing):基于 Completions API,支持 PDF 文档解析理解,涵盖文字、表格与版式信息,¥0.02 / 页;
- web_fetch:基于 Anthropic API,支持网页内容获取,免费使用;
- web_search:基于 Anthropic API,支持网络搜索,¥4 / K 调用。
这些内置工具使 Qwen3.8-Flash 不再只是一个"对话模型",而是一个能够执行代码、检索图文、抓取网页、解析文档的完整智能体底座。模型可以在一次任务中自主组合多种工具,完成"检索—阅读—计算—写作—交付"的完整工作闭环,真正成为可端到端交付成果的智能协作伙伴。
七、阿里云Qwen3.8-Flash模型API 参考
Qwen3.8-Flash 提供 OpenAI 与 DashScope 两种接口规范,并支持 Python、Node.js、cURL 三种调用方式,同时兼容 Completions API 与 Responses API。以下以 Python + OpenAI 兼容接口(Completions API)为例,展示流式调用并分离"思考过程"与"完整回复"的典型代码:
from openai import OpenAI
import os

client = OpenAI(
    # 如果没有配置环境变量,请用阿里云百炼API Key替换:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

messages = [{
   "role": "user", "content": "你是谁"}]
completion = client.chat.completions.create(
    model="qwen3.8-flash",  # 您可以按需更换为其它深度思考模型
    messages=messages,
    extra_body={
   "enable_thinking": True},
    stream=True
)
is_answering = False  # 是否进入回复阶段
print("\n" + "=" * 20 + "思考过程" + "=" * 20)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if hasattr(delta, "reasoning_content") and delta.reasoning_content:
        if not is_answering:
            print(delta.reasoning_content, end="", flush=True)
    if hasattr(delta, "content") and delta.content:
        if not is_answering:
            print("\n" + "=" * 20 + "完整回复" + "=" * 20)
            is_answering = True
        print(delta.content, end="", flush=True)
该示例通过 extra_body={"enable_thinking": True} 参数开启思考模式,并以 stream=True 启用流式输出;在遍历响应块时,程序自动区分 reasoning_content(思考过程)与 content(完整回复)两个字段,先打印模型的推理链,再打印最终答案,便于在应用中分别呈现"思考"与"结论"两部分内容,兼顾透明度与用户体验。代码中只需将 model 参数替换为其他模型名即可切换深度思考模型,迁移成本极低。结合其对 OpenAI 与 Anthropic 协议的双重兼容,现有应用几乎无需改造即可平滑迁移至 Qwen3.8-Flash,快速享受百万级上下文与极致性价比带来的全新体验。
八、价格与优惠
截至目前,qwen3.8-flash正在进行多项限时优惠活动:
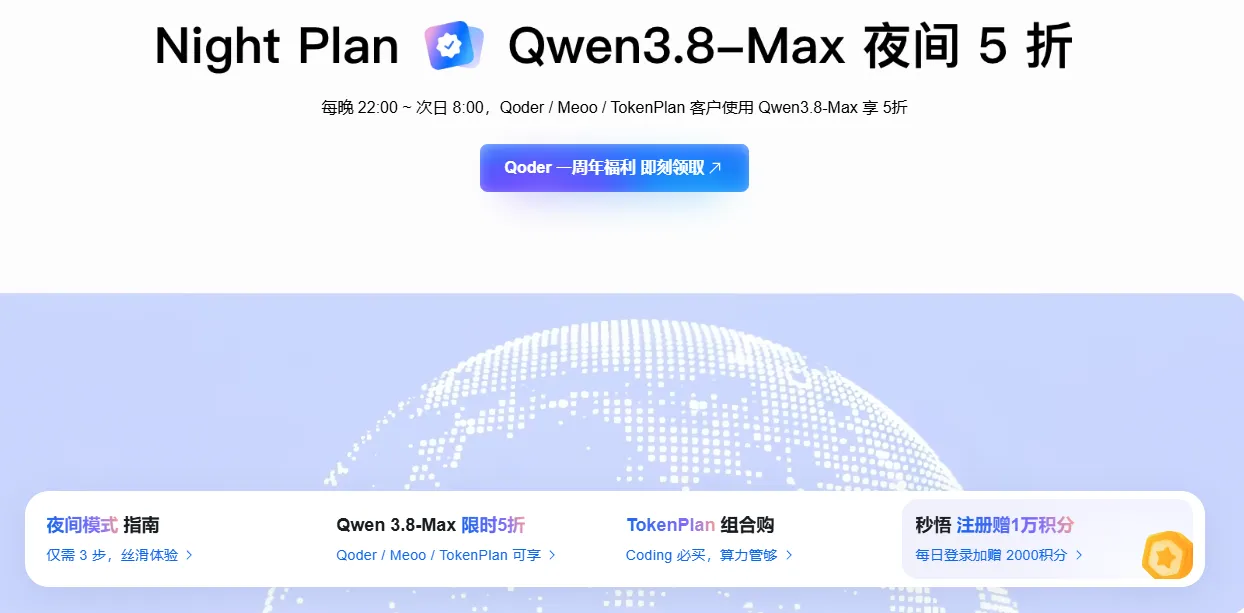
1、Night Plan夜间错峰优惠:每日22:00至次日08:00,Token Plan用户调用qwen3.8-flash的Credits消耗享折扣,搭配上下文缓存可进一步降低使用成本,适合批量代码分析、长文档处理、多轮Agent调试等高消耗场景,权益自动生效无需手动操作;活动详情可参考:https://www.aliyun.com/benefit/client/nightplan
2、AI焕新季满减券:2026年9月30日前,完成实名认证并开通百炼平台的特邀用户,可领取满20减10、满99减15、满199减35三档满减券,可用于Token Plan订阅、Qoder套餐等产品抵扣,领取后14天内有效;详情可参考:https://www.aliyun.com/benefit

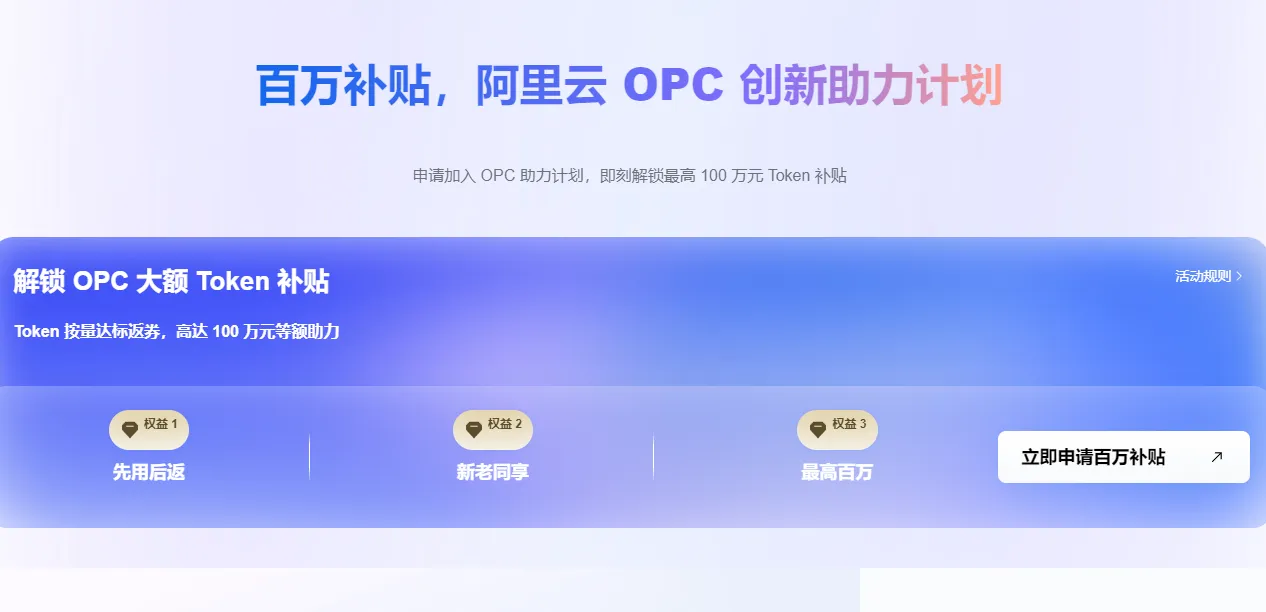
3、OPC创新助力计划:面向独立开发者、自由职业者及”一人公司”,提供最低1000元、最高100万元Token补贴,采用”先用后返”模式,根据实际消费金额次月获得相应额度的满返优惠券,加速AI创新落地;详情可参考:https://opc.aliyun.com/products
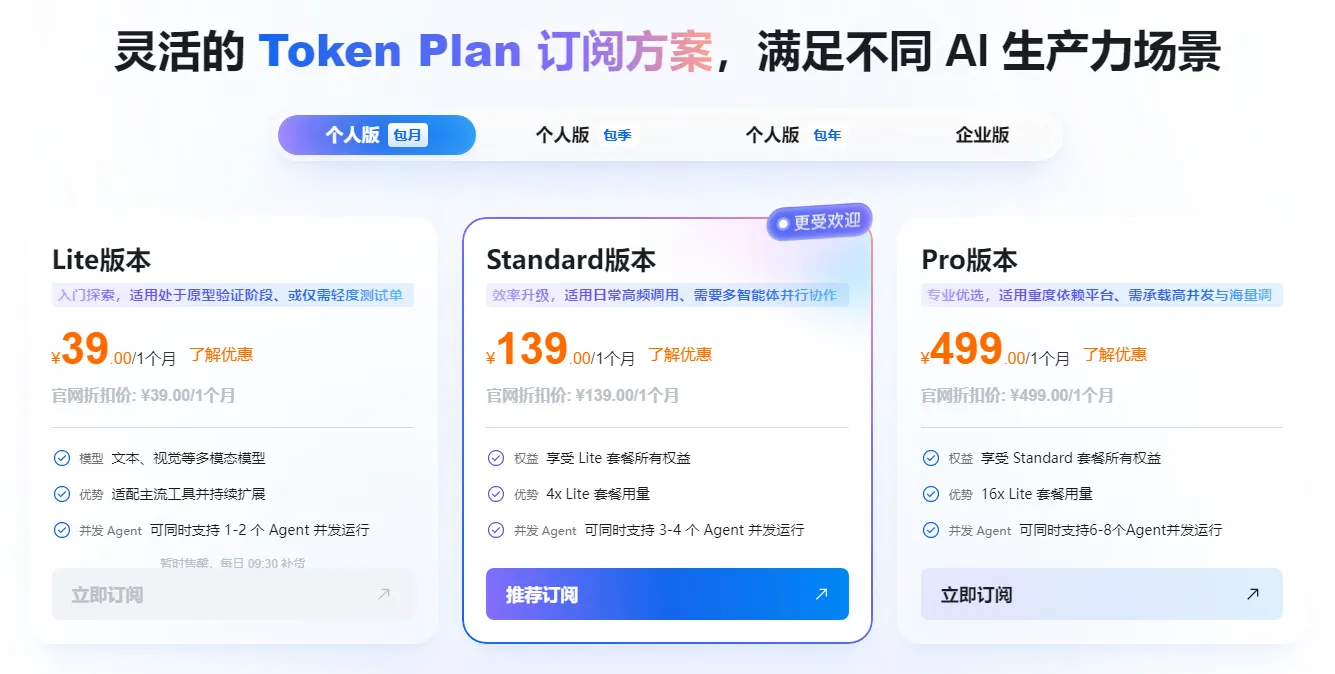
4、Token Plan限时活动价:个人版三档套餐均有限时优惠,团队版标准坐席限时150元/席位/月,相比按量付费可节省30%以上成本,适合高频使用的开发者和团队。活动详情可参考:https://www.aliyun.com/benefit/scene/tokenplan
九、总结与选型建议
综合来看,阿里云 Qwen3.8-Flash 以多模态 MOE 架构为底座,在理解力、生成质量与响应速度之间取得了出色平衡:它原生支持百万级上下文窗口,能一次性处理超长文档、代码仓库与复杂对话;在编程辅助、智能体协作、图文理解等场景表现卓越;兼容 OpenAI 与 Anthropic 双协议,可无缝接入 Claude Code、Codex 等主流开发者工具;配合覆盖北京、新加坡、法兰克福、东京、弗吉尼亚的多地域部署,以及缓存折扣、Batch 半价、免费工具构成的友好定价体系,为企业提供了"顶级效率 + 极致成本 + 灵活合规"的一站式解决方案。
在选型上,若您的业务追求高并发在线服务、长文档深度分析与规模化批量推理,且对推理成本敏感,Qwen3.8-Flash 无疑是兼顾效果与效率的理想选择;若任务对智能水平有极致要求(如超复杂工程开发、端到端智能体交付),则可搭配旗舰模型 Qwen3.8-Max 组合使用,形成"旗舰攻坚 + Flash 扛量"的弹性架构。无论您是构建智能编程助手、企业知识库问答、办公自动化系统,还是打造跨模态的智能体平台,Qwen3.8-Flash 都将是值得信赖的高效底座模型,助力开发者和企业在 AI 浪潮中以更低的成本释放更大的生产力。