阿里云百炼Qwen3.8-Max大模型在编码深度、协作智能体与视觉理解三大维度全面突破,并延续 100 万上下文、思考模式与完整工具生态;功能特性方面,前缀补全、缓存、函数调用、结构化输出、联网搜索均支持,批量任务与微调暂未全面开放;定价方面以"模型"和"内置工具"两个标签页展示(输入 ¥12/M tokens、输出 ¥36/M tokens、缓存命中 ¥1.5/M tokens、显式缓存命中 ¥1/M tokens、显式缓存创建 ¥15/M tokens,以及代码解释器免费、以文搜图 ¥24/K 调用、以图搜图 ¥48/K 调用、联网搜索 ¥4/K 调用、PDF 理解 ¥0.02/页等);速率限制与上下文参数为最大输入 991K、最大输出 131K、上下文 1M、TPM 1M、最大思维链 262K;同时展示八大内置工具清单;最后提供 OpenAI/DashScope 双协议、Python/Node.js/cURL 多语言的 API 调用示例代码。
一、阿里云Qwen3.8-Max模型概述
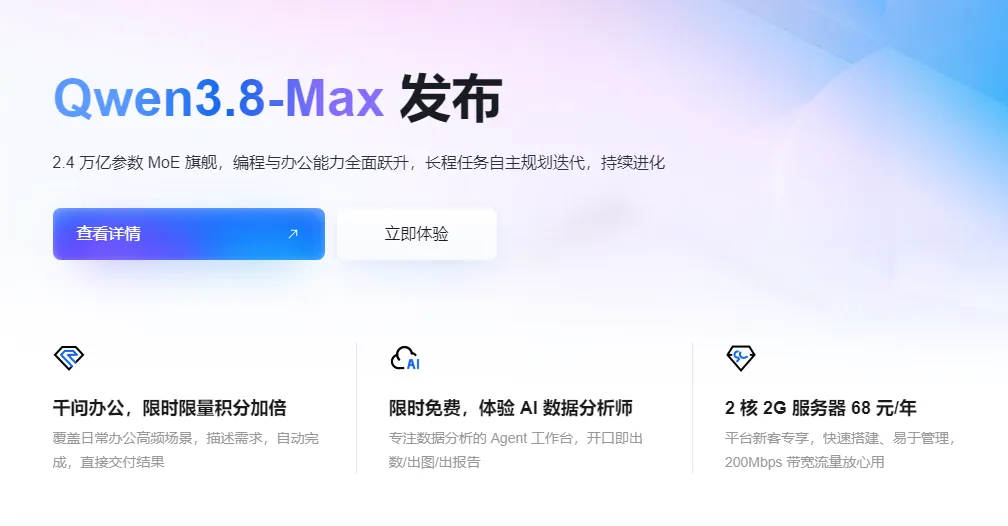
Qwen3.8-Max-0902(别名 qwen3.8-max-2026-09-02)是 qwen3.8-max 的快照版本,作为千问旗舰系列中智能水平的巅峰之作,该模型以高达 2.4 万亿的参数规模,实现了编程与办公能力的全面跃升。所谓"快照版本",意味着模型能力在特定时间点被固化封存,版本号中的"0902"即代表快照日期,企业用户可以据此获得稳定、可复现的模型行为,避免因模型持续更新而带来的输出波动,这对于追求确定性与合规审计的生产级系统而言至关重要。
在编码能力方面,Qwen3.8-Max 实现了深度再突破,可驾驭更复杂的工程级项目与长程自主开发。无论是大型代码仓库的重构、跨模块的系统设计,还是持续数小时甚至数天的自主开发任务,都能保持稳定的质量与连贯的思路。模型不仅能够理解单个函数的逻辑,更能把握整个工程的架构脉络,在依赖关系梳理、接口设计、缺陷定位与性能优化等环节展现出接近资深工程师的判断力,真正将 AI 编程从"补全片段"推进到"交付工程"的新阶段。
在协作智能体能力方面,该模型显著增强,在多工具调度与端到端交付中表现更从容,能够像一位经验丰富的"数字员工"一样自主规划任务、调用工具、校验结果并完成交付。面对复杂目标,Qwen3.8-Max 可以自行拆解子任务、选择合适的内置或外部工具、根据中间反馈动态调整策略,并在最终交付前进行自我检查与修正,从而大幅降低人工干预频率,让智能体应用从"演示demo"走向"可靠生产力"。
在视觉理解方面,Qwen3.8-Max 全面精进,图表推理、文档解析与多模态感知更敏锐准确,办公场景中的报表分析、合同审阅、票据识别等任务均可高质量完成。无论是折线图中的趋势推断、复杂表格中的跨列计算,还是扫描版合同中的条款比对,模型都能给出结构清晰、依据充分的分析结论,成为办公自动化流程中不可或缺的"多模态大脑"。
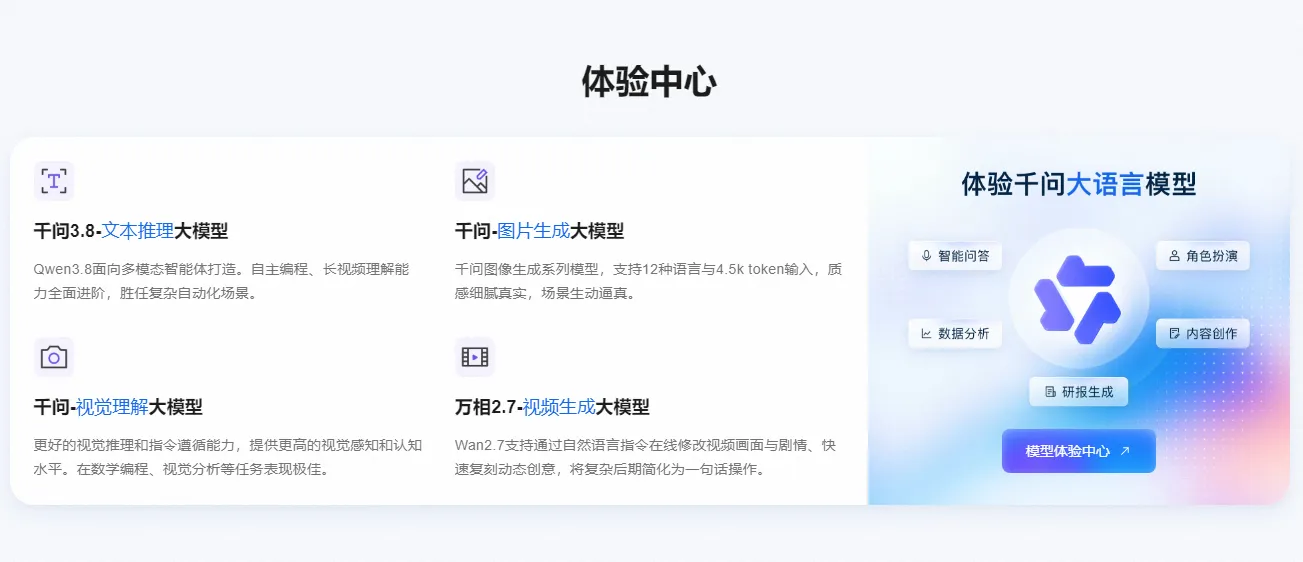
与此同时,Qwen3.8-Max 延续 100 万上下文、思考模式与完整工具生态,在更高智能水平上持续进化。从模态支持来看,模型输入侧支持图像(Image)、文本(Text)、视频(Video)等多种模态,涵盖文本与代码、非实时图像理解、非实时视频理解等能力,输出侧以文本(Text)为主,是名副其实的全能型多模态旗舰模型,能够为各行各业提供最顶级的智能支撑。
二、阿里云Qwen3.8-Max模型功能
Qwen3.8-Max 在功能层面提供了完善而强大的特性支持,具体包括:
前缀补全:支持根据给定前缀智能续写内容,广泛适用于代码补全、文案续写、公式推导等场景,大幅提升创作与开发效率。在 IDE 集成场景中,模型可以依据已有代码风格与命名习惯无缝续写后续逻辑;在写作场景中,则可延续既定语气与结构完成长篇内容,保证上下文风格的高度统一。
缓存:支持上下文缓存机制,重复调用时命中缓存的输入 token 可享受大幅价格优惠,将长文档反复问答的成本降至极低。对于需要反复引用同一份技术手册、法律卷宗或知识库的应用而言,缓存机制意味着首次加载之后的每一轮对话都能以极低边际成本进行,是长上下文应用降本增效的关键利器。
函数调用:支持 Function Calling 能力,模型可自主决策并调用外部函数与服务,是构建智能体应用、实现多工具编排的核心基石。借助函数调用,模型能够查询数据库、调用业务 API、触发工作流,将"语言智能"转化为"行动能力",打通大模型与企业业务系统之间的最后一公里。
结构化输出:支持 JSON 等结构化格式输出,保证返回结果可被程序稳定解析,便于与企业业务系统无缝集成。结构化输出避免了传统自由文本解析的脆弱性,使模型结果可以直接进入下游程序逻辑,显著降低工程侧的容错与清洗成本。
联网搜索:支持实时联网检索,使模型能够获取最新信息,回答时效性问题更加准确可靠。无论是今日股价、最新政策还是突发新闻,模型都可以借助联网搜索能力给出有据可查、时效性强的答案,并可结合网页抓取工具追溯信息来源。
需要说明的是,批量任务与微调两项功能的开放情况因地域而异:华北2(北京)地域支持批量推理,而新加坡等地域暂不支持批量推理;模型调优(微调)在当前各地域均暂未开放。整体而言,Qwen3.8-Max 的功能矩阵覆盖了从深度推理、智能体协作到系统集成的完整链路,足以支撑最苛刻的生产级应用需求。
三、阿里云Qwen3.8-Max模型能力
Qwen3.8-Max 已在阿里云百炼平台多个地域部署上线,不同地域的能力支持情况如下:
华北2(北京)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 支持 | 模型调优 | 不支持 |
新加坡
部署范围:国际
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
德国(法兰克福)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
从能力对照表可以看出,三大地域在输入模态(Image、Text、Video)、输出模态(Text)、模型体验、Function Calling、结构化输出、联网搜索、前缀续写与上下文缓存等核心能力上保持高度一致,差异主要体现在批量推理的地域开放进度上:华北2(北京)地域已完整支持批量推理,适合大规模离线推理任务;新加坡(国际部署范围)与德国法兰克福(全球部署范围)地域暂不支持批量推理。多地域部署为出海企业与跨国团队提供了就近接入、数据合规的灵活选择,用户可根据业务所在区域与合规要求自由选择部署范围。
四、阿里云Qwen3.8-Max模型定价
Qwen3.8-Max 的定价体系分为"模型调用"与"内置工具"两部分。下文仅展示模型调用原价,不包含限时优惠等活动信息,详情可通过百炼平台了解:https://www.aliyun.com/product/bailian
模型调用定价:
- 输入:¥12 / M tokens;
- 输入(缓存命中):¥1.5 / M tokens,仅为标准输入价格的 12.5%,成本优势显著;
- 显式缓存命中:¥1 / M tokens,进一步压低高频重复调用成本;
- 输出:¥36 / M tokens;
- 显式缓存创建:¥15 / M tokens。
内置工具定价:
- 代码解释器(code_interpreter):免费;
- 网页抓取(web_extractor):免费;
- web_fetch:免费;
- 以文搜图(t2i_search):¥24 / K 调用;
- 以图搜图(i2i_search):¥48 / K 调用;
- 联网搜索(web_search):¥4 / K 调用;
- PDF 理解(pdf_parsing):¥0.02 / 页;
- web_search:¥4 / K 调用。
作为旗舰级模型,Qwen3.8-Max 的定价与其顶级智能水平相匹配,同时通过多层次的缓存优惠机制为长上下文、多轮次的深度应用提供了可观的成本优化空间:隐式缓存命中价格低至 ¥1.5 / M tokens,显式缓存命中更是低至 ¥1 / M tokens,相当于标准输入价格的约十二分之一。对于知识库问答、文档审阅、代码仓库分析等"一次加载、反复使用"的典型场景,缓存机制可将综合成本压缩数倍乃至一个数量级。与此同时,代码解释器、网页抓取、web_fetch 等高频工具免费开放,PDF 理解按页计费低至 ¥0.02 / 页,更进一步降低了智能体应用的综合使用成本,让企业能够以可控的预算释放旗舰模型的全部潜力。
五、阿里云Qwen3.8-Max模型速率限制与上下文
在速率限制与上下文容量方面,Qwen3.8-Max 提供了旗舰级的参数配置:
- 最大输入:991K tokens;
- 最大输入(思考模式):983K tokens;
- 上下文:1M tokens(百万级上下文窗口);
- TPM(每分钟 token 数):1M;
- 最大输出:131K tokens;
- 最大输出(思考模式):131K tokens;
- 最大思维链:262K tokens。
百万级上下文窗口意味着模型可以一次性载入整套代码工程、整年财务报表、整部学术专著或数万轮历史对话进行全局分析,彻底告别"分段截断、信息丢失"的传统困境。接近百万 token 的最大输入长度(思考模式下 983K)确保即便在开启深度思考时,依然可以容纳海量原始材料;131K 的最大输出长度足以支撑超长技术报告、完整项目代码与详尽调研文档的一次性生成;而高达 262K 的思维链上限,则确保模型在思考模式下能够进行极其充分、缜密的深度推理,将"慢思考"的能力发挥到极致,特别适合复杂数学证明、系统架构设计、跨文档证据链梳理与长程任务规划等高难度任务。1M 的 TPM 限额则为并发服务提供了稳定的吞吐保障,配合批量推理能力(北京地域),可从容应对企业级高峰流量。
六、阿里云Qwen3.8-Max模型内置工具
Qwen3.8-Max 内置八大工具,构成完整的智能体能力生态:
- 代码解释器(code_interpreter):基于 Responses API,支持在对话中安全执行 Python 代码,完成数学计算、数据分析与图表绘制,免费使用;
- 以图搜图(i2i_search):基于 Responses API,支持以图像检索相似或同源图像,适用于版权溯源、商品比对等场景,¥48 / K 调用;
- 以文搜图(t2i_search):基于 Responses API,支持以文本描述检索图像,为多模态创作与资料收集提供素材支撑,¥24 / K 调用;
- 网页抓取(web_extractor):基于 Responses API,支持抓取并结构化解析网页正文内容,免费使用;
- 联网搜索(web_search):基于 Responses API,支持实时联网检索信息,¥4 / K 调用;
- PDF 理解(pdf_parsing):基于 Completions API,支持 PDF 文档的深度解析与理解,涵盖文字、表格与版式信息,¥0.02 / 页;
- web_fetch:基于 Anthropic API,支持网页内容获取,免费使用;
- web_search:基于 Anthropic API,支持网络搜索,¥4 / K 调用。
借助这套工具生态,Qwen3.8-Max 能够自主完成"检索—阅读—计算—写作—交付"的完整工作闭环:先通过联网搜索与网页抓取获取资料,再用 PDF 理解解析文档、用代码解释器验证计算,最终输出结构化结论,真正成为可端到端交付成果的智能协作伙伴。
七、阿里云Qwen3.8-Max模型API 参考
Qwen3.8-Max 提供 OpenAI 与 DashScope 两种接口规范,支持 Python、Node.js、cURL 三种调用方式,并兼容 Completions API 与 Responses API,开发者可按既有技术栈自由选择接入路径。以下以 Python + OpenAI 兼容接口(Completions API)为例,展示开启思考模式并流式分离"思考过程"与"完整回复"的典型代码:
from openai import OpenAI
import os

client = OpenAI(
    # 如果没有配置环境变量,请用阿里云百炼API Key替换:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

messages = [{
   "role": "user", "content": "你是谁"}]
completion = client.chat.completions.create(
    model="qwen3.8-max-0902",  # 您可以按需更换为其它深度思考模型
    messages=messages,
    extra_body={
   "enable_thinking": True},
    stream=True
)
is_answering = False  # 是否进入回复阶段
print("\n" + "=" * 20 + "思考过程" + "=" * 20)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if hasattr(delta, "reasoning_content") and delta.reasoning_content:
        if not is_answering:
            print(delta.reasoning_content, end="", flush=True)
    if hasattr(delta, "content") and delta.content:
        if not is_answering:
            print("\n" + "=" * 20 + "完整回复" + "=" * 20)
            is_answering = True
        print(delta.content, end="", flush=True)
该示例通过 extra_body={"enable_thinking": True} 参数开启思考模式,并以 stream=True 启用流式输出;在遍历响应块时,程序自动区分 reasoning_content(思考过程)与 content(完整回复)两个字段,先打印模型的推理链,再打印最终答案,便于在应用中分别呈现"思考"与"结论"两部分内容,兼顾透明度与用户体验。代码中只需将 model 参数替换为其他模型名即可切换深度思考模型,迁移成本极低。凭借对 OpenAI 与 Anthropic 协议的双重兼容,现有应用几乎无需改造代码即可接入 Qwen3.8-Max,即刻体验旗舰级智能带来的编程与办公能力全面跃升。
八、qwen3.8-max模型最新活动与优惠
截止目前,与Qwen3.8-Max相关的活动信息如下:
1、Token Plan个人版上线:首发体验Qwen3.8-Max,基础额度用量充裕,夜间调用更省钱,包月最低39元起。活动详情可参考:https://www.aliyun.com/benefit/scene/tokenplan

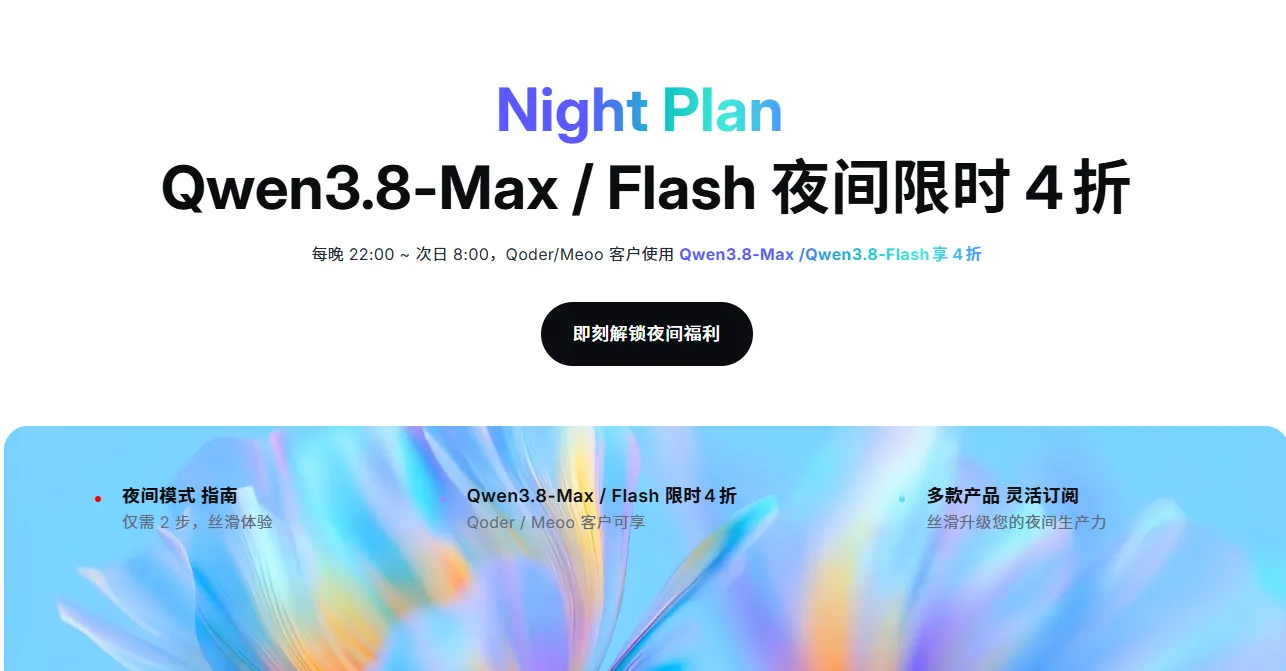
2、Night Plan夜间限时优惠:每晚22:00至次日8:00,Qwen3.8-Max / Flash 夜间限时 4折,个人版基础档低至19.5元/月,适合批量数据处理、模型微调等非实时任务。活动详情可参考:https://www.aliyun.com/benefit/client/nightplan
3、新用户免费额度:新用户开通即享超7000万免费tokens,90天有效期;另有新用户赠送1亿+ tokens额度。具体额度以免费试用页或控制台实时显示为准。
4、限时优惠活动:百炼控制台展示Qwen3.8-Max有"限时优惠"标识,部分计费项如Batch Chat输入/输出有限时5折优惠。具体折扣率和适用范围请以百炼控制台或官方定价页实时显示为准。
5、AI特惠活动:智启AI普惠权益提供至高1亿+免费tokens,加速AI应用落地。
综合来看,阿里云 Qwen3.8-Max 以 2.4 万亿参数的旗舰规模,在编码深度、协作智能体与视觉理解三大维度实现了全面突破:它能驾驭工程级代码项目与长程自主开发,能像"数字员工"一样多工具调度、端到端交付,能敏锐解析图表、文档与多模态内容;同时延续 100 万上下文、思考模式与完整工具生态,配合覆盖北京、新加坡、法兰克福的多地域部署,以及缓存折扣、免费工具构成的友好定价体系,为企业提供了"顶级智能 + 可控成本 + 灵活合规"的一站式解决方案。无论您是构建智能编程助手、办公自动化系统,还是打造跨模态的企业智能体平台,Qwen3.8-Max 都将是值得信赖的旗舰级底座模型。