这周的 AI 圈被 OpenAI 的 ChatGPT Images 2.5 刷了屏:生成延迟最多降一半、多轮编辑不崩细节、新增 Sketch 手绘参考,媒体称它「AGI 时代的第一个生图模型」。顺带一个更稳的判断:也有博主对比后认为 2.0 的真实感反而更好,这代 2.5 主打的是编辑精度与生成速度,刷屏主力其实是「灵魂画作」类玩梗图。同期阿里云百炼侧也有一件值得注意的事:通义万相 Wan3.0 视频模型八月公测后完成接入,20 素材参考、原生 30 秒 1080P 带音频、文档网页直接转视频,且后付费限时 7 折至 9 月 23 日。
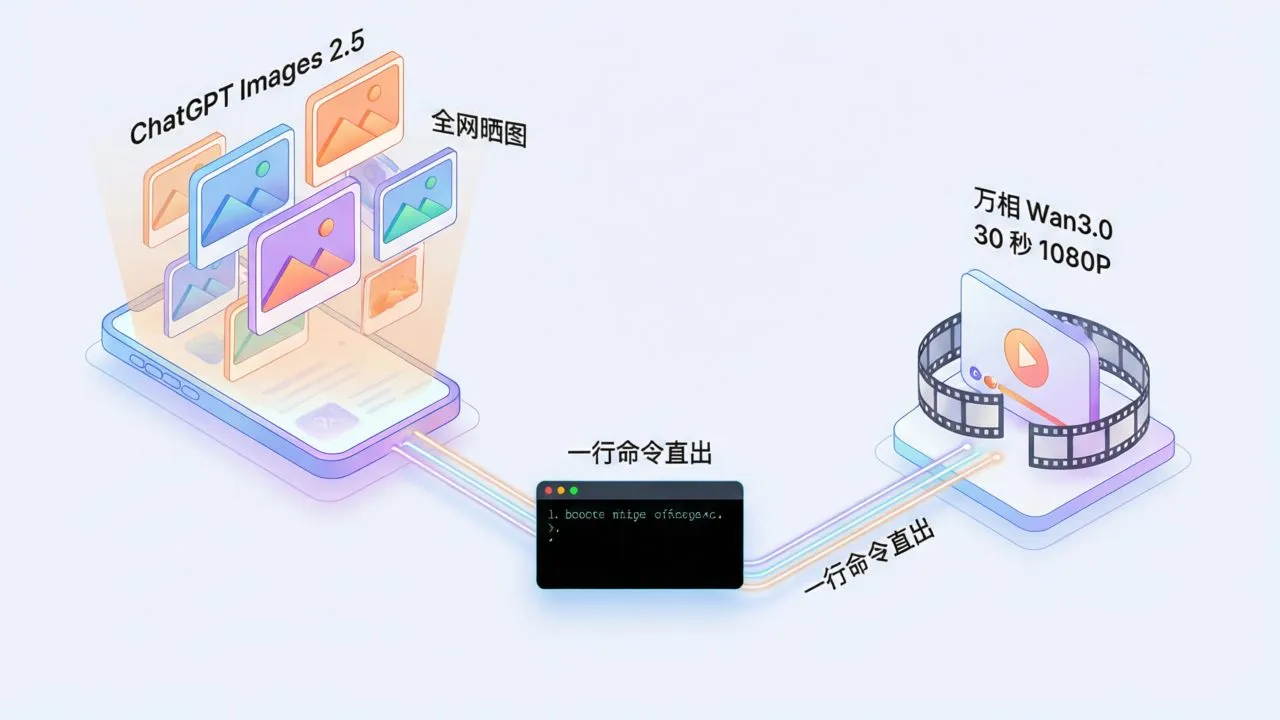
两个事件放在生态视角下有一个共同落点:生成能力的消费门槛正在快速下沉,但「网页版排队 + 订阅 + 网络条件」仍是大多数人动手的第一道坎。而开发者这一侧的真实状态是:一天的大部分时间在跟 coding agent 对话,命令都是 Agent 替我们跑的。既然如此,最短路径不是新开一个终端,而是把百炼 CLI(bl)装进 Agent——装好之后,生图生视频变成对话里的一句话,产物直接落本地。
这周我跑了两轮九个场景:全部真实产出、全程付费十块四。CLI 的安装入口在这里。
五个能力场景
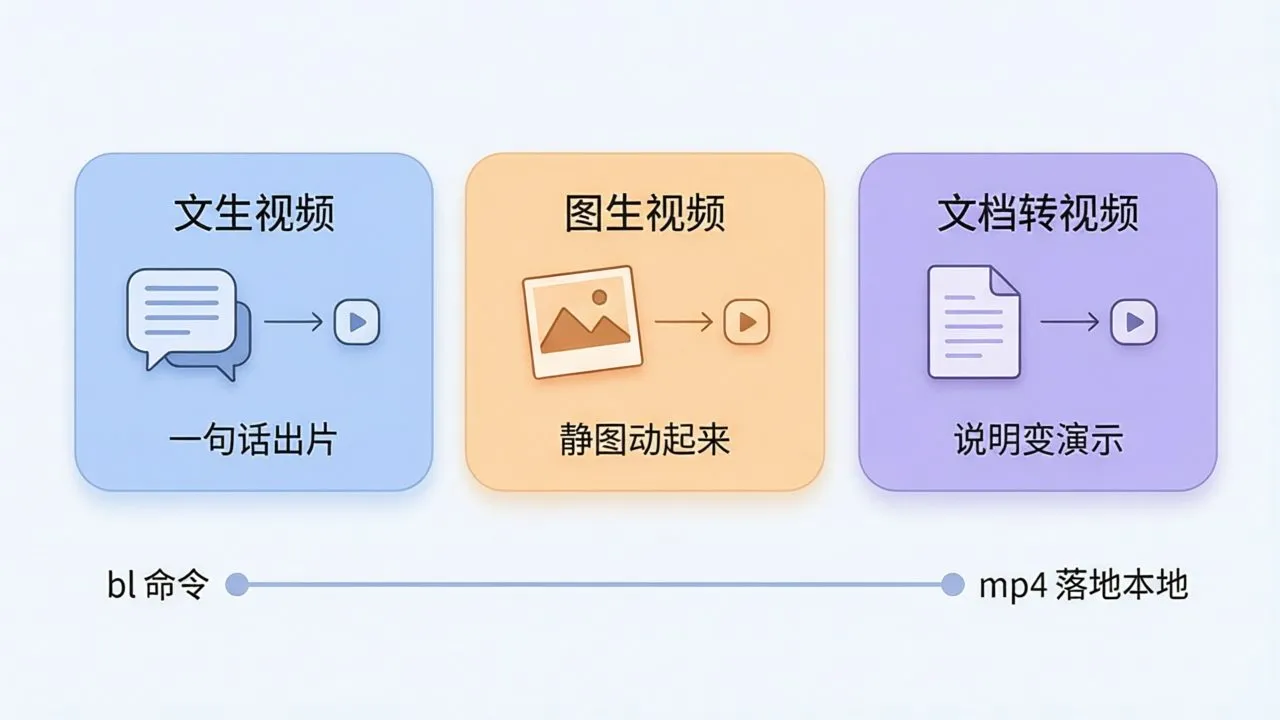
文生视频(免费额度路线)。对 Agent 说:
生成一段视频:柯基在黄昏沙滩追飞盘,慢镜头,暖色调逆光,1080P,五秒。
Agent 调用百炼 CLI 的视频生成工具,实际执行:
bl video generate --model wan2.7-t2v-2026-06-12 \
  --prompt "一只柯基犬在黄昏的沙滩上奔跑追逐飞盘,慢镜头,暖色调逆光" \
  --resolution 1080P --duration 5 --download corgi.mp4
实测产出 8.3 MB 1080P 成片,等待约两分钟。要竖屏就跟 Agent 说「竖屏的」,它加 --ratio 9:16,直接出短视频平台比例。
顺带一个和预算直接相关的细节:bl video generate 的默认模型已经是 wan3.0-video,走按量付费;免费额度在 wan2.7-t2v 上,要显式 --model 才会吃。默认值和省钱是错开的,把这条规则写进 Agent 的 skill 说明里,它拼命令时才会主动带上,不然就默认落进付费模型。
图生视频链(静图动起来)。先说「生成一张插画:机器猫坐窗台看雨,马卡龙色调」,十几秒出图;再说「把这张图变成视频,猫眨眨眼,雨滴落下,镜头推近」。Agent 串两条命令:
bl image generate --prompt "极简插画:机器猫坐窗台看雨,马卡龙色调" \
  --size "1280*720" --watermark false --out-dir ./out --out-prefix base
bl video generate --image ./out/base.png \
  --prompt "机器猫轻轻眨眼,雨滴落下,镜头推近" \
  --resolution 720P --duration 5 --download cat.mp4
静图不满意让 Agent 重生成,只要几毛钱。当期实况是生图模型 qwen-image-3.0 没有免费额度(额度状态八月之后有过变化),单张付费量级两毛,试错成本可控,但别默认生图是零元的。
多轮改图链(对标 Images 2.5 的刷屏玩法)。ChatGPT 那波的核心是「多轮修改不崩细节」,百炼侧的对应物是 bl image edit:对话侧连说三轮(改氛围、加道具、换风格),Agent 逐轮以上一轮产物为输入拼命令:
bl image edit --image ./out/base.png \
  --prompt "把画面改成黄昏时分的暖色调氛围" \
  --watermark false --out-dir ./out --out-prefix edit1
# 第二轮 --image ./out/edit1.png,第三轮 --image ./out/edit2.png
实测第 2 轮加的道具(窗台上的多肉和一杯热可可)在第 3 轮换成吉卜力水彩风格后仍在原位,构图不变;改图与生图同价(两毛上下),中间产物全部落盘可回退。
首尾帧延时(kf2v 模式)。bl video generate --image 白天图 --last-frame 夜景图,两张静图夹出五秒日夜过渡:先生成白天城市天际线,再用 bl image edit 改出同构图夜景,一条命令出片。抽帧验证首末帧与输入一致,720P 五秒 2.1 元(7 折)。「从白天到夜晚」这类实拍要蹲点的过渡镜头,成本降到两张图加一条命令。
文档转视频(Wan3.0 独有 --file 入口)。对 Agent 说「把这份文档变成演示视频,信息图表风格」:
bl video generate --file ./说明文档.md \
  --prompt "产品发布节奏演示动画,信息图表风格" \
  --resolution 720P --duration 5 --timeout 900 --download demo.mp4
实测含文档解析等了约八分钟,关键节点依次点亮。整条工具链的等待梯度大致是:生图十几秒,文生视频两三分钟,文档转视频最慢。这个入口把「写文档的人」和「做演示视频的人」接到了同一句对话上。
三个实测发现
- 轮询超时 ≠ 任务失败:
--file场景默认超时不够报了 Polling timed out,但云端任务继续跑且会计费——此时让 Agent 盲目重跑等于双倍计费(Agent 看到报错的第一反应恰恰就是重跑)。正确姿势:加大--timeout,或--async拿任务号手动查。 - 查账是一句话的事:跑付费任务前对 Agent 说「查一下免费额度」,它跑
bl usage free列出所有模型余额。本次两轮加补测付费总额 ≈10.4 元(三条文生视频走免费额度零元)。 --seed实测不能复现:参数文档写「可复现结果」,同描述同 seed 两次出图构图道具全变、MD5 不同,它的语义是「降低随机性」。另两条生图实测一并记录:中文文字渲染可靠(prompt 内嵌排版要求,出图无错字,做活动头图直接把文案写进描述),顺着这个能力补测的复杂提示词海报把画幅、背景、主体位置、层级文字、徽标、风格、色彩、留白八类要素写全,一张出活、要素全在位——提示词写得越全,一次通过的几率越大;--n 4一次出四张候选,计费同步乘四。
前两个发现的解法后来都沉淀成了给 Agent 的规则:报超时先跑 bl video task get --task-id <任务号> 查状态、确认真失败了再重跑,文档转视频默认 --timeout 900;付费任务前先说一句「查一下免费额度」。规则写进 Agent 的说明文件,问题到解法这条链就固定下来了,不靠人记。
这条路线的适配面也说一下:适合已经在日常用 coding agent 的开发者或内容小组,生成需求高频、产物要落库归档;如果只想要网页版的所见即所得,它反而不占优。它的优势在网页工具给不了的地方:--n 可批量、JSON 输出可审计、多轮改图的中间产物落盘可回退(--seed 实测不能复现,别写进依赖流程),这些都是接进工具链之后才兑现的属性。
生态位小结:ChatGPT 那波热度负责把「想试试」的念头种给大众,百炼 CLI 这条线负责把念头变成对 Agent 说的一句话。还差一个 API Key 的话,控制台免费领。装好之后评论区说一个你想生成的画面,我挑几条帮跑。