欢迎收听阿里云【AI访谈录】
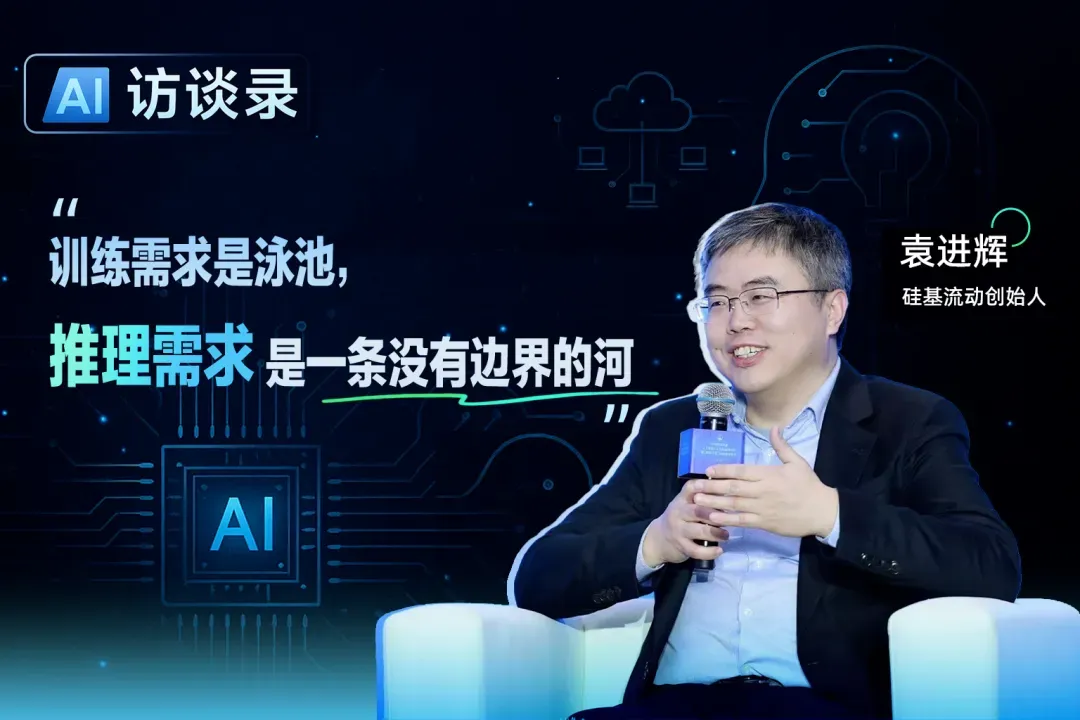
本期栏目组邀请到硅基流动创始人袁进辉博士,围绕“大模型推理系统未来的演化路径”、“模型是否还会继续变大”、“如何更好支撑AI应用”等话题,分享他在AI Infra领域的第一手思考。
时间轴
Timeline
03:49
未来推理需求和训练需求会各占什么样的比重
07:16
AI应用爆发的节点已经到了
13:40
DeepSeek爆火带来的高流量是怎么承接住的
17:48
千问的能力处于第一梯队而尺寸是中等型号
21:22
合作互补是各企业面对AI市场快速增长更好的方式
27:34
接下来AI基础设施演进的重点是什么
以下为对话内容精选,经整理略有删减。
01训练是泳池,推理是一条没有边界的河
栏目组:能不能简单介绍一下您的技术背景,以及硅基流动目前聚焦在做什么?
袁进辉:我最早做的是机器学习算法,博士和博士后期间也都是做算法研究。进入工业界后逐渐转向系统层工作,也就是AI基础设施。
从微软亚洲研究院出来后有多段创业经历,第一段创业在一流科技做了OneFlow,是一个专注于训练需求的开源深度学习框架。
现在的硅基流动则专注在大模型推理和部署环节,目标是让模型“部署更方便、跑得更快”。
栏目组:从训练框架转型到推理系统,是一个蛮大的变化,背后是什么判断?
袁进辉:上次创业我们是从 idea 出发再找市场,这次是反过来:先看市场再决定做什么。训练平台的客户非常集中,全球能训大模型的公司就几十家,但需要部署大模型的企业则多得多。从商业化角度看,推理平台的市场更广、需求更现实。
栏目组:您怎么看推理和训练在算力需求上的比例变化?
袁进辉:我们常用一个比喻:训练像泳池,水量是固定的;推理像一条河,是不断流动的。预训练阶段的Token量是静态的,而推理一旦上线,访问量是无上限的。
过去,训练和推理的算力需求是1比1,未来可能是1比10、1比100。随着像通义、DeepSeek 这样的开源模型越来越强,推理的算力需求还会持续上升。
栏目组:您怎么看当前AI Infra的发展阶段?目前行业最关注的是什么问题?
袁进辉:AI Infra本身也处在一个早期阶段,跟模型和应用一样,都在快速演化。它要解决的问题,是随着行业需求一步步推出来的。
第一阶段是降低开发门槛。过去跑一个模型,需要先找一块GPU、下载模型、配置环境、调通代码、部署上线。现在如果模型已经部署在云上,用户直接通过API调用就可以了。这会极大提高开发者的迭代效率,也让更多人能用上大模型。
第二阶段是满足弹性扩展。现在很多AI应用已经开始跑起来了,月活几百万、上千万甚至更高的需求开始出现,这时就需要基础设施能稳定支撑大规模调用,做到横向扩容、负载均衡,保证系统稳定。
第三阶段是大规模降低成本。Token的成本、长上下文的算力消耗,都是影响模型服务规模化落地的关键。基础设施系统需要持续优化资源利用率,才能把成本压下来,确保大模型“用得起”。
说到底,这三个问题本质上串联的是一件事:怎么让AI真的能用得起来、用得下去。
02推理系统未来会像一个AI专用的小型操作系统
栏目组:您怎么看过去几年推理系统的演化?从最早单机的部署到现在集群化或者异构调度,这中间经历了哪些关键阶段?
袁进辉:最早模型还不大,基本是稠密模型,推理系统也比较简单,主要解决单卡部署的问题。后来随着模型参数越来越大,特别是 MoE(Mixture of Experts)结构的普及,系统架构就变复杂了。
传统的并行方式,比如数据并行、模型并行,不再够用。后来开始引入专家并行,同时也带来了服务质量方面的新要求,比如 TTFT(首次响应延迟)、TPS(单位时间推理吞吐量)这类指标。为了更好满足这些需求,系统进一步拆分成 prefill 和 decoding 两个阶段,分别专门优化。
现在我们看到的大模型推理系统,基本都已经具备了 PD 分离、专家并行、分布式缓存等复杂机制。未来,可能还会有针对性更强的系统演化。
栏目组:面对这些变化,推理系统都做了哪些底层优化?
袁进辉:在早期,优化更多集中在算子级,比如融合、量化,还有把模型整图直接扔到GPU上运行。
现在不一样了,像PD分离、专家并行这种结构,对系统的通信调度压力非常大。我们做了不少优化,比如高效的 All-to-All 通信、支持长上下文的分布式 KV Cache。这时候不只是考虑在单卡上怎么跑得快,还要考虑多卡之间怎么协作好。
推理系统不再只是“计算”问题,而是一个更完整的“系统工程”问题,要同时处理计算、通信、存储等多个维度。
栏目组:未来推理系统会演化成什么样?您觉得它更像操作系统,还是像编译器?
袁进辉:现在推理系统本身就大量使用了编译器技术,比如图优化、调度策略。但如果从它要承担的功能来看,其实更像一个“AI专用的小型操作系统”。
它不仅要管理算力、内存、通信资源,还要处理延迟、吞吐、上下游协同问题。
栏目组:未来推理系统可能不只是个工具,还是一个智能调度中台?
袁进辉:未来推理系统要解决的问题,不会只停留在模型本身的加速和优化上,它需要解决更多的问题——比如它要和搜索系统、存储系统,甚至是上层的Agent、MCP等智能体组件打通,可能就会向更丰富的生态去演化和发展。
03通义千问是硅基流动上访问量最大的模型
栏目组:今年春节期间,DeepSeek 爆火,硅基流动是最早上线其 API 的平台之一。那段时间访问量很大,你们内部有没有遇到什么挑战?是怎么快速应对的?
袁进辉:硅基流动确实是当时最早上线 DeepSeek API 的团队之一,我们去年在 DeepSeek 的上一代模型出来时就做了适配,所以提前打好了底子。等到这代模型火起来时,有些工作已经准备好了,支持起来也就快很多。
春节期间我们团队也临时决定全员远程支援,抓紧把模型适配、部署、扩容都做完了。
栏目组:这次之后你们有没有复盘,未来如果又有类似“模型爆火”的情况,会怎么做得更好?
袁进辉:一个核心经验就是:提前准备,预判趋势。现在模型更新太快,而且结构差异也大,比如 DeepSeek 引入了像 MLA、专家并行这些新架构,如果没提前研究,临时适配起来可能得花上好几周甚至一两个月。
我们有一些开发者社群,在里面能较早捕捉到哪些模型受关注,哪些结构是主流,我们会基于这些信号提前做一些技术准备,包括推理引擎架构的开放性,确保能更快适配模型结构的变化。
还有一点也很关键:弹性算力的保障。这种爆发式流量必须要底层系统撑得住,也需要有云厂商作为稳定的算力支撑。阿里云的算力资源在国内、海外都很充足,我们这次也和阿里云进行了比较密切的对接,这种合作非常关键。
栏目组:像通义千问3发布之后,硅基流动也是第一时间就上线了平台,能不能跟我们分享一下,你们大概是什么时候注意到千问的,然后大家的反馈是什么样的?
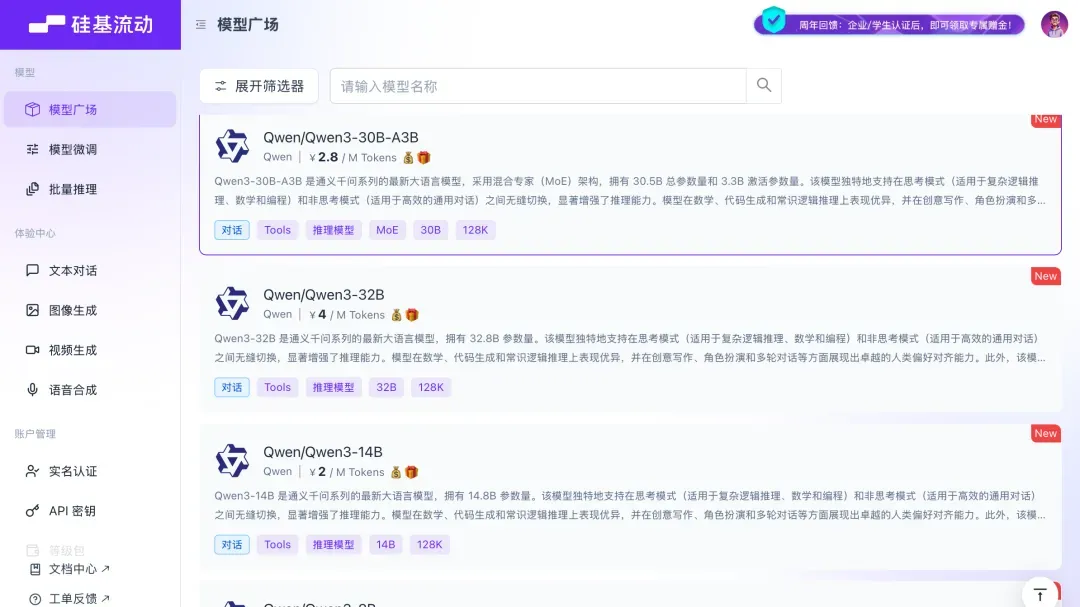
袁进辉:我们一直在跟通义千问系列,千问2出来的时候就做了支持。一方面是因为它在开发者社群里口碑非常好,另一方面它在我们平台上的访问量也是最大的。
相比其他模型,通义千问的优势是能力强、体积适中、生成速度快。我们有些客户对响应速度要求特别高,比如每秒要生成 50 到 100 个 Token,这种场景下千问非常合适。
千问3出来之后,模型结构有一些变化,像稠密模型不用做适配,直接就可以上线了,MoE 做了一点适配,也在几天之内上线了。
栏目组:你们选择把 API 服务接入阿里云百炼生态,也上线阿里云云市场。在你看来,云平台能在哪些方面为 AI Infra 公司提供支撑?
袁进辉:最核心的一点是,阿里云算力资源的覆盖广、弹性强。尤其是面对突发流量,像阿里云在全国各地和海外(比如东南亚)都有布局,对我们这种基础设施平台非常关键。
第二是协同机会大。比如我们平台上很多流量来自千问系列模型,我们也希望跟通义团队有更深入的合作,不只是部署层面,还包括反馈用户需求、适配优化。
第三是生态互补。有些客户既要公有云,也要私有部署。很多场景都不是单一模式能解决的,需要双方能力互补。
在海外,我看到阿里云也有很全面的海外战略和布局,我们也很希望和阿里云一道,服务好出海的中国应用开发者。
我觉得现在全世界最好的开源大模型就是在中国,像通义千问和DeepSeek。开源模型触达到全球的开发者,他们使用源自中国的这些开源模型,也就更容易接受围绕开源模型的产品或者项目,这是一个比较自然触达到海外开发者的方式,从而有可能会进一步有助于这些模型与产品,渗透到企业级用户。
04模型演进的方向:更丰富的数据源、更长、更精准的上下文处理能力
栏目组:早在 2014 年,您就判断模型一定会变得非常大。当时为什么会得出这个结论?这个观点在业内算激进的吗?
袁进辉:是的,算是一个比较激进甚至有些“反共识”的判断。当时这么看的人并不多。
这个判断源于我在清华博士后期间做脑科学研究的经历。那时我了解到,大脑的神经元数量是千亿级别,连接数量更是达到百万亿级。而当时的人工神经网络模型,参数量最多也就是几千万量级。这种巨大的数量级差异,很自然引发了一个想法:既然生物智能依靠的是大规模连接,那人工模型是不是也应该变得更大?
另一方面,从统计机器学习的基础理论来看,模型容量越大、数据越丰富,它所能表达和捕捉的规律就越多。所以我当时判断:只要数据和算力条件允许,大模型一定会成为趋势。
真正的问题在于,那时还没有合适的系统和硬件来支持这么大规模的模型训练。所以我从微软离职,开始研发 OneFlow,就是想搭建一套能支撑“非常大模型的训练”的系统基础设施。
虽然我预判模型会变大,但坦率说,当时并没想到它们会强大到今天这个程度。
栏目组:那从现在往后看,您认为模型的发展趋势会是越来越大,还是转向“小模型+场景化”?
袁进辉:现在模型的参数已经很大了,未来如果能在保证能力不降的前提下进一步小型化,会带来更高的部署效率。但如何做到“小而强”,仍需要深入研究。
更关键的还是数据。如今 Scaling Law 遇到瓶颈,是因为互联网上的自然语言数据基本被用尽了,接下来模型能力的提升要依赖更丰富的数据来源,比如专业数据,或通过强化学习等方式与环境交互,获得反馈。这是未来提升模型能力的重要方向。
另一个趋势是提升模型的“上下文理解能力”。模型本身有知识,但要解决实际问题,必须结合上下文输入。如果上下文太短,它就无法真正理解用户或场景的复杂性。
所以,未来两个核心演进方向是:更丰富的数据源,以及更长、更精准的上下文处理能力。这将决定模型是否能胜任更复杂、更个性化的任务。
栏目组:从系统层面看,接下来一到两年,AI Infra 的重点演进方向会在哪些环节?
袁进辉:我觉得有几个方面值得关注。
第一,训练和推理的边界正在被打破。原来是先 Pre-training,再 Post-training,最后是 Inference,各阶段是分离的。现在很多 RL 的 Post-training 环节,其实已经让训练和推理同时在一个系统里执行了。
第二,软硬件深度协同。未来可能会出现一些专门跑 Transformer 的芯片,成本更低、效率更高。这时系统层就需要重新设计:算法、软件、硬件三者协同,成为必须解决的问题。
第三,推理算力的分布式部署。未来很多推理任务可能需要部署在离用户更近的地方。
栏目组:最后一个问题,从更长期的视角看,三年后您希望硅基流动在行业中扮演一个什么样的角色?
袁进辉:我希望硅基一直在解决行业的痛点问题里发挥比较关键的作用。
比如,在 AI 能力还不够成熟的阶段,我们帮助开发者降低上手门槛,提高迭代效率;在国产算力逐渐普及的过程中,我们帮助用户把国产芯片用得更好;在 AI 推理越来越规范化、精细化的背景下,我们能把每个 Token 生产的成本进一步降下来。
/ END /
来源 | 阿里云开发者公众号
作者 |