本文较长,建议点赞收藏,以免遗失。由于文章篇幅有限,更多有关内容细节技术知识点,我会在文章中标注额外分享给大家,粉丝朋友自行领取。
前言
在人工智能的浪潮中,大型语言模型(LLM)已成为推动产业变革的核心引擎。作为AI应用开发工程师,理解大模型的内在机制和开发范式至关重要。本文将从零开始,系统拆解LLM的核心技术栈,结合工程实践案例,助您掌握从模型选型到部署优化的全流程。无论您是初学者还是资深开发者,都能从中获得实战洞见。
一、基础概念:构建智能系统的基石
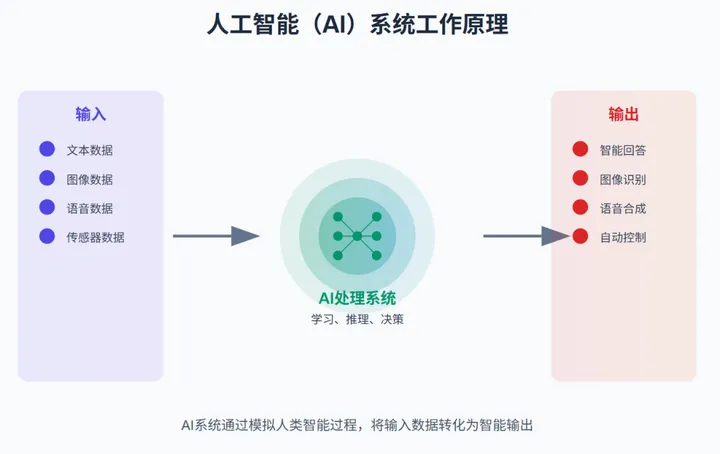
AI大模型的开发始于基础概念。人工智能(AI)是计算机科学的分支,旨在创建能执行人类智能任务的系统,如感知环境、处理数据和自主决策。现代AI系统已从规则引擎进化到基于深度学习的神经网络,其核心目标是开发在复杂环境中高效运行的智能体。
通用人工智能(AGI)是终极愿景,它追求跨领域学习和创造性思维。当前AI多为专用系统(如GPT-4处理语言),而AGI需具备人类级的认知灵活性。开发中,我们常面临复杂系统的挑战——系统由海量组件(如神经网络参数)非线性交互而成,微小输入变化可能导致输出剧变。例如,交通系统或LLM的参数节点网络均属此类。
涌现能力是LLM的魔力所在:当模型规模(参数、数据或计算量)超越临界点(如千亿参数),会“突变”出新能力,如多步推理或代码生成。这源于自然界的涌现规律——单一组件简单,但整体规模达阈值时,诞生全新属性。工程师需利用规模法则(Scaling Laws),它描述性能随资源增长的幂律关系,指导资源配置(如优先扩大数据集)。
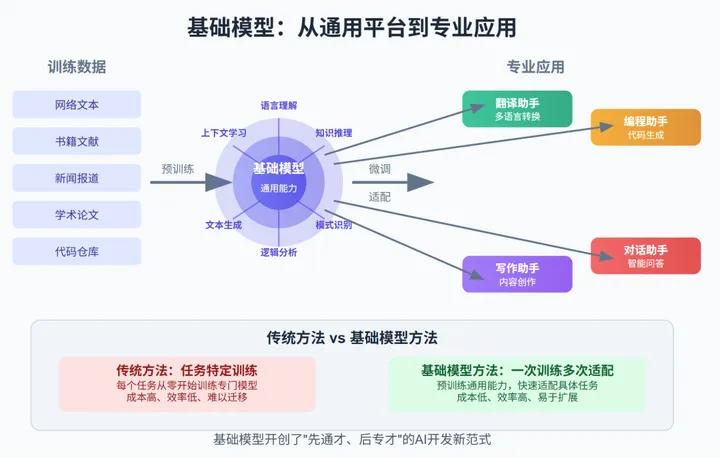
世界模型是AI对现实规律的内在理解,如物理定律或社会规范。当前LLM仅通过文本Token概率模拟思维,距离真正世界模型尚远。基础模型(如BERT或GPT系列)则是预训练的通用底座,通过微调适配下游任务,大幅降低开发门槛。LLM与基础模型常互换使用,但前者强调参数量级(十亿至万亿级),后者侧重通用性。
二、模型架构:工程效率的引擎
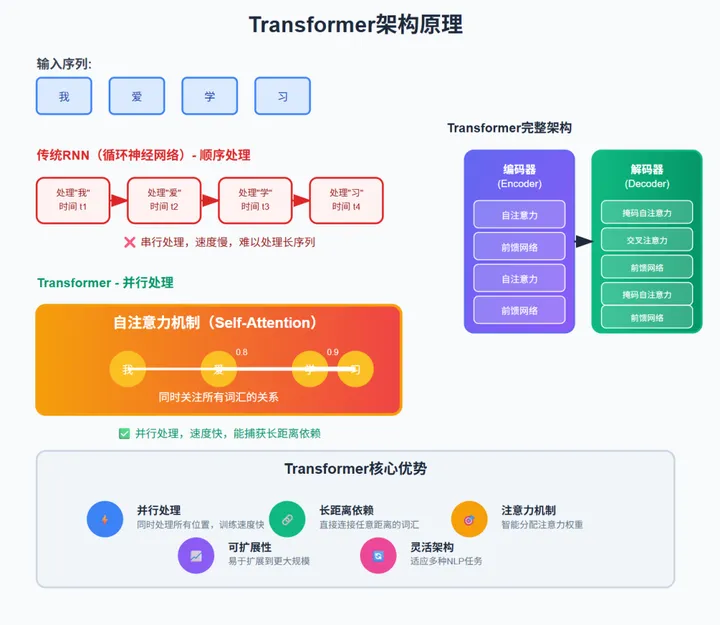
模型架构决定了LLM的性能上限和计算效率。Transformer架构是基石,由谷歌2017年提出,取代了RNN的序列处理瓶颈。其核心是自注意力机制——并行计算序列中所有位置的依赖关系,通过查询(Query)、键(Key)、值(Value)向量动态分配权重。这使模型高效处理长文本(如代码或文档),并在NLP和CV领域广泛应用。
混合专家模型(MoE)是近年突破,通过稀疏激活提升效率。MoE包含多个子网络(“专家”)和门控网络,对每个输入仅激活部分专家。例如,DeepSeek-V2使用MoE实现万亿参数规模,而计算成本仅等效于百亿级稠密模型。工程中,MoE适合高并发场景(如实时翻译),但需优化专家负载均衡。
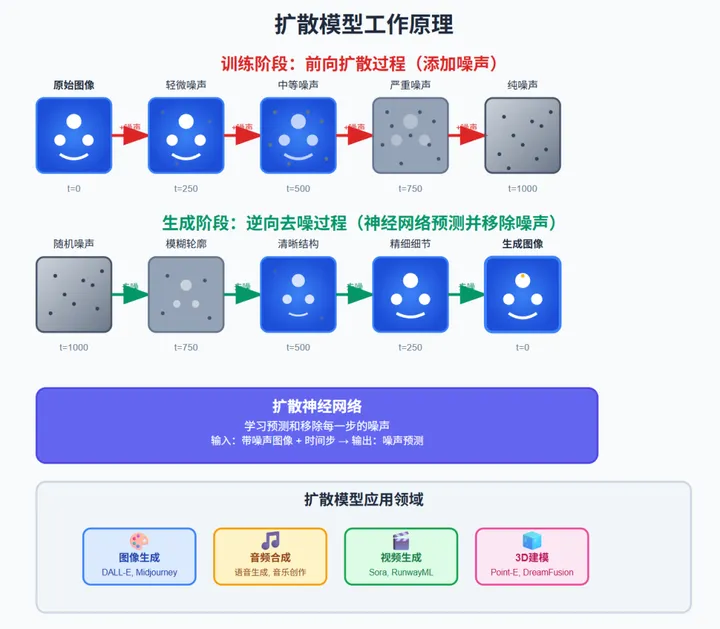
扩散模型则在生成式AI中领跑,如图像合成(Stable Diffusion)或音频生成。它通过噪声扩散和逆过程学习数据分布:训练时逐步添加噪声,生成时从随机噪声重建有序数据。扩散模型的稳定性和多样性使其在AIGC工具链中不可替代。
三、关键技术:从数据到推理的管道
开发流程中,关键技术确保数据高效转化为智能输出。Token分词是NLP预处理核心,将文本切分为子词单元(如BPE算法),平衡词汇表大小和未知词处理。工程师需选对分词器(如Hugging Face的Tokenizer库),否则影响模型性能。
词嵌入为文本赋予数学意义,将词语映射为稠密向量(如Word2Vec或GloVe)。语义相近词在向量空间邻近,使模型能计算“国王-男人+女人≈女王”的关系。嵌入层是LLM的输入接口,优化嵌入维度可提升推理速度。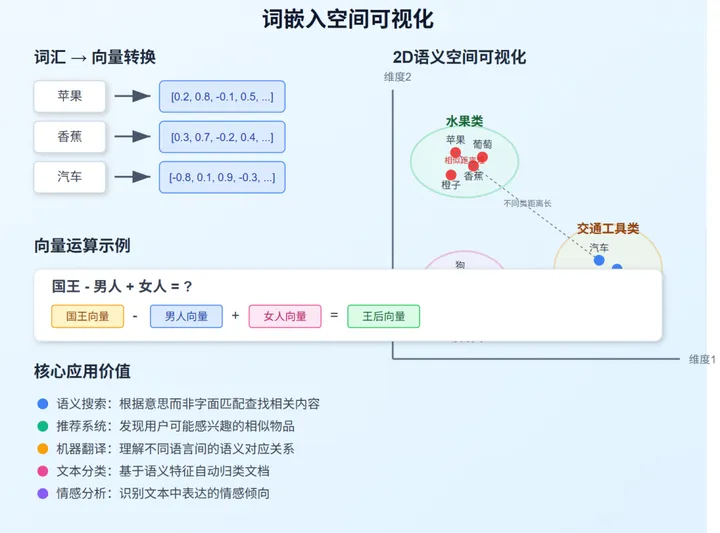
参数是模型的可学习变量(如权重矩阵),通过梯度下降优化。参数量直接决定容量——GPT-4的1.8万亿参数支持复杂推理,但需权衡训练成本。上下文长度(如Claude-3的200K tokens)是另一关键指标,影响长文档处理能力。工程中,扩展上下文需优化内存(如FlashAttention-2技术)。
自注意力机制是Transformer的灵魂,其并行性和全局视野使模型“理解”上下文关联。实际开发中,工程师需监控注意力头分布,防止信息冗余。
四、训练方法:高效学习的科学
训练是模型能力的源泉。预训练在大规模无标数据(如Common Crawl)上进行自监督学习,模型通过预测下一个Token学习语言规律。高质量预训练(如LLaMA-2使用2T tokens)奠定基础能力,耗时数周至数月,需分布式计算优化。
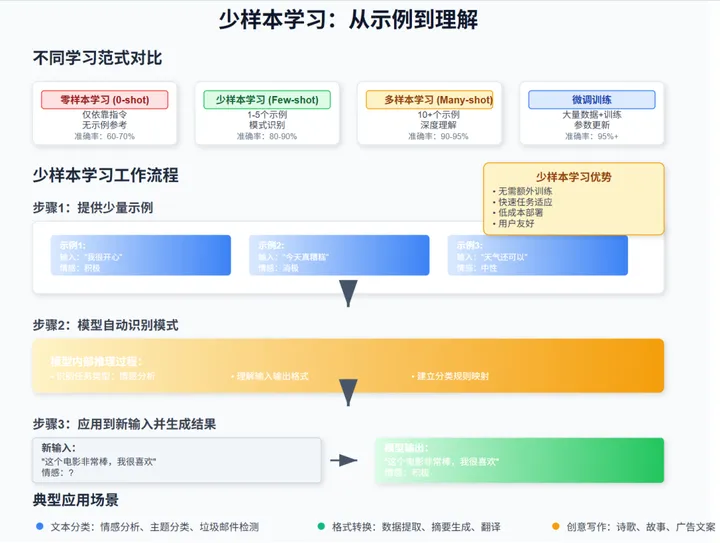
微调是应用落地的桥梁,用少量任务数据(如医疗问答对)调整预训练模型。工程师常用LoRA(低秩适配)技术,冻结主干、仅训练适配层,节省90%资源。少样本学习(Few-shot Learning)进一步降低需求——模型通过提示(Prompt)直接泛化到新任务,无需微调。
人类反馈强化学习(RLHF)对齐模型与人类价值观。先训练奖励模型(Reward Model)预测人类偏好,再用PPO算法优化LLM输出。RLHF是ChatGPT类产品的核心,但工程中需防范奖励黑客(Reward Hacking)——模型钻规则漏洞生成空洞内容。
ps:我这里还有一份《大模型微调实战项目思维导图》,粉丝朋友自行领取。
五、应用策略:从提示到智能体
部署阶段,策略决定用户体验。提示工程(Prompt Engineering)是基础交互技巧,通过结构化指令(如角色设定、示例)引导模型输出。工程师常用Chain-of-Thought提示,要求模型“逐步推理”,提升复杂问题准确率。
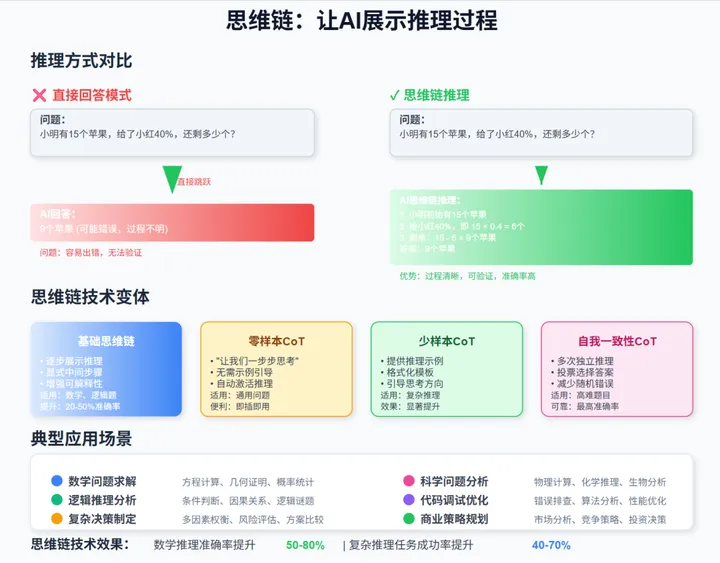
检索增强生成(RAG)解决知识陈旧问题,结合外部知识库(如向量数据库)实时检索上下文。例如,客服Bot用RAG调用产品文档生成精准回答。向量数据库(如Pinecone)是RAG基础设施,存储高维嵌入,支持语义相似性检索。
关于RAG检索增强的相关知识点,我整理了一个更详细的技术文档, 粉丝朋友自行领取:《检索增强生成(RAG)》
AI智能体(Agent)是终极应用形态,具备规划、工具调用和学习能力。如AutoGPT能分解任务、调用API完成项目。开发中,智能体性能依赖底层LLM能力,工程师需封装工具链(如LangChain框架)提升鲁棒性。
六、评估优化:性能与效率的平衡
上线前,评估确保模型可靠。基准测试(如MMLU或HumanEval)量化语言理解、代码生成等能力。工程师需在多样数据集测试,避免过拟合。
困惑度(Perplexity)衡量预测不确定性,值越低表示语言建模越准。训练中监控困惑度下降可判断收敛。
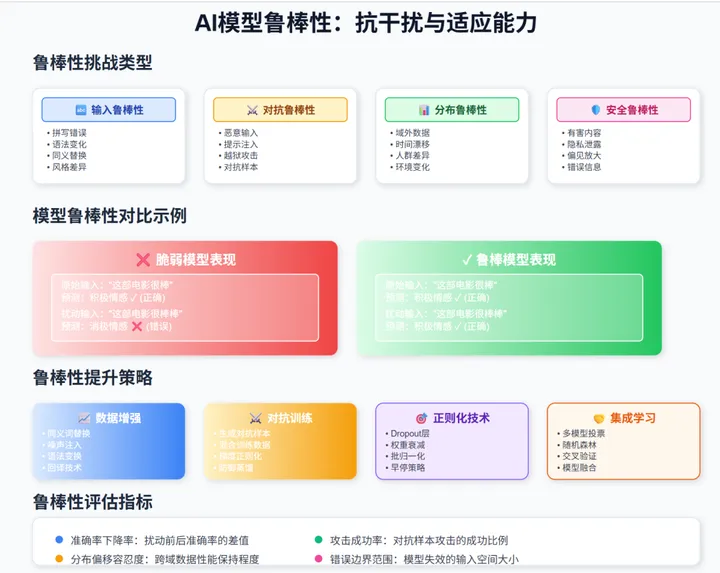
鲁棒性指模型抗干扰能力(如输入噪声或对抗样本)。工程中,数据增强(如文本扰动)和对抗训练可提升鲁棒性。
量化是部署优化的利器,将FP32参数转为INT8或FP16,减少内存和延迟。工程师常用QAT(量化感知训练)或PTQ(训练后量化),在GPU边缘设备(如手机)实现实时推理。
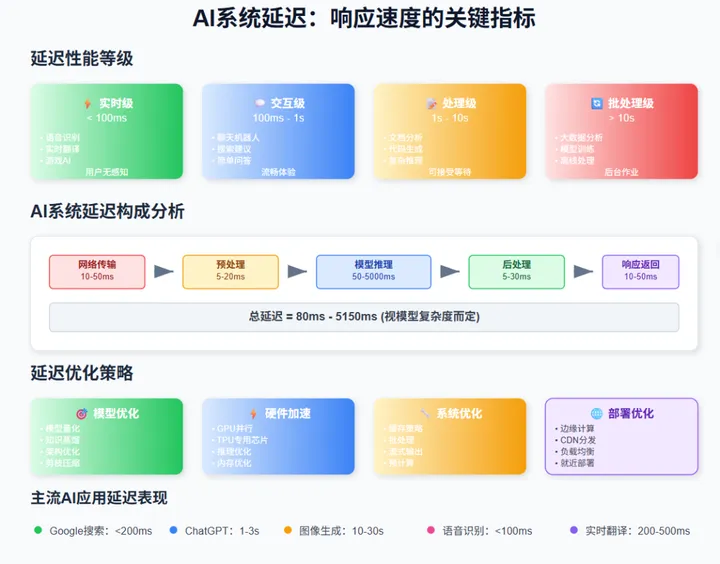
延迟是关键用户体验指标,从输入到输出的响应时间。优化技巧包括模型蒸馏(Distillation)、批处理(Batching)和硬件加速(如TensorRT)。
七、伦理安全:负责任的AI实践
伦理是开发红线。幻觉(Hallucination)指模型生成虚假信息,源于训练噪声或推理缺陷。工程中,RAG和事实核查模块可缓解此问题。
偏见(Bias)是数据偏差的产物,如性别或种族歧视。缓解方案包括数据脱敏、公平性约束(如AIF360工具包)。
对齐(Alignment)确保模型行为符合人类期望,RLHF和红队测试(Red Teaming)是关键手段。红队测试模拟攻击(如越狱提示),暴露安全漏洞。
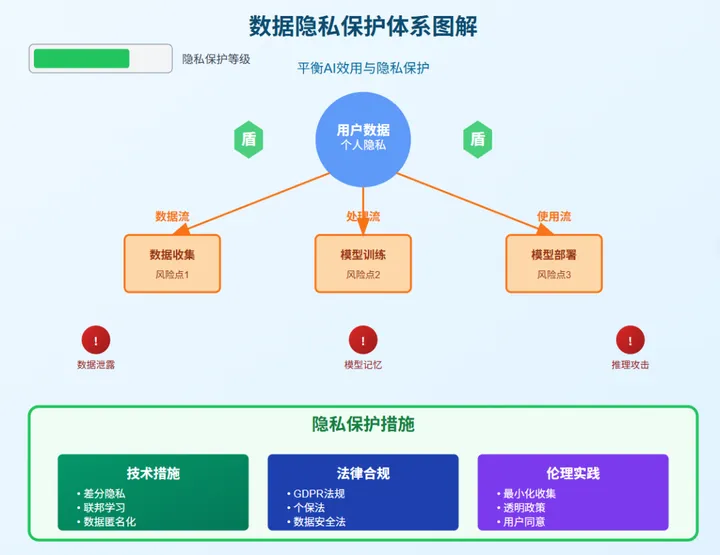
可解释性AI(XAI)用LIME或SHAP技术可视化决策逻辑,增强透明度。数据隐私则需差分隐私或联邦学习,满足GDPR合规。
结语:
AI大模型开发是系统工程,需平衡创新与伦理。未来趋势包括多模态融合(文本+图像)、边缘AI部署和AGI路径探索。如果你想成为一名合格的AI大模型应用开发工程师,我们应掌握全栈技能——从架构设计到提示优化,用技术赋能产业变革。记住:模型是工具,人才是核心。
如果本次分享对你有所帮助,记得告诉身边有需要的朋友,"我们正在经历的不仅是技术迭代,而是认知革命。当人类智慧与机器智能形成共生关系,文明的火种将在新的维度延续。"在这场波澜壮阔的文明跃迁中,主动拥抱AI时代,就是掌握打开新纪元之门的密钥,让每个人都能在智能化的星辰大海中,找到属于自己的航向。