《长文本处理新曙光:深入剖析多头隐式注意力机制显存优化奥秘》

简介: Transformer架构在自然语言处理等领域带来革命性变革,但其多头注意力机制(MHA)在处理长文本时显存占用呈几何级数增长,限制了应用。为此,多头隐式注意力机制(MLA)应运而生。MLA通过低秩联合压缩键值矩阵,将高维矩阵映射到低维潜在空间,显著减少显存占用,同时保持语义完整性。这使得长文本处理任务如文档翻译、知识库问答等在资源有限的硬件环境下也能高效运行。MLA结合分布式推理技术,进一步提升系统性能,未来有望在医疗、金融等领域发挥重要作用。

在人工智能领域,Transformer架构无疑是璀璨的明星,为自然语言处理、计算机视觉等众多领域带来了革命性的变革。但Transformer架构在处理长文本时,其多头注意力机制(MHA)会产生显存占用呈几何级数增长的问题,严重制约了模型在长文本场景下的应用。此时,多头隐式注意力机制(MLA)应运而生,为长文本处理的显存占用优化带来了新的希望。

传统多头注意力机制:长文本处理的困境

传统的多头注意力机制通过多个注意力头并行计算,从不同角度捕捉输入序列中的语义关联。在实际运行中,每个注意力头在处理每一个时间步(token)时,都需要保存之前所有时间步的键(Key)和值(Value)矩阵,这些矩阵构成了键值缓存(KV Cache)。随着输入文本长度的增加,KV Cache的大小线性增长。在一些超长文本处理任务中,如文档级别的机器翻译、大型知识库问答等,显存可能会被迅速耗尽,导致模型无法正常运行,这就像一辆载货能力有限的卡车,却要装载不断增多的货物,最终不堪重负。

为了缓解这一问题,研究者们提出了多种优化方法,如多查询注意力(MQA)和分组查询注意力(GQA)。MQA减少了注意力头之间的冗余计算,但牺牲了模型捕捉复杂语义关系的能力;GQA虽然在一定程度上降低了显存占用,却以牺牲模型性能为代价,这些方法就像是在性能和效率之间做着艰难的妥协,始终无法找到一个完美的平衡点。

MLA:长文本处理的显存优化利器

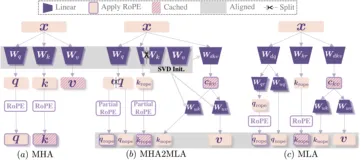
MLA是一种旨在解决传统多头注意力机制显存占用问题的创新技术。它的核心原理是对键值矩阵进行低秩联合压缩,通过这种方式,将高维的键值矩阵映射到低维的潜在空间,从而大大减少了KV Cache的存储需求。这就好比将一幅高清的大尺寸图像,通过特殊的压缩算法,转化为一幅尺寸小但关键信息不丢失的缩略图,在需要时还能根据缩略图恢复出原始图像的大致内容。

具体来说,MLA首先将原始的高维键值矩阵通过低秩矩阵分解,投影到低维的潜在向量空间。在这个低维空间中,计算注意力得分并生成压缩后的潜在向量。当需要使用键值信息时,再根据任务需求,动态地将潜在向量重构为原始维度,以保证语义的完整性。在推理阶段,MLA采用FP8混合精度框架,对键值矩阵使用低精度(如E4M3格式)存储,而对查询(Query)矩阵保留高精度(FP16)。这样的设计不仅减少了显存占用,还避免了量化误差的累积,就像在保证计算准确性的同时,巧妙地节省了存储空间。

MLA的工程实践与挑战应对

在工程实践中,MLA的优势得到了充分体现。以实际的长文本生成任务为例,使用传统的多头注意力机制,在处理长度为10000个token的文本时,可能需要占用数十GB的显存,而采用MLA后,显存占用可以降低80%以上,这使得模型能够在资源有限的硬件环境下处理更长的文本。在分布式推理场景中,结合流水线并行(PP)和专家并行(EP)技术,MLA实现了计算与通信的高度重叠,将长序列处理的吞吐量提升了3倍以上,大大提高了系统的整体性能。

但MLA在工程实现中也面临一些挑战。例如,在低秩矩阵分解过程中,如何选择合适的低维空间维度,以平衡显存压缩效果和模型性能,这需要通过大量的实验和理论分析来确定。不同的任务和数据集可能需要不同的低维空间设置,就像为不同身材的人量身定制衣服一样,需要精准匹配。在动态重构潜在向量时,如何保证重构的准确性和高效性,也是需要解决的问题。为了应对这些挑战,研究人员不断优化算法,结合深度学习的自适应学习能力,使MLA能够根据不同的任务和数据特征自动调整参数,提高模型的鲁棒性和适应性。

随着技术的不断发展,MLA有望在更多领域得到应用和拓展。在医疗领域,处理海量的病历文本和医学文献时,MLA能够帮助模型更高效地提取关键信息,辅助医生进行诊断和研究;在金融领域,分析大量的金融报告和市场数据时,MLA可以快速准确地捕捉市场趋势和风险信号。未来,MLA还可能与其他新兴技术相结合,如量子计算、联邦学习等,进一步提升其性能和应用范围,为人工智能的发展注入新的活力。
相关文章
|
安全 网络安全 数据安全/隐私保护
网站为何会显示“不安全”?又该怎么办呢?
这篇文章概述了导致网站显示为“不安全”的常见原因,并提供了相应的解释和建议。了解这些信息对于网站管理员和普通用户都是重要的,因为它有助于提高网络安全意识和保护个人信息不被泄露。
5643 0
|
监控 安全 JavaScript
【web渗透思路】框架敏感信息泄露(特点、目录、配置)
1481 0
【web渗透思路】框架敏感信息泄露(特点、目录、配置)
|
存储 缓存 NoSQL
阿里云 Tair 联手 SGLang 共建 HiCache,构建面向“智能体式推理”的缓存新范式
本文系统剖析面向智能体推理的 KVCache 技术演进,针对传统机制在长上下文、多轮决策与多智能体协同中的状态膨胀、持久化缺失和缓存孤立三大瓶颈,介绍阿里云 Tair KVCache 团队联合 SGLang 社区推出的 HiCache 分层缓存体系。该方案通过显存-内存-3FS 多级卸载与全局共享,实现缓存命中率提升至80%,TTFT 降低56%,推理 QPS 翻倍,支撑智能体时代的大模型高效推理。
|
4月前
|
机器学习/深度学习 人工智能 缓存
大模型应用:智能对话意图识别:基于关键词、语义向量与大模型的三重融合验证.120
本文系统梳理了智能体意图识别的演进路径与工业级落地实践,从关键词匹配、语义向量相似度计算到大模型精准验证,提出“规则+语义+大模型”三阶段集成方案,兼顾准确性、泛化性与可部署性,助力AI真正听懂用户真实诉求。
709 2
|
12月前
|
XML 数据格式 Python
从手动编辑到代码生成:Python 助你高效创建 Word 文档
本文介绍如何用Python实现Word文档自动化生成,结合python-docx、openpyxl和matplotlib库,高效完成报告撰写、数据插入与图表生成,大幅提升办公效率,降低格式错误,实现数据驱动的文档管理。
1437 2
|
机器学习/深度学习 人工智能 缓存
MHA2MLA:0.3%数据微调!复旦团队开源推理加速神器,KV缓存狂降96.87%
MHA2MLA是复旦大学、华东师范大学、上海AI Lab等机构联合推出的数据高效微调方法,通过引入多头潜在注意力机制(MLA),显著优化基于Transformer的LLM推理效率,降低推理成本。
760 1
MHA2MLA:0.3%数据微调!复旦团队开源推理加速神器,KV缓存狂降96.87%
一文吃透企业级elk技术栈:9. zabbix结合logstash告警
|
Ubuntu Linux Python
Tkinter错误笔记(一):tkinter.Button在linux下出现乱码
在Linux系统中,使用Tkinter库时可能会遇到中文显示乱码的问题,这通常是由于字体支持问题导致的,可以通过更换支持中文的字体来解决。
1370 0
Tkinter错误笔记(一):tkinter.Button在linux下出现乱码
|
机器学习/深度学习 存储 并行计算
大模型推理显存优化系列(3):FlowMLA——面向高吞吐的DP MLA零冗余显存优化
本文将介绍蚂蚁集团ASystem团队在推理显存优化上的新工作FlowMLA
|
机器学习/深度学习 人工智能 自然语言处理
《揭开DeepSeek神秘面纱:复杂逻辑推理背后的技术机制》
DeepSeek是一款基于Transformer架构的大语言模型,以其在复杂逻辑推理任务上的卓越表现成为行业焦点。它通过自注意力机制高效捕捉长距离依赖关系,结合强化学习优化推理策略,利用思维链技术拆解复杂问题,并经过多阶段训练与精调提升推理能力。此外,DeepSeek融合知识图谱和外部知识,拓宽推理边界,使其在处理专业领域问题时更加准确和全面。这些先进技术使DeepSeek能够像人类一样思考和推理,为解决复杂问题提供强大支持。
1296 11

热门文章

最新文章