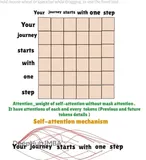
🎯 注意力机制详解

简介: 注意力机制是Transformer核心,实现动态信息聚焦。涵盖自注意力、交叉注意力及多头、分组、多查询等变体,平衡效率与性能。广泛应用于编码器-解码器、多模态融合等场景,是大模型设计与面试考察重点。

🎯 概述
注意力机制是Transformer架构的核心,允许模型在处理序列时动态地关注重要信息。
🏗️ 注意力机制类型
1️⃣ 自注意力机制 (Self-Attention, SA)
原理:序列中的每个元素关注序列中的其他所有元素
数学公式:
Self-Attention(X)=softmax(
d
k
​

​

XW
Q
​
(XW
K
​
)
T

​
)XW
V
​

代码示例:
2️⃣ 交叉注意力机制 (Cross-Attention, CA)
原理:一个序列关注另一个序列的信息
应用场景:
编码器-解码器架构
多模态融合
知识蒸馏
3️⃣ 多头注意力机制 (Multi-Head Attention, MHA)
原理:并行运行多个注意力头,捕获不同类型的关系
架构:
4️⃣ 分组注意力机制 (Grouped Query Attention, GQA)
原理:将查询头分组,每组共享键值头,平衡MHA和MQA
优势:
减少内存带宽需求
保持模型质量
推理加速
5️⃣ 多查询注意力机制 (Multi-Query Attention, MQA)
原理:所有查询头共享相同的键值头
特点:
显著减少内存带宽
推理速度提升
可能轻微影响质量
6️⃣ 多头潜在注意力 (Multi-Head Latent Attention, MLA)
原理:通过低秩投影减少键值缓存
DeepSeek创新:
低秩键值联合压缩
减少推理时KV缓存
保持表达能力
📊 注意力机制对比
机制
参数量
内存占用
推理速度
质量
MHA
高
高
慢
高
GQA
中
中
中
高
MQA
低
低
快
中
MLA
低
极低
快
高
🎯 面试重点
高频问题
自注意力和交叉注意力的区别?
为什么需要多头注意力?
GQA和MQA的权衡?
如何计算注意力权重?
注意力机制的时间和空间复杂度?
实战分析
1
2
3
4
5
6
7

计算注意力复杂度

def attention_complexity(seq_len, d_model, n_heads):

# 计算注意力矩阵: O(n²d)
# 存储KV缓存: O(nhd)
time_complexity = seq_len * seq_len * d_model
space_complexity = seq_len * n_heads * (d_model // n_heads)
return time_complexity, space_complexity

📚 深入阅读
Transformer基础结构
位置编码详解
[主流大模型结构](

相关文章
|
9月前
|
机器学习/深度学习 缓存 自然语言处理
注意力机制详解
注意力机制是Transformer核心,实现动态信息聚焦。涵盖自注意力、交叉注意力、多头(MHA)、分组(GQA)、多查询(MQA)及潜在注意力(MLA),在参数量、速度与质量间权衡。广泛应用于NLP与多模态任务,面试常考其原理与复杂度。
|
9月前
|
机器学习/深度学习 自然语言处理 网络架构
Transformer基础结构
Transformer是Vaswani等人于2017年提出的基于注意力机制的神经网络架构,摒弃了传统RNN,实现并行化处理,显著提升自然语言处理性能。其核心为编码器-解码器结构,通过自注意力机制捕捉长距离依赖,结合位置编码、残差连接与层归一化,有效训练深层模型。多头注意力机制增强特征表达能力,广泛应用于机器翻译、文本生成等任务,成为现代大模型基石。
|
10月前
|
机器学习/深度学习 人工智能 并行计算
Transformer的核心:自注意力机制
自注意力机制是Transformer的核心,让序列中每个元素直接关联所有其他元素,实现全局信息交互。相比RNN的顺序处理和CNN的局部感知,它能并行计算、捕捉长距离依赖,并提供可解释的权重分布,彻底改变了序列建模方式,成为大模型崛起的关键基石。(239字)
|
11月前
|
机器学习/深度学习 缓存 监控
139_剪枝优化:稀疏模型压缩 - 分析结构化剪枝的独特速度提升与LLM部署加速实践
随着大语言模型(LLM)规模的不断增长,模型参数量已从最初的数亿扩展到数千亿甚至万亿级别。这种规模的模型在推理过程中面临着巨大的计算和内存挑战,即使在最先进的硬件上也难以高效部署。剪枝优化作为一种有效的模型压缩技术,通过移除冗余或不重要的参数,在保持模型性能的同时显著减少计算资源需求。
1419 139
|
9月前
|
存储 数据采集 算法
具身智能:零基础入门睿尔曼机械臂(六)——手眼标定代码库详解,从原理到实践
本文详解睿尔曼手眼标定代码库,涵盖眼在手上与眼在手外两种模式的实现原理及核心代码解析。内容包括数据采集、位姿处理、相机标定与手眼矩阵求解全流程,结合OpenCV的Tsai算法实现高精度坐标转换,助力机器人视觉精准抓取应用开发。
1259 3
|
机器学习/深度学习 自然语言处理 PyTorch
Transformer自回归关键技术:掩码注意力原理与PyTorch完整实现
掩码注意力是生成模型的核心,通过上三角掩码限制模型仅关注当前及之前token,确保自回归因果性。相比BERT的双向注意力,它实现单向生成,是GPT等模型逐词预测的关键机制,核心仅需一步`masked_fill_`操作。
919 0
Transformer自回归关键技术:掩码注意力原理与PyTorch完整实现
|
监控 算法 自动驾驶
软件体系结构 - 调度算法(1) 最早截至时间优先
【4月更文挑战第19天】软件体系结构 - 调度算法(1) 最早截至时间优先
1602 0
|
机器学习/深度学习 人工智能 算法
DeepSeek技术报告解析:为什么DeepSeek-R1 可以用低成本训练出高效的模型
DeepSeek-R1 通过创新的训练策略实现了显著的成本降低,同时保持了卓越的模型性能。本文将详细分析其核心训练方法。
1717 11
DeepSeek技术报告解析:为什么DeepSeek-R1 可以用低成本训练出高效的模型
|
人工智能 自然语言处理 API
用自然语言控制电脑,字节跳动开源 UI-TARS 的桌面版应用!内附详细的安装和配置教程
UI-TARS Desktop 是一款基于视觉语言模型的 GUI 代理应用,支持通过自然语言控制电脑操作,提供跨平台支持、实时反馈和精准的鼠标键盘控制。
7287 17
用自然语言控制电脑,字节跳动开源 UI-TARS 的桌面版应用!内附详细的安装和配置教程

热门文章

最新文章