YOLOv8目标检测创新改进与实战案例专栏
专栏目录: YOLOv8有效改进系列及项目实战目录 包含卷积,主干 注意力,检测头等创新机制 以及 各种目标检测分割项目实战案例
专栏链接: YOLOv8基础解析+创新改进+实战案例
介绍

摘要
视觉变换器(Vision Transformers,ViTs)已被证明在各种视觉任务中具有高效性。然而,将其缩小到移动设备友好的尺寸会导致性能显著下降。因此,开发轻量级视觉变换器成为了一个重要的研究方向。本文介绍了CloFormer,这是一种利用上下文感知局部增强的轻量级视觉变换器。CloFormer探讨了在传统卷积操作中常用的全局共享权重与在注意力机制中出现的特定于token的上下文感知权重之间的关系,并提出了一种高效且简单的模块来捕获高频局部信息。在CloFormer中,我们引入了AttnConv,一种在注意力风格下的卷积操作。提出的AttnConv使用共享权重来聚合局部信息,并部署精心设计的上下文感知权重来增强局部特征。AttnConv与使用池化来减少CloFormer中FLOPs的传统注意力相结合,使模型能够感知高频和低频信息。在图像分类、目标检测和语义分割中的大量实验表明了CloFormer的优越性。
文章链接
论文地址:论文地址
代码地址:代码地址
基本原理
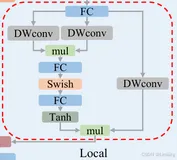
AttnConv是CloFormer中引入的一种卷积操作符,它采用了注意力机制的风格。所提出的 AttnConv 有效地融合了共享权重和上下文感知权重,以聚合高频的局部信息。具体地,AttnConv 首先使用深度卷积(DWconv)提取局部表示,其中 DWconv 具有共享权重。然后,其使用上下文感知权重来增强局部特征。与 Non-Local 等生成上下文感知权重的方法不同,AttnConv 使用门控机制生成上下文感知权重,引入了比常用的注意力机制更强的非线性。此外,AttnConv 将卷积算子应用于 Query 和 Key 以聚合局部信息,然后计算 Q 和 K 的哈达玛积,并对结果进行一系列线性或非线性变换,生成范围在 [-1,1] 之间的上下文感知权重。值得注意的是,AttnConv 继承了卷积的平移等变性,因为它的所有操作都基于卷积。具体公式如下:

最后,将全局特征和局部特征合并起来,并使用一个MLP得到最终的输出。公式表示如下:

AttnConv的操作流程:
首先,通过线性变换得到Q、K和V,这一步与标准的注意力机制相同。
接着,在V上使用共享权重(DWconv)进行信息聚合,利用深度卷积提取局部表示。
然后,利用比传统注意力机制更强的非线性方法生成上下文感知权重,用这些权重增强局部特征。

AttnConv的技术原理:
- AttnConv通过引入共享权重和上下文感知权重来提取高频局部信息。
- 使用深度卷积(DWconv)提取局部表示,再利用上下文感知权重增强局部特征。
- 与以往通过局部自注意力生成上下文感知权重的方法不同,AttnConv通过门控机制生成上下文感知权重,引入了比常用注意力机制更强的非线性。
- AttnConv对Q和K应用卷积操作来聚合局部信息,然后计算Q和K的哈达玛积,并对结果进行一系列线性或非线性变换,生成范围在[-1, 1]内的上下文感知权重。
- AttnConv保留了卷积的平移等变性特性,因为其所有操作都基于卷积。
核心代码
import torch
import torch.nn as nn
import torch.nn.functional as F
from timm.models.layers import DropPath
from typing import List
from efficientnet_pytorch.model import MemoryEfficientSwish

class AttnMap(nn.Module):
    def __init__(self, dim):
        super().__init__()
        self.act_block = nn.Sequential(
                            nn.Conv2d(dim, dim, 1, 1, 0),
                            MemoryEfficientSwish(),
                            nn.Conv2d(dim, dim, 1, 1, 0)
                            #nn.Identity()
                         )
    def forward(self, x):
        return self.act_block(x)

class EfficientAttention(nn.Module):

    def __init__(self, dim, num_heads, group_split: List[int], kernel_sizes: List[int], window_size=7,
                 attn_drop=0., proj_drop=0., qkv_bias=True):
        super().__init__()
        assert sum(group_split) == num_heads
        assert len(kernel_sizes) + 1 == len(group_split)
        self.dim = dim
        self.num_heads = num_heads
        self.dim_head = dim // num_heads
        self.scalor = self.dim_head ** -0.5
        self.kernel_sizes = kernel_sizes
        self.window_size = window_size
        self.group_split = group_split
        convs = []
        act_blocks = []
        qkvs = []
        #projs = []
        for i in range(len(kernel_sizes)):
            kernel_size = kernel_sizes[i]
            group_head = group_split[i]
            if group_head == 0:
                continue
            convs.append(nn.Conv2d(3*self.dim_head*group_head, 3*self.dim_head*group_head, kernel_size,
                         1, kernel_size//2, groups=3*self.dim_head*group_head))
            act_blocks.append(AttnMap(self.dim_head*group_head))
            qkvs.append(nn.Conv2d(dim, 3*group_head*self.dim_head, 1, 1, 0, bias=qkv_bias))
            #projs.append(nn.Linear(group_head*self.dim_head, group_head*self.dim_head, bias=qkv_bias))
        if group_split[-1] != 0:
            self.global_q = nn.Conv2d(dim, group_split[-1]*self.dim_head, 1, 1, 0, bias=qkv_bias)
            self.global_kv = nn.Conv2d(dim, group_split[-1]*self.dim_head*2, 1, 1, 0, bias=qkv_bias)
            #self.global_proj = nn.Linear(group_split[-1]*self.dim_head, group_split[-1]*self.dim_head, bias=qkv_bias)
            self.avgpool = nn.AvgPool2d(window_size, window_size) if window_size!=1 else nn.Identity()

        self.convs = nn.ModuleList(convs)
        self.act_blocks = nn.ModuleList(act_blocks)
        self.qkvs = nn.ModuleList(qkvs)
        self.proj = nn.Conv2d(dim, dim, 1, 1, 0, bias=qkv_bias)
        self.attn_drop = nn.Dropout(attn_drop)
        self.proj_drop = nn.Dropout(proj_drop)

    def high_fre_attntion(self, x: torch.Tensor, to_qkv: nn.Module, mixer: nn.Module, attn_block: nn.Module):
        '''
        x: (b c h w)
        '''
        b, c, h, w = x.size()
        qkv = to_qkv(x) #(b (3 m d) h w)
        qkv = mixer(qkv).reshape(b, 3, -1, h, w).transpose(0, 1).contiguous() #(3 b (m d) h w)
        q, k, v = qkv #(b (m d) h w)
        attn = attn_block(q.mul(k)).mul(self.scalor)
        attn = self.attn_drop(torch.tanh(attn))
        res = attn.mul(v) #(b (m d) h w)
        return res

    def low_fre_attention(self, x : torch.Tensor, to_q: nn.Module, to_kv: nn.Module, avgpool: nn.Module):
        '''
        x: (b c h w)
        '''
        b, c, h, w = x.size()

        q = to_q(x).reshape(b, -1, self.dim_head, h*w).transpose(-1, -2).contiguous() #(b m (h w) d)
        kv = avgpool(x) #(b c h w)
        kv = to_kv(kv).view(b, 2, -1, self.dim_head, (h*w)//(self.window_size**2)).permute(1, 0, 2, 4, 3).contiguous() #(2 b m (H W) d)
        k, v = kv #(b m (H W) d)
        attn = self.scalor * q @ k.transpose(-1, -2) #(b m (h w) (H W))
        attn = self.attn_drop(attn.softmax(dim=-1))
        res = attn @ v #(b m (h w) d)
        res = res.transpose(2, 3).reshape(b, -1, h, w).contiguous()
        return res

    def forward(self, x: torch.Tensor):
        '''
        x: (b c h w)
        '''
        res = []
        for i in range(len(self.kernel_sizes)):
            if self.group_split[i] == 0:
                continue
            res.append(self.high_fre_attntion(x, self.qkvs[i], self.convs[i], self.act_blocks[i]))
        if self.group_split[-1] != 0:
            res.append(self.low_fre_attention(x, self.global_q, self.global_kv, self.avgpool))
        return self.proj_drop(self.proj(torch.cat(res, dim=1)))
task与yaml配置
详见:https://blog.csdn.net/shangyanaf/article/details/139824105