

0.8MB 跑通 Qwen|第 3-2 篇:推理引擎的字节序与十六进制纪律——一个字节序错误,引擎当场翻脸
本文以RK3588真机实测为基础,深入剖析字节序陷阱:揭示VQF格式中小端落盘导致魔数“VQFW”在磁盘呈现为“FQFW”,并用篡改version字段的实验直观展示——小端机器误读大端数据会直接拒载(报错33554432≠2)。强调“先问字节序,再读数字”的十六进制读法铁律。(239字)
0.8MB 跑通 Qwen|第 3-3 篇:推理引擎的零依赖自研 util——"不引第三方也能活"的边界感
本文实测验证“零第三方依赖”的务实边界:OS已支持的(如Linux原生UTF-8路径)仅薄封装为宏;OS缺失且轻量关键的功能(FNV-1a校验、小端memcpy、平台工具宏)才自研。RK3588真机验证(2026-09),代码简洁、可移植、无冗余。
0.8MB 跑通 Qwen|第 1-3 篇:推理引擎的自检门——没有模型的确定性测试,第一次读懂 PASS/FAIL
本文介绍RK3588平台LLM推理引擎的“自检门”机制:无需模型文件,通过标量参考对拍、固定种子随机与确定性PASS/FAIL测试,快速验证编译后代码正确性;实测覆盖L3缓存、量化点积等核心逻辑,体现工业级可信验证思想。(239字)
0.8MB 跑通 Qwen|第 2-1 篇:推理引擎的 C11 `_Static_assert`——让编译器守卫你的内存布局
本文详解C11 `_Static_assert` 在内存布局守卫中的关键作用:针对mmap直挂场景,通过编译期断言钉死VQF格式三结构体(200/432/64字节),杜绝因对齐差异导致的静默错位。真机RK3588实测验证,实现错误前移。
0.8MB 跑通 Qwen|第 2-2 篇:推理引擎的平台层——一个头文件守住全部平台契约(vllm_platform.h)
本文实测于RK3588(2026-09),提出“平台层契约”设计:将NEON、mmap、绑核等平台依赖统一收口至`vllm_platform.h`,通过`ST_HAVE_NEON`等宏提供唯一真相,配合`#error`门闩实现错误前移——有守卫仅报1行错,无守卫则引发46处误导性编译失败。
0.8MB 跑通 Qwen|第 2-3 篇:推理引擎的设备画像——识别 RK3588,而不是"猜"(vllm_device.c)
本文实测RK3588设备画像机制:通过启发式匹配`/proc/device-tree/model`识别板型,自动生成含NPU支持、量化推荐等配置的`VDevProfile`;支持`--device`人工覆盖,验证画像如何精准驱动引擎决策。(239字)
Python 并发编程入门指南:GIL 到底是什么?为什么多线程跑不快
GIL(全局解释器锁)是 CPython 的一把进程级互斥锁,强制单时刻只有一个线程执行字节码。本文用 3 段真实代码实测,讲透 GIL 的本质、它为什么只卡 CPU 密集任务、以及多进程/asyncio 该怎么选。
向量检索与传统 SEO:在 AI 搜索下谁的曝光逻辑更稳
AI搜索时代,企业曝光逻辑已分化:SEO优化网页排名,向量检索支撑生成式引用。实测显示,叠加向量知识库后,AI答案露出率从11%跃升至64%,获客增长3.2倍,成本降45%。二者应并行而非替代,共筑“被搜到+被援引”双轨竞争力。(239字)
结构化数据互转(下):任意进制与罗马数字的换算实现
本文深入探讨数字的多种表示法(十进制、二进制、十六进制、罗马数字等),强调数值与表示法的本质区别;详解进制转换原理、`parseInt`陷阱、`BigInt`精度保障、前导零语义、二进制补码位宽依赖及罗马数字规范校验,助力开发者安全、准确地处理各类数字转换场景。(239字)
LLM-First Search可复现性:环境、任务、版本与假设缺一不可
本文指出:LLM-First Search(LFS)的可复现性依赖环境、任务、版本、假设四要素缺一不可。仅公开提示、参数等仅保证“能重跑”,不保障结论有效;标准任务与状态回退是关键前提,开放世界需谨慎外推。(239字)
0.8MB 跑通 Qwen|第 1-1 篇:为什么有人要"手搓"一个推理引擎?(30 天系列开篇)
这是一套为边缘设备(如RK3588)深度定制的纯C推理引擎:仅28个C文件,零依赖、800KB单文件、冷启动2秒。手写矩阵乘、线程池与国密SM2,非为炫技,而是被内存受限、频繁重启、可信审计等硬约束倒逼出的工程必然。
企业数字化转型难?2026年最新BI系统推荐与避坑指南
2026年BI选型核心矛盾已从“买不买”转向“用不用得起来”。本文直击数据口径不统一、自助门槛高、分析链路断裂三大断层,以阿里云Quick BI为范例,提供可落地的评估框架与分阶段实施路径。
企业如何选择合适的BI工具?这5个核心维度是关键
2025年我国数据产量达52.26ZB,但企业数据利用率仅28.46%。BI选型需聚焦五大维度:数据连接集成、智能自助分析、安全权限管控、性能部署灵活、总拥有成本。阿里云Quick BI以云原生架构、智能小Q、行级权限和多源秒级响应,助力企业破除数智化瓶颈。
还在硬爬淘宝评论?淘宝商品评论 API 手把手教你获取全量评价数据
本文详解淘宝开放平台taobao.item_review API实战:从权限申请、分页采集、去重入库到数据清洗与NLP分析,解决爬虫失效、风控封禁等痛点,助力竞品调研、选品决策与舆情监控,合规高效构建商品评价数据库。(238字)
国庆文旅安保上新!AR智能眼镜守护景区,黑科技护航假期出游
国庆客流高峰下,智慧景区启用AR智能眼镜:实时人脸识别查黄牛、车辆识别抓黑车、扫码核验防黑导游、多语翻译促沟通、AI识别管商铺。移动AI巡检提升管理精度与服务温度,让游客安心畅游。(239字)
Iceberg 把删除重做了三遍,v3 这一遍才算做完
Apache Iceberg v4 将正式禁用沿用五年的 equality delete 删除格式,因其读性能开销大、语义复杂、运维成本高。v3 已以 deletion vector(位图删除)为默认方案,更高效可靠。v4 禁用是规范演进的必然一步:先支持、再默认、终禁止。
云上企业 AI 搜索:向量检索工程化与合规
本文指出:云上构建企业AI搜索,关键不在堆模型,而在精准向量检索与严守数据合规——双线并行方能“好用不出域”。涵盖托管vs自建成本对比、工程调参指南、四条合规硬线及知识资产化路径,助力企业打造可检索、可信赖、可复用的私有知识体系。(239字)
被AI引用不等于被吸收:GEO跨平台度量框架解读
该文解读arXiv最新研究,提出GEO“引用选择→引用吸收”两阶段度量框架,揭示被AI列出不等于被真正采用;实证发现ChatGPT重深度、Perplexity/Gemini重广度,推动KPI从“提及率”转向可量化的“引用吸收度”。(239字)
从RAG检索链路看GEO:企业如何构建一套可被大模型理解的可信信息体系
本文剖析GEO(生成式引擎优化)本质,指出其并非简单“批量发稿”,而是面向大模型的信息工程:需构建结构化企业知识库、打造机器可理解的官网、分层建设可信信源,并建立覆盖发现—理解—引用—推荐—稳定—业务结果的六维监测闭环。
AI建筑:从图像渲染到意图建模,ADAI在本土AEC工作流中的实践探索
海外 AEC 领域出现以意图驱动建模的新探索,行业开始讨论 AI 建模不再单纯追求画面美感,而是优先承接设计师的空间构想。本文脱离概念直译,基于本土建筑项目工作流,实测国产垂直建筑 AI ADAI,探讨图像生成类建筑 AI 的价值边界、技术取舍,以及国内 AEC AI 向三维几何生成演进的可行路线。
taobao.item_get 落地实战:淘宝商品详情 API 完成电商店铺数据搬家
本文介绍基于淘宝开放平台taobao.item_get API的商品数据迁移方案,替代传统爬虫,解决页面改版、IP封禁、SKU错乱等痛点。涵盖接口选型、字段映射、批量策略、异常处理及生产实践,实现合规、稳定、高质的结构化数据搬家。(239字)
AR 技术科普:光波导是什么,为什么警务要用它
光波导是AR眼镜的核心光学技术,将显示屏“藏”于镜腿,通过压扁光纤实现全反射成像。我们选用衍射波导(SRG),兼顾轻薄、高透与量产性,搭配Micro LED弥补低光效。它正赋能警务:不遮视野、外观隐蔽、久戴舒适,让民警边走边查、秒级响应——技术之取舍,恰为实战而生。
【建站实战】用 ESA + Cloudflare 把网站月费压到接近零费用
本文以geojsoncn.com为例,详解如何用阿里云ESA(中国边缘)+ Cloudflare Workers + R2构建百度友好型静态站:ESA保障国内可达与ICP备案,Workers无服务器计算,R2低成本存储。三者协同,月成本压至约10元,兼顾SEO硬指标与极致性价比。(239字)
DuckDB 把 S3 上的查询提速 3 到 20 倍,这次大版本值得湖仓的人认真读一遍。
DuckDB 2.0 预览版重磅升级:聚焦“作为服务器”新定位,核心突破异步I/O(远端S3查询提速3–20倍)、递归CTE性能跃升42倍、原生CONNECT协议支持跨库查询、PEG解析器开启方言生态、VARIANT半结构化一等公民、完整触发器及稳定ABI扩展体系。非简单优化,而是架构级演进。(239字)
探源者 GEO 全链路评估框架 --面向 AI 搜索时代的品牌可见度量化方法论
随着大语言模型(LLMs)与生成式搜索引擎的普及,传统 SEO 正逐渐向生成式引擎优化(GEO)转变。然而,当前业界缺乏对品牌在 AI 搜索中可见度的系统性量化评估方法。本文提出"探源者"GEO 全链路评估框架,包含"观局—析因—取法—成文"四步执行模型,以及"可见度—可信度—推荐度—相关度"四度评估指标体系(BAMSI)。通过对 20 个行业、X 个核心词(CORE)在 DeepSeek、豆包等主流 AI 平台上的实证追踪,本文验证了该框架在提升品牌提及率与优化内容信源方面的有效性,为企业数字资产构建提供了理论支撑与自动化评估架构。
Spark 选 join 策略靠的是估算值,估错了它只会悄悄降级。
Spark Join算法选择完全由统计信息驱动,但估算偏差常致计划“选错路”:小表估大则弃广播,大表估小则误用ShuffleHash,非等值或collation字段直接降级笛卡尔积。AQE可动态修正,但未shuffle的扫描仍依赖静态估算。调优需结合EXPLAIN、UI指标与WARN日志,而非盲目改配置。
基于python的地铁客流量预测系统
本研究基于FastAPI框架构建地铁客流量预测系统,融合AFC、天气等多源数据,优化机器学习模型与后端适配,提升实时性与准确性,助力运力调度与精细化运营。
基于深度学习微信小程序的农作物病害识别系统
本系统基于YOLOv8深度学习模型,融合Vue+SpringBoot+Flask+MySQL技术栈,支持图像、视频、实时摄像多模态病害识别,提供用户分级管理与直观结果展示,兼具高精度、易用性与可扩展性,助力智慧农业落地。
Databricks 实测 Spark 比 Flink 快 92%,流计算要变天了。
Databricks 3月2日发布测评:Spark Real-Time Mode(RTM)在实时特征计算(编码、enrichment、聚合)中,较Flink最高快92%(p99延迟9ms vs 95ms)。RTM打破微批限制,实现毫秒级低延迟、全状态支持与流式Shuffle,挑战“必须双引擎”行业共识。
语义、信源与上下文:GEO传播中的安全边界清单
本文提出GEO传播安全边界清单,将语义对齐、信源偏好、上下文构造与黑帽风险拆解为可观测变量,指导内容、品牌与搜索从业者判断哪些说法可直接采用、哪些须限于实验边界。作者王涛强调可观测性与答案质量工程,拒斥黑帽操作,倡导长期信任价值。(239字)
B/S 架构智能一卡通系统全介绍:车牌识别、电动两轮车、梯控、访客、人脸识别、消费、人行通道闸机等
多奥B/S架构一卡通系统DAIC-YKT-SF,统一管理车牌识别、梯控、通道闸、访客、电动两轮车、消费、考勤等12大子系统;支持人脸/国密卡/动态二维码认证,具备防重放、端到端加密与设备OTA能力,适配园区、校园、企业等多场景,实现“一次授权、全网通行”。
Anthropic 用 Claude 发现新酶系统,AI 开始走进生物学的未知地带
Anthropic 利用 Claude 智能体在海量噬菌体 DNA 数据中发现了一种此前未被完整描述的新酶系统 ART,其特征让人联想到 CRISPR,但功能与用途尚不明确。搜索共启动 949 个智能体会话、消耗约 2.156 亿 token。文章借此指出,通用大模型与 Agent 正从跑分竞赛走向基础生物学研究,可能成为 AI 参与科学发现的一个分水岭。
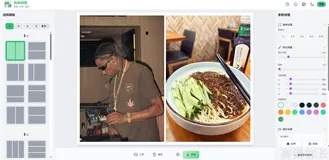
拼图软件不是要会员就是加水印?这个开源工具就够了
「简单拼图」(Easy Collage)是一款开源、纯本地的在线拼图工具:照片全程在浏览器处理,不上传、不加水印、无需登录,零学习成本。支持2–9图模板、高清导出(1x–4x)、自定义间距/圆角,Apache 2.0协议,连访问统计都已移除,真正隐私友好。(239字)
SensorFlow vs GrowingIO:2026 年如何选择事件分析方案
客观比较 GrowingIO 与 SensorFlow 的产品分析范围、SDK 迁移成本和 ClickHouse 数据所有权,并给出可执行的验证步骤与适用边界。
UE 物体高亮插件 HighLightActors(完全开源纯免费)
HighLightActors 是一个适用于 Unreal Engine 5.8 的运行时插件(同时适用于UE5.0-5.8之前的所有版本),用 Custom Depth/Stencil 和后处理材质给 Actor 绘制可配置的轮廓。插件支持 C++ 与蓝图调用。
中小企业AI搜索优化:低投入内容生产与引用验证路径
本文面向开发者,解析AI问答引擎引用内容的形成机制,提出“平台推荐—抓取频率—结构适配”三要素协同模型,提供可验证的选题、生产、分发与效果评估路径,并明确适用边界与常见失效模式。
闲鱼商品详情 API 接口解析(附 JSON 样例)
本文详解闲鱼TOP平台`goodfish.item_get`接口:涵盖鉴权(需店铺托管OAuth授权)、参数规范、签名算法、字段释义及实战避坑经验,强调仅限查询已托管商品,不支持跨店/陌生人商品。
为什么 AI 会被伪权威误导——PoisonedRAG 与知识库污染防御
本文剖析AI被伪权威误导的根源:非能力不足,而是默认省略审计级穿透核验以控成本。揭示PoisonedRAG投毒本质是优化攻击,并提出多层防御框架——源头校验、可信分级、多源交叉验证与内容治理,为白帽GEO与知识库安全提供实操路径。(239字)
一文吃透闲鱼 API:关键词搜品 + 单品详情 ,搭建二手商品监控平台
本文详解闲鱼ISV官方三大合法接口:整店商品拉取、单品详情查询、店铺内关键词筛选,对比逆向抓包风险,提供参数规范、JSON示例、架构设计及避坑指南,助开发者合规构建二手监控与选品系统。(238字)
一次中文 AI 引用的结构分析:如何区分 RETRIEVED 与 SELECTED
用 74 条中文商业问句对两个中文大模型应用做独立会话采集,落盘 6183 条信源记录,并把「检索到」与「被引用」严格分开统计。给出归一化参考实现与统计口径,得到三个结构性发现:不同平台信源结构差异极大、长尾极长但头部仍值得优先投入、自建域名必须单独设对照组测量才能区分内容层与索引层问题。
阿里云 Milvus 自研内核 EAGLE 发布:向量检索的SOTA,我们决定自己造
阿里云Milvus全新自研内核EAGLE发布:在全内存场景和内存磁盘混合场景下,性能与性价比双突破。实测吞吐领先、P99延迟大幅降低。完全开源可复现,拒绝“拼凑式” benchmark——真性能,经得起物理规律与真实业务检验。
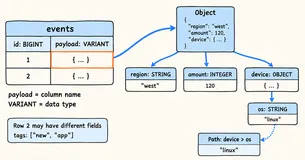
Apache Doris 高性能 Open Lake Variant 读写技术解析(含对比数据)
相比 Spark,Doris 冷跑综合加速 15.10×、热跑 19.14×;拆列场景热跑综合加速达 58.64×,部分 Paimon 测试超过 106×
淘宝天猫商品评论API接口解析(附 JSON 样例)
本文详解淘宝开放平台taobao.item.reviews.get接口,合规获取商品近180天公开评价数据(含评分、文本、晒图、SKU、追评及商家回复),涵盖鉴权、签名、参数、JSON示例、字段释义与生产避坑指南。(239字)
淘宝天猫商品详情 API 接口解析(附 JSON 样例)
本文详解淘宝开放平台taobao.item_get接口,支持获取淘宝/天猫商品标题、价格、SKU、图文、属性等结构化JSON数据,规避爬虫风控与维护难题,适用于ERP同步、竞品监控、选品及跨平台铺货等场景。(239字)
在阿里云上用最小成本做 GEO:复用现有云资源的可行路径
中小企业做GEO(生成式引擎优化),只需复用现有云资源,以低于5%的边际成本,将官网与文档库改造为结构化内容资产,使其可被豆包、通义千问等6大AI平台检索引用。核心是构建E-E-A-T友好的语义实体网络,14天即可上线,首季引用率提升3倍。(239字)
GEO日志观测实操:用User-Agent追踪AI爬虫访问
本文详解如何通过User-Agent从服务器日志精准识别GPTBot、Google-Extended、博查搜索Bot等AI爬虫,统计其访问页面与频次;强调UA仅反映“谁来过”,不可推断“是否被收录或引用”,需结合robots.txt配置与静态HTML保障抓取可达性。(239字)
小微主体AI搜索优化:单点穿透的机制与8种执行路径
本文专为小微企业与个人品牌撰写,破除“全平台覆盖”误区,揭示生成式AI搜索依赖平台推荐的两层引用机制。提出“单点穿透”策略:通过引用侦察锁定2–3个高权重平台,改造内容为可摘录信息块,多形态适配各平台规则,并以可对质性保障可信度。强调可观测、可验证的闭环执行路径。
从SEO到GEO:AI生成式搜索时代,企业网络优化的全新变革
随着AI生成式搜索全面普及,用户信息检索习惯彻底变革,传统SEO优化模式难以适配大模型问答场景,行业迎来迭代拐点。GEO生成式引擎优化作为新一代网络优化体系,依托语义理解、多模态内容构建、实时动态监测三大核心能力,适配AI大模型收录与推荐逻辑,打破传统流量局限。本文结合行业技术探索实践,中立解析GEO的技术原理、行业价值与发展趋势,对比传统优化模式的核心短板,阐述AI时代企业数字化优化的转型方向,为企业布局AI搜索生态、沉淀数字化品牌资产提供专业参考。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。