hive中表状态数据的获取

简介:

在做容量规划的时候,我们需要关注hive中表的占用空间大小,文件数量,平均文件大小,已及存储格式,虽然在hive中也有statistcs的功能,但是值并准确(相比mysql的show table status相差很多)

我们可以通过一些简单地方法去拿到这个值,比如通过hadoop fs -du 来获取表占用的空间大小,通过hadoop fs -count获取表的文件数量,然后定期取值并load到数据库中。

在元数据库中,通过创建view来获取数据库,hdfs路径,表类型,存储格式等信息


1
2
3
4
5
6
7
8
9
10
11
12
13
CREATE  OR  REPLACE  VIEW  table_location_type  AS  SELECT  CONCAT_WS( '.' ,a. NAME ,b.TBL_NAME)  AS  db_table,SUBSTR(c.LOCATION,18)  AS  db_location,b.TBL_TYPE  AS  type,SUBSTRING_INDEX(c.INPUT_FORMAT,  '.' , -1)
AS  IN_FOR  FROM  dbs a,tbls b,sds c  WHERE  a.DB_ID=b.DB_ID  AND  b.SD_ID=c.SD_ID;
数据如下:
select  *  from  table_location_type limit 5;
+ ----------------------------------+---------------------------------------------------------+---------------+-------------------+
| db_table                         | db_location                                             | type          | IN_FOR            |
+ ----------------------------------+---------------------------------------------------------+---------------+-------------------+
| xxxx         | /bip/hive_warehouse/cdnlog.db/dnion_log_origin          | MANAGED_TABLE | TextInputFormat   |
| xxxx     | /bip/hive_warehouse/cdnlog.db/chinacache_log_origin     | MANAGED_TABLE | TextInputFormat   |
| xxxx | /bip/hive_warehouse/cdnlog.db/chinanetcenter_log_origin | MANAGED_TABLE | TextInputFormat   |
| xxxxx                 | /bip/hive_warehouse/cdnlog.db/dnion_log                 | MANAGED_TABLE | RCFileInputFormat |
| xxxx        | /bip/hive_warehouse/cdnlog.db/chinanetcenter_log        | MANAGED_TABLE | RCFileInputFormat |
+ ----------------------------------+---------------------------------------------------------+---------------+-------------------+

然后通过和我们自己收集的信息做join就可以获取相关的数据:

比如文件数量最多top 20

1
2
3
select  a.db_table  as  tb,round(b. size /(1024*1024*1024),2)  as  size ,c. size  as  num,round(b. size /(c. size *1024*1024),2)  as  avg ,
a.type,a.in_for  from  table_location_type  a,file_size b,file_num  c  where  a.db_location=b.location  and  a.db_location=c.location  and  c.dt= '20140325'
and  b.dt= '20140325'  and  c. size  > 0  and  b. size  > 1000000000  order  by  c. size +0  desc  limit 20;

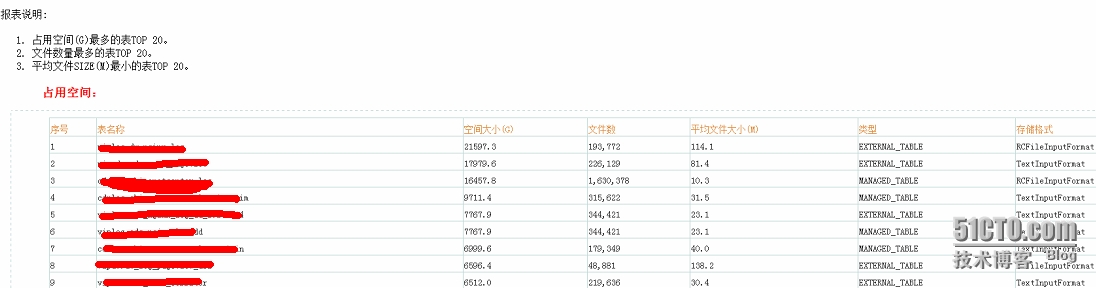
在实际的使用中,我们收集了文件数最多的表,占用空间最大的表,平均文件最小的表,并通过报表的形式方式处理,这样就可以简单了解到hive中表的一些信息,另外还会收集一些job的信息,比如job的map和reduce的数量,使用情况等,对job做详细的分析和优化。

报表如下:
wKioL1M0ObTStkEDAAH_PwkDkP4831.jpg


本文转自菜菜光 51CTO博客,原文链接:http://blog.51cto.com/caiguangguang/1385603,如需转载请自行联系原作者

相关文章
|
SQL 分布式计算 Hadoop
Hadoop-14-Hive HQL学习与测试 表连接查询 HDFS数据导入导出等操作 逻辑运算 函数查询 全表查询 WHERE GROUP BY ORDER BY(一)
494 4
|
SQL 分布式计算 关系型数据库
Hadoop-21 Sqoop 数据迁移工具 简介与环境配置 云服务器 ETL工具 MySQL与Hive数据互相迁移 导入导出
561 3
|
SQL
Hadoop-14-Hive HQL学习与测试 表连接查询 HDFS数据导入导出等操作 逻辑运算 函数查询 全表查询 WHERE GROUP BY ORDER BY(二)
700 2
|
SQL 物联网 数据处理
"颠覆传统,Hive SQL与Flink激情碰撞!解锁流批一体数据处理新纪元,让数据决策力瞬间爆表,你准备好了吗?"
【8月更文挑战第9天】数据时代,实时性和准确性至关重要。传统上,批处理与流处理各司其职,但Apache Flink打破了这一界限,尤其Flink与Hive SQL的结合,开创了流批一体的数据处理新时代。这不仅简化了数据处理流程,还极大提升了效率和灵活性。例如,通过Flink SQL,可以轻松实现流数据与批数据的融合分析,无需在两者间切换。这种融合不仅降低了技术门槛,还为企业提供了更强大的数据支持,无论是在金融、电商还是物联网领域,都将发挥巨大作用。
310 6
|
SQL 关系型数据库 MySQL
实时计算 Flink版操作报错合集之从mysql读数据写到hive报错,是什么原因
在使用实时计算Flink版过程中,可能会遇到各种错误,了解这些错误的原因及解决方法对于高效排错至关重要。针对具体问题,查看Flink的日志是关键,它们通常会提供更详细的错误信息和堆栈跟踪,有助于定位问题。此外,Flink社区文档和官方论坛也是寻求帮助的好去处。以下是一些常见的操作报错及其可能的原因与解决策略。
|
SQL DataWorks 监控
DataWorks产品使用合集之同步数据到Hive时,如何使用业务字段作为分区键
DataWorks作为一站式的数据开发与治理平台,提供了从数据采集、清洗、开发、调度、服务化、质量监控到安全管理的全套解决方案,帮助企业构建高效、规范、安全的大数据处理体系。以下是对DataWorks产品使用合集的概述,涵盖数据处理的各个环节。
|
SQL 分布式计算 关系型数据库
Hadoop-24 Sqoop迁移 MySQL到Hive 与 Hive到MySQL SQL生成数据 HDFS集群 Sqoop import jdbc ETL MapReduce
561 0
|
SQL 缓存 关系型数据库
ClickHouse(19)ClickHouse集成Hive表引擎详细解析
Hive引擎允许对HDFS Hive表执行 `SELECT` 查询。目前它支持如下输入格式: -文本:只支持简单的标量列类型,除了 `Binary` - ORC:支持简单的标量列类型,除了`char`; 只支持 `array` 这样的复杂类型 - Parquet:支持所有简单标量列类型;只支持 `array` 这样的复杂类型
883 1
|
SQL 分布式计算 HIVE
实时计算 Flink版产品使用问题之同步到Hudi的数据是否可以被Hive或Spark直接读取
实时计算Flink版作为一种强大的流处理和批处理统一的计算框架,广泛应用于各种需要实时数据处理和分析的场景。实时计算Flink版通常结合SQL接口、DataStream API、以及与上下游数据源和存储系统的丰富连接器,提供了一套全面的解决方案,以应对各种实时计算需求。其低延迟、高吞吐、容错性强的特点,使其成为众多企业和组织实时数据处理首选的技术平台。以下是实时计算Flink版的一些典型使用合集。