Dataphin功能Tips系列(48)-如何根据Hive SQL/Spark SQL的任务优先级指定YARN资源队列

简介: 如何根据Hive SQL/Spark SQL的任务优先级指定YARN资源队列

一、场景

客户A需要对生产和开发环境的Hive SQL/Spark SQL根据任务优先级指定YARN资源队列,提高任务执行效率和资源利用率,在Dataphin上如何实现?

二、解决方案及功能

Dataphin支持根据任务优先级指定YARN资源队列

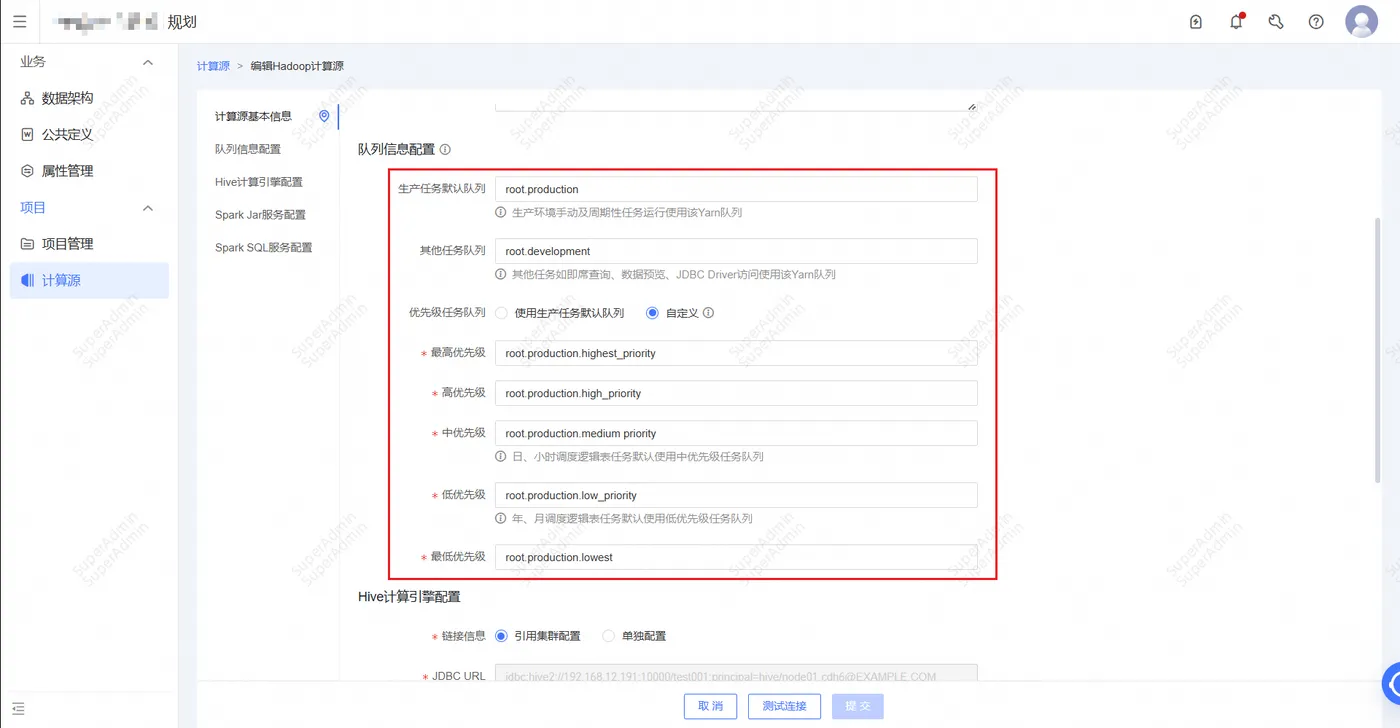
①【计算源-队列信息配置】配置资源队列,具体可以联系Hadoop的运维团队或者是从yarn-site.xml中获取资源队列的信息
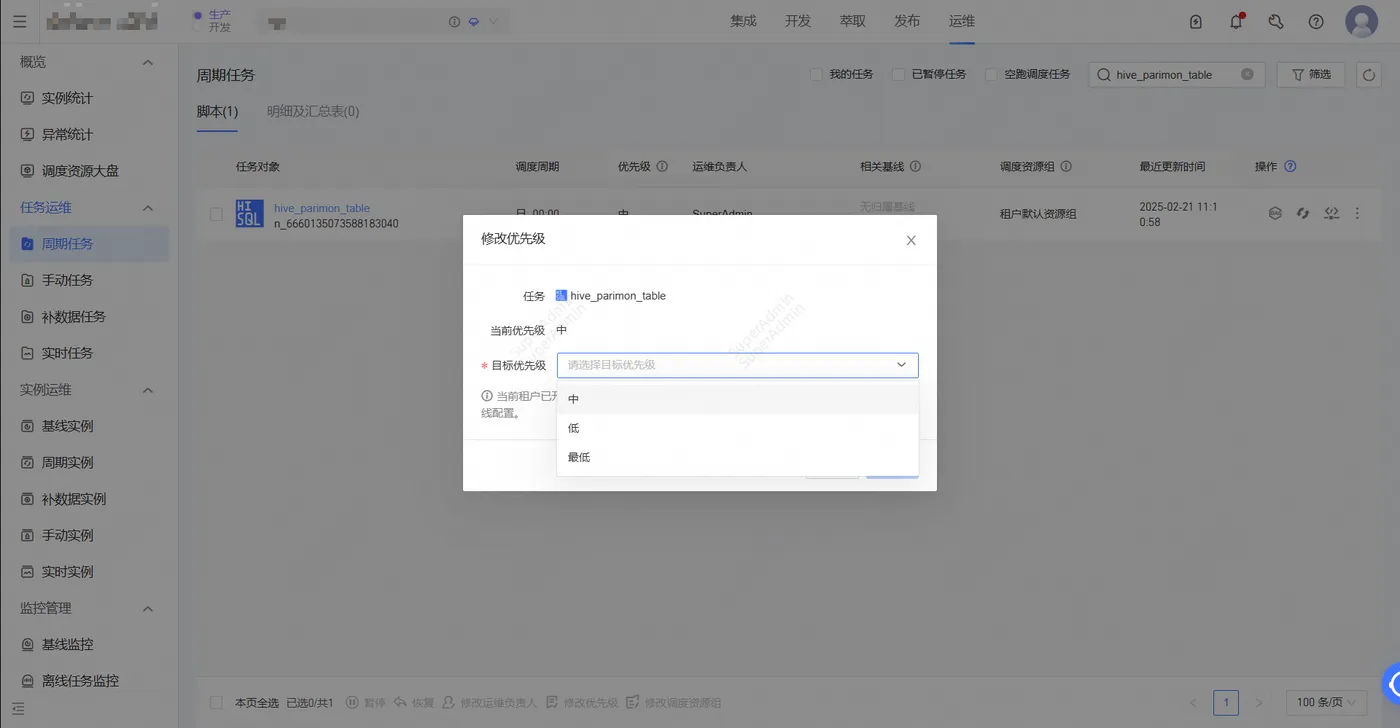
②【运维-周期任务/手动任务】配置任务优先级,如果租户开启了基线功能,任务优先级仅支持配置最低、低、中;高和更高的任务优先级只支持基线任务使用
③Dataphin的实例从调度集群的客户端每次提交Hive SQL/Spark SQL时,Hive/Spark会启动一个新的Session,并根据任务优先级指定的资源队列,在JDBC URL后面拼接资源队列信息

String jdbcUrl = "jdbc:hive2://<host>:<port>/;hive.queue.name=<queue_name>";
String jdbcUrl = "jdbc:hive2://<host>:<port>/;spark.scheduler.pool=<queue_name>";

相关文章
|
SQL Java 关系型数据库
Dataphin功能Tips系列(53)-离线集成任务如何合理配置JVM资源
本文探讨了将MySQL数据同步至Hive时出现OOM问题的解决方案。
550 5
|
SQL JSON 分布式计算
Spark SQL架构及高级用法
Spark SQL基于Catalyst优化器与Tungsten引擎,提供高效的数据处理能力。其架构涵盖SQL解析、逻辑计划优化、物理计划生成及分布式执行,支持复杂数据类型、窗口函数与多样化聚合操作,结合自适应查询与代码生成技术,实现高性能大数据分析。
1026 2
|
分布式计算 监控 Java
|
资源调度 Kubernetes 调度
Dataphin功能Tips系列(46)-实时研发任务在session调试和运行 时资源分配上的区别
实时研发任务在session调试和运行 时资源分配上的区别
369 2
|
Kubernetes 流计算 容器
|
SQL 数据采集 数据挖掘
大数据行业应用之Hive数据分析航班线路相关的各项指标
703 1
|
SQL 分布式计算 数据库
【大数据技术Spark】Spark SQL操作Dataframe、读写MySQL、Hive数据库实战(附源码)
1108 0
|
SQL 分布式计算 大数据
大数据新视界 --大数据大厂之Hive与大数据融合:构建强大数据仓库实战指南
本文深入介绍 Hive 与大数据融合构建强大数据仓库的实战指南。涵盖 Hive 简介、优势、安装配置、数据处理、性能优化及安全管理等内容,并通过互联网广告和物流行业案例分析,展示其实际应用。具有专业性、可操作性和参考价值。
大数据新视界 --大数据大厂之Hive与大数据融合:构建强大数据仓库实战指南
|
SQL 分布式计算 大数据
大数据处理平台Hive详解
【7月更文挑战第15天】Hive作为基于Hadoop的数据仓库工具,在大数据处理和分析领域发挥着重要作用。通过提供类SQL的查询语言,Hive降低了数据处理的门槛,使得具有SQL背景的开发者可以轻松地处理大规模数据。然而,Hive也存在查询延迟高、表达能力有限等缺点,需要在实际应用中根据具体场景和需求进行选择和优化。
1475 6
|
SQL 分布式计算 Java
大数据-96 Spark 集群 SparkSQL Scala编写SQL操作SparkSQL的数据源:JSON、CSV、JDBC、Hive
572 0