
前言* Hadoop是Apache开源组织的一个分布式计算开源框架,在很多大型网站上都已经得到了应用,如亚马逊、Facebook和Yahoo等等。对于我来说,最近的一个使用点就是服务集成平台的日志分析。服务集成平台的日志量将会很大,而这也正好符合了分布式计算的适用场景(日志分析和索引建立就是两大应用场景)。
今天我们来实际搭建一下Hadoop 2.2.0版,实战环境为目前主流服务器操作系统CentOS 6.5系统。
一、实战环境
|
1
2
3
4
5
6
|
系统版本:CentOS 6.5 x86_64
JAVA版本:JDK-1.7.0_25
Hadoop版本:hadoop-2.2.0
192.168.172.59 namenode (充当namenode、secondary namenode和ResourceManager角色)
192.168.172.88 datanode1 (充当datanode、nodemanager角色)
192.168.172.89 datanode2 (充当datanode、nodemanager角色)
|
二、系统准备
1)Hadoop可以从Apache官方网站直接下载最新版本Hadoop2.2。官方目前是提供了linux32位系统可执行文件,所以如果需要在64位系统上部署则需要单独下载src 源码自行编译。(如果是真实线上环境,请下载64位hadoop版本,这样可以避免很多问题,这里我实验采用的是32位版本)
|
1
2
3
4
|
Hadoop下载地址
http:
//apache
.claz.org
/hadoop/common/hadoop-2
.2.0/
Java 下载下载
http:
//www
.oracle.com
/technetwork/java/javase/downloads/index
.html
|
2)我们这里采用三台CnetOS服务器来搭建Hadoop集群,分别的角色如上已经注明。
第一步:我们需要在三台服务器的/etc/hosts里面设置对应的主机名如下(真实环境可以使用内网DNS解析)
|
1
2
3
4
5
6
7
|
[root@node1 hadoop]
# cat /etc/hosts
# Do not remove the following line, or various programs
# that require network functionality will fail.
127.0.0.1 localhost.localdomain localhost
192.168.172.59 node1
192.168.172.88 node2
192.168.172.89 node3(注* 我们需要在namenode、datanode三台服务器上都配置hosts解析)
|
3)从namenode上无密码登陆各台datanode服务器,需要做如下配置:
|
1
2
3
4
|
在namenode 128上执行
ssh
-keygen,一路Enter回车即可。
然后把公钥
/root/
.
ssh
/id_rsa
.pub拷贝到datanode服务器即可,拷贝方法如下:
ssh
-copy-
id
-i .
ssh
/id_rsa
.pub root@192.168.172.88
ssh
-copy-
id
-i .
ssh
/id_rsa
.pub root@192.168.172.89
|
三、Java安装配置
|
1
2
3
4
5
|
tar
-xvzf jdk-7u25-linux-x64.
tar
.gz &&
mkdir
-p
/usr/java/
;
mv
/jdk1
.7.0_25
/usr/java/
即可。
安装完毕并配置java环境变量,在
/etc/profile
末尾添加如下代码:
export
JAVA_HOME=
/usr/java/jdk1
.7.0_25/
export
PATH=$JAVA_HOME
/bin
:$PATH
export
CLASSPATH=$JAVE_HOME
/lib/dt
.jar:$JAVE_HOME
/lib/tools
.jar:./
|
保存退出即可,然后执行source /etc/profile 生效。在命令行执行java -version 如下代表JAVA安装成功。
|
1
2
3
4
|
[root@node1 ~]
# java -version
java version
"1.7.0_25"
Java(TM) SE Runtime Environment (build 1.7.0_25-b15)
Java HotSpot(TM) 64-Bit Server VM (build 23.25-b01, mixed mode)
|
(注* 我们需要在namenode、datanode三台服务器上都安装Java JDK版本)
四、Hadoop版本安装
官方下载的hadoop2.2.0版本,不用编译直接解压安装就可以使用了,如下:
1)解压:
tar  -xzvf  hadoop-2.2.0.tar.gz &&mv hadoop-2.2.0  /data/hadoop/
(注* 先在namenode服务器上都安装hadoop版本即可,datanode先不用安装,待会修改完配置后统一安装datanode)
2)配置变量:
|
1
2
3
4
5
|
在
/etc/profile
末尾继续添加如下代码,并执行
source
/etc/profile
生效。
export
HADOOP_HOME=
/data/hadoop/
export
PATH=$PATH:$HADOOP_HOME
/bin/
export
JAVA_LIBRARY_PATH=
/data/hadoop/lib/native/
(注* 我们需要在namenode、datanode三台服务器上都配置Hadoop相关变量)
|
五、配置Hadoop
在namenode上配置,我们需要修改如下几个地方:
1)修改vi/data/hadoop/etc/hadoop/core-site.xml 内容为如下:
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
|
<?
xml
version
=
"1.0"
?>
<?
xml-stylesheet
type
=
"text/xsl"
href
=
"configuration.xsl"
?>
<!-- Put site-specific property overrides in this file. -->
<
configuration
>
<
property
>
<
name
>fs.default.name</
name
>
<
value
>hdfs://node1:9000</
value
>
</
property
>
<
property
>
<
name
>hadoop.tmp.dir</
name
>
<
value
>/tmp/hadoop-${user.name}</
value
>
<
description
>A base for other temporary directories.</
description
>
</
property
>
</
configuration
>
|
2)修改vi/data/hadoop/etc/hadoop/mapred-site.xml内容为如下:
|
1
2
3
4
5
6
7
8
9
|
<?
xml
version
=
"1.0"
?>
<?
xml-stylesheet
type
=
"text/xsl"
href
=
"configuration.xsl"
?>
<!-- Put site-specific property overrides in this file. -->
<
configuration
>
<
property
>
<
name
>mapred.job.tracker</
name
>
<
value
>node1:9001</
value
>
</
property
>
</
configuration
>
|
3)修改vi/data/hadoop/etc/hadoop/hdfs-site.xml内容为如下:
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
|
<?
xml
version
=
"1.0"
encoding
=
"UTF-8"
?>
<?
xml-stylesheet
type
=
"text/xsl"
href
=
"configuration.xsl"
?>
<
configuration
>
<
property
>
<
name
>dfs.name.dir</
name
>
<
value
>/data/hadoop/data_name1,/data/hadoop/data_name2</
value
>
</
property
>
<
property
>
<
name
>dfs.data.dir</
name
>
<
value
>/data/hadoop/data_1,/data/hadoop/data_2</
value
>
</
property
>
<
property
>
<
name
>dfs.replication</
name
>
<
value
>2</
value
>
</
property
>
</
configuration
>
|
4)在/data/hadoop/etc/hadoop/hadoop-env.sh文件末尾追加JAV_HOME变量:
|
1
|
echo
"export JAVA_HOME=/usr/java/jdk1.7.0_25/"
>>
/data/hadoop/etc/hadoop/hadoop-env
.sh
|
5)修改 vi /data/hadoop/etc/hadoop/masters文件内容为如下:
|
1
|
node1
|
6)修改vi/data/hadoop/etc/hadoop/slaves文件内容为如下:
|
1
2
|
node2
node3
|
如上配置完毕,以上的配置具体含义在这里就不做过多的解释了,搭建的时候不明白,可以查看一下相关的官方文档。
如上namenode就基本搭建完毕,接下来我们需要部署datanode,部署datanode相对简单,执行如下操作即可。
|
1
|
for
i
in
`
seq
88 89 ` ;
do
scp
-r
/data/hadoop/
root@192.168.172.$i:
/data/
;
done
|
自此整个集群基本搭建完毕,接下来就是启动hadoop集群了。
六、启动hadoop并测试
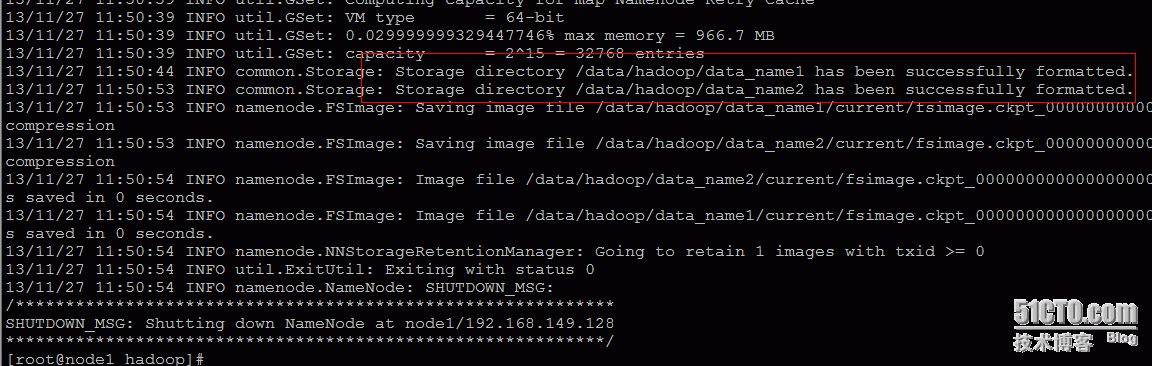
在启动hadoop之前,我们需要做一步非常关键的步骤,需要在namenode上执行如下命令初始化name目录和数据目录。
|
1
|
cd
/data/hadoop/
; .
/bin/hadoop
namenode -
format
|
那如何算初始化成功呢,如下截图成功创建name目录即正常:
然后启动hadoop所有服务,如下命令:
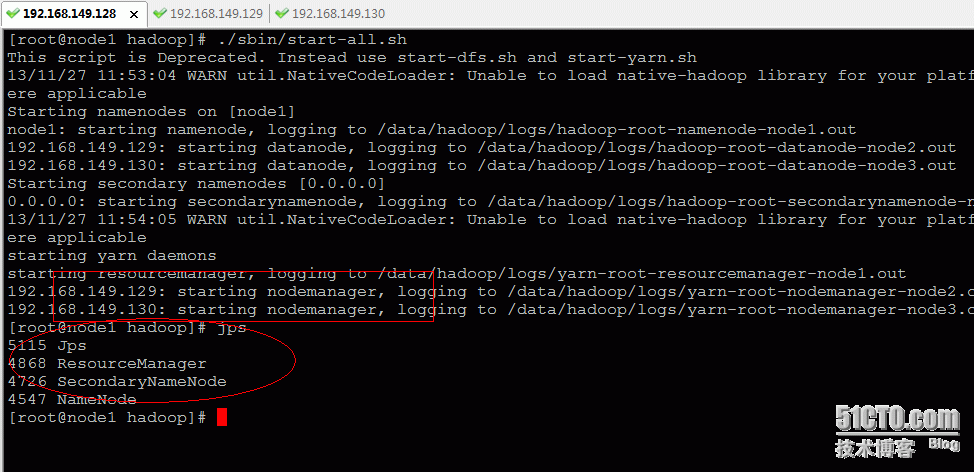
[root@node1 hadoop]# ./sbin/start-all.sh
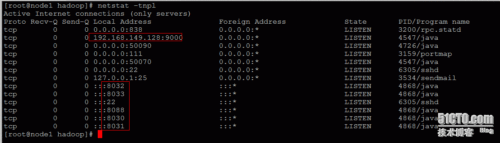
我们还可以查看相应的端口是否启动:netstat -ntpl
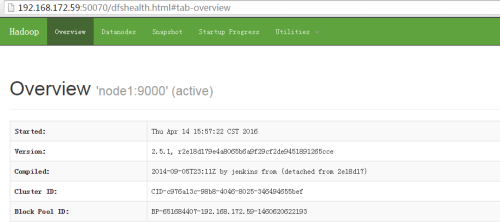
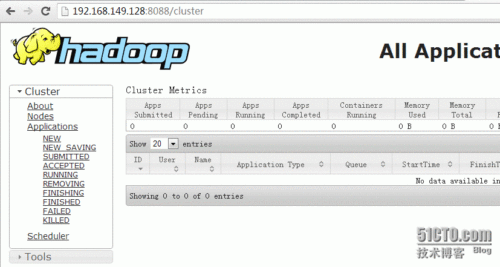
访问如下地址:http://192.168.172.59:50070/
访问地址:http://192.168.172.59:8088/
搭建完成后,我们简单的实际操作一下,如下图:
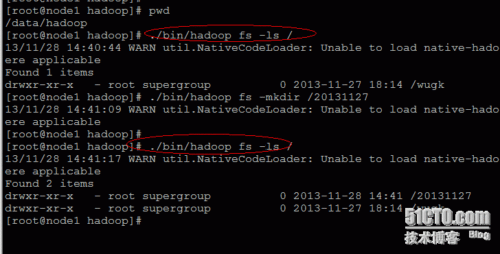
自此hadoop基本搭建完毕。
七、部署ZooKeeper服务
在node1上配置:
下载zookeeper3.4.6版本:
|
1
2
|
wget http:
//apache
.fayea.com
/zookeeper/zookeeper-3
.4.6
/zookeeper-3
.4.6.
tar
.gz
tar
-xzfzookeeper-3.4.6.
tar
.gz -C
/export/servers/
|
#vim /export/servers/ zookeeper-3.4.6/conf/zoo.cfg写入如下内容:
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
|
# The number of milliseconds of each tick
tickTime=2000
# The number of ticks that the initial
# synchronization phase can take
initLimit=10
# The number of ticks that can pass between
# sending a request and getting an acknowledgement
syncLimit=5
# the directory where the snapshot is stored.
dataDir=
/export/zookeeper
# the port at which the clients will connect
clientPort=2181
initLimit=5
syncLimit=2
dataLogDir=
/export/zookeeper/logs
server.1=node1:2888:3888
server.2=node2:2888:3888
server.3=node3:2888:3888
|
注意:zk里面的node节点名称要一一对应哦,然后创建zk数据目录和日志路径:
|
1
2
|
mkdir
-p
/export/zookeeper/logs
echo
1 >
/export/zookeeper/myid
|
如上在node1上配置好zk后,把zk整个程序同步到另外两台node2、node3。
执行如下脚本:
|
1
|
for
i
in
`
seq
88 89` ;
do
rsync
-aP--delete
/export/servers/zookeeper-3
.4.6/ root@192.168.172.$i:
/export/servers/zookeeper-3
.4.6/ ;
rsync
-av
/export/zookeeper/
root@192.168.172.$i:
/export/
;
done
|
然后分别修改node2、node3的myid为2和3,命令如下:
在node2上执行:
|
1
|
echo
2 >
/export/zookeeper/myid
|
在node3上执行:
|
1
|
echo
3 >
/export/zookeeper/myid
|
执行完后,分别启动三台服务器的zk服务:
|
1
|
cd
/export/servers/zookeeper-3
.4.6/ ;.
/bin/zkServer
.sh start
|
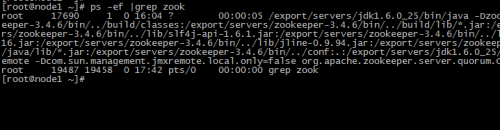
如上配置,zookeeper配置完毕。
八、部署Hbase服务
在node1上配置:
|
1
2
3
4
|
下载软件:hbase-0.96.2-hadoop2.
tar
.gz,然后执行如下命令:
tarxf hbase-0.96.2-hadoop2.
tar
.gz ;
mv
hbase-0.96.2-hadoop2
/export/hbase
然后进入hbase配置文件目录,如下图:
cd
/export/hbase/conf/
|
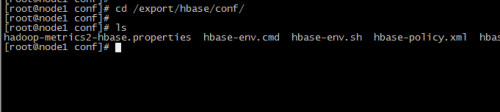
vim hbase-site.xml内容如下:
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
|
<
configuration
>
<
property
>
<
name
>hbase.tmp.dir</
name
>
<
value
>/export/hbase/tmp</
value
>
</
property
>
<
property
>
<
name
>zookeeper.session.timeout</
name
>
<
value
>3600000</
value
>
</
property
>
<
property
>
<
name
>hbase.zookeeper.property.tickTime</
name
>
<
value
>180000</
value
>
</
property
>
<
property
>
<
name
>hbase.rootdir</
name
>
<
value
>hdfs://node1:9000/hbase</
value
>
</
property
>
<
property
>
<
name
>hbase.cluster.distributed</
name
>
<
value
>true</
value
>
</
property
>
<
property
>
<
name
>hbase.zookeeper.quorum</
name
>
<
value
>node1,node2,node3</
value
>
</
property
>
<!--禁止magor compaction-->
<
property
>
<
name
>hbase.hregion.majorcompaction</
name
>
<
value
>0</
value
>
</
property
>
<!--禁止split-->
<
property
>
<
name
>hbase.hregion.max.filesize</
name
>
<
value
>536870912000</
value
>
</
property
>
<!---->
<
property
>
<
name
>hbase.hstore.blockingStoreFiles</
name
>
<
value
>2100000000</
value
>
</
property
>
<
property
>
<
name
>hbase.regionserver.handler.count</
name
>
<
value
>100</
value
>
</
property
>
</
configuration
>
|
vim hbase-env.sh内容如下:
|
1
2
3
4
|
exportJAVA_HOME=
/export/servers/jdk1
.6.0_25/
exportHBASE_OPTS=
"-XX:+UseConcMarkSweepGC"
exportHBASE_MANAGES_ZK=
false
exportHADOOP_HOME=
/export/hadoop/
|
vim regionservers内容如下:
|
1
2
|
node2
node3
|
然后将node1 habse配置同步至node2、node3:
|
1
|
for
i
in
`
seq
88 89` ;
do
rsync
-av
/export/hbase/
root@192.168.172.$i:
/export/
;
done
|
最好在node1启动整个集群hbase即可:
|
1
|
cd
/export/hbase/
;shbin
/start-hbase
.sh
|
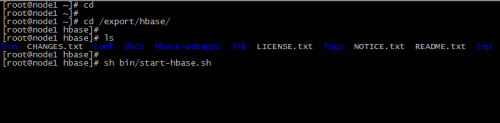
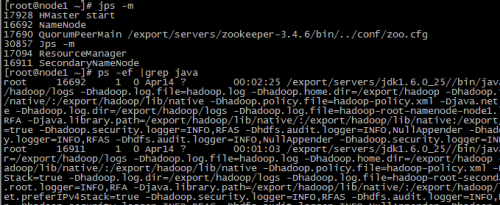
查看node1 JAVA进程信息如下:
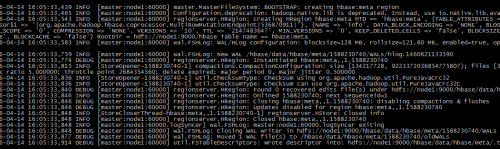
最好查看hbase日志如下:
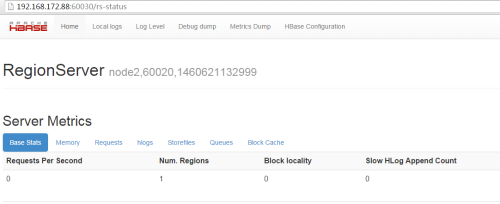
通过web查看hbase截图如下:

NODE2状态:
-----------------------------------------------------------
你若觉得作者的文章写得不错,请奖励作者几锭银子,让作者感受到来自你满满的鼓励和继续创作的动力!我们支持原创!鼓励原创!
打赏之后,文章底部显示参与打赏者的记录,可以直接通过微信扫描打赏哟,直接按打赏根据提示操作。
自定义打赏金额,友情提示打赏金额不要超过50元哦,土豪可以随意哦,51CTO谢谢您对作者的支持!谢谢你的慷慨大方!
本文转自 wgkgood 51CTO博客,原文链接:http://blog.51cto.com/wgkgood/1899771


