写在前边的话
以前在学习编写mapreduce时,由于没有shell,就是首先在eclipse里配置环境,利用eclipse的强大功能进行编写,调试,编译,最终打包到集群上运行,同样面对Spark的时候,虽然spark提供了强大的shell 脚本能力,但对于定期或者处理时间很长的程序来说并不适合使用shell,所以这里我选用了强大IDEA 作为spark的开发环境
环境说明(点击下载):Java1.8.1_101 / Scala 2.11.8 / Intellij DEA 2.16.2 / Spark 1.6.2
10分钟 帮你打开Scala的编程大门:点击阅读
注意事项(我掉过的坑):本地Scala编程时,注意环境与集群的一致性,由于我的集群是spark1.6.2,scala2.10.x,java1.7.x,而本地环境java和scala都比集群高了一个版本,所以本地打包在集群上运行时就会出现版本不匹配的错误(如果用到java时,也是一样的),这一点大家要十分注意
一:IDEA构建Spark编程环境
部署参考文章:使用IntelliJ IDEA编写SparkPi直接在Spark中运行
需要注意的有两个地方
1:在官方给的example中需要加入两行代码
    conf.setMaster("spark://192.168.48.130:7077")     //指定你的spark集群

    spark.addJar("/home/master/SparkApp/SparkTest.jar")   //指明位置
由于我是在本地打包好的jar,所以上传jar到linux下时,必须保证位置与 代码中的一致
2:在提交jar包时,出现错误

可以看出是17行的问题,原代码中17行:
val slices = if (args.length > 0) args(0).toInt else 2所以在运行jar包时需要指定该参数,官网给出的样例是这样的( http://spark.apache.org/docs/latest/)
./bin/run-example SparkPi 10所以这里要指定数目
/opt/spark/bin/spark-submit /home/master/SparkApp/SparkApp.jar 10 --class "SparkApp"最终的运行结果如下
此时我们在看Spark的Web界面监控
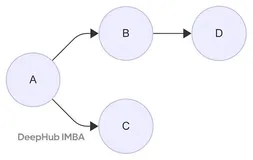
二:Spark执行PageRank算法
PageRank算法解析参考:点击阅读
PageRank的MapReduce实现参考:点击阅读
Shell 运行如下:
scala> val links = sc.parallelize(
     |  Array(
     |   ('A', Array('D')),
     |   ('B', Array('A')),
     |   ('C', Array('A', 'B')),
     |   ('D', Array('A', 'C'))
     |  )
     | )
links: org.apache.spark.rdd.RDD[(Char, Array[Char])] = ParallelCollectionRDD[0] at parallelize at <console>:24

scala> var ranks = sc.parallelize(
     |  Array(
     |   ('A', 1.0),
     |   ('B', 1.0),
     |   ('C', 1.0),
     |   ('D', 1.0)
     |  )
     | )
ranks: org.apache.spark.rdd.RDD[(Char, Double)] = ParallelCollectionRDD[1] at parallelize at <console>:24

scala> for(i <- 1 to 6){
     |     val joinRdd = links.join(ranks)
     |     val contribsRdd = joinRdd.flatMap{
     |       case(srcURL, (links, rank)) => links.map(destURL => (destURL, rank / links.size))
     |     }
     |     ranks = contribsRdd.reduceByKey(_ + _).mapValues(0.15 + _ * 0.85)
     |     ranks.take(4).foreach(println)
     |     println()
     | }
六次迭代的结果:
代码注释:
//图的初始化
val links = sc.parallelize(
 Array(
  ('A', Array('D')),
  ('B', Array('A')),
  ('C', Array('A', 'B')),
  ('D', Array('A', 'C'))
 )
)

//PR值的初始化
//这里可以用 var ranks  = links.mapValues(_=> 1.0)代替
var ranks = sc.parallelize(
 Array(
  ('A', 1.0),
  ('B', 1.0),
  ('C', 1.0),
  ('D', 1.0)
 )
)

//6 为循环次数,这里可以自己设置
for(i <- 1 to 6){
    val joinRdd = links.join(ranks)    //连接两个rdd
    //计算来自其他网页的PR 贡献值
    val contribsRdd = joinRdd.flatMap{
      // 注意这里的links为模式匹配得到的值, 类型为Array[Char], 并非前面的ParallelCollectionRDD
      case(srcURL, (links, rank)) => links.map(destURL => (destURL, rank / links.size))
    }
    //ranks进行更新
    ranks = contribsRdd.reduceByKey(_ + _).mapValues(0.15 + _ * 0.85)
    //打印出ranks的值
    ranks.take(4).foreach(println)
    println()   //换行,便于观察
}
打包PageRank算法在Spark集群上运行(Jar包下载:github)
/opt/spark/bin/spark-submit /home/master/SparkApp/Spark.jar --class "PageRank"
运行结果如下:
可以看到和Shell脚本运行的结果是一样的