Spark集群搭建

简介: Spark是一个基于内存的计算框架,本文主要是介绍Spark的独立部署。

Spark集群搭建

一、环境说明
1、机器:3台虚机(hadoop01/hadoop02/hadoop03)
2、Linux版本:CentOS 6.5
3、JDK版本:1.8
4、Hadoop版本:hadoop-2.5.2
5、Spark版本:Spark-1.3.1
6、Scala版本:scala-2.10.6
二、安装步骤
1、安装Hadoop,这里不做具体讲解
172.16.1.156 hadoop01
172.16.1.157 hadoop02
172.16.1.158 hadoop03
2、下载Spark
如果是基于Hadoop部署spark,可以对应hadoop的版本下载spark
下载地址:http://spark.apache.org/downloads.html
3、下载Scala
下载地址:http://www.scala-lang.org/download/2.10.6.html

4、安装Scala
解压:tar -zxvf scala-2.10.6.tgz

5.安装spark
解压:tar -zxvf spark-1.3.1-bin-hadoop2.4.tgz

6、在~/.bash_profile中配置环境变量
QQ截图20160427162720.png

7、配置spark_env.sh(Spark运行的环境变量)
修改spark_env.sh.template复制为spark_env.sh
mv spark_env.sh.template spark_env.sh
QQ_20160427154759
配置以上环境变量
export JAVA_HOME=/home/hadoop/jdk1.8
export SPARK_MASTER_IP=spark01
export SPARK_MASTER_PORT=7077
export SPARK_WORKER_CORES=1
export SPARK_WORKER_INSTANCES=1
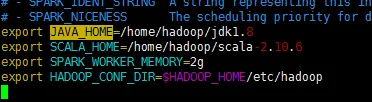
8、复制hadoop01节点配置好的spark到其他节点
scp -r ~/spark-1.3.1-bin-hadoop2.4/ hadoop@hadoop02:~/
scp -r ~/spark-1.3.1-bin-hadoop2.4/ hadoop@hadoop03:~/

9.spark的web管理界面 :http://172.16.1.156:8080/
spark WEBUI界面:http://172.16.1.156:4040/jobs/

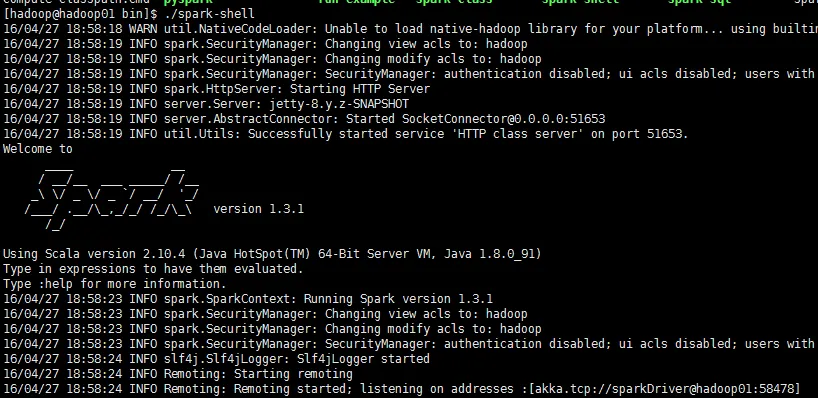
spark-shell启动:
到spark的bin目录下执行 ./spark-shell
QQ_20160427190313

目录
相关文章
|
分布式计算 大数据 Java
大数据-87 Spark 集群 案例学习 Spark Scala 案例 手写计算圆周率、计算共同好友
368 5
|
分布式计算 关系型数据库 MySQL
大数据-88 Spark 集群 案例学习 Spark Scala 案例 SuperWordCount 计算结果数据写入MySQL
302 3
|
人工智能 分布式计算 调度
打破资源边界、告别资源浪费:ACK One 多集群Spark和AI作业调度
ACK One多集群Spark作业调度,可以帮助您在不影响集群中正在运行的在线业务的前提下,打破资源边界,根据各集群实际剩余资源来进行调度,最大化您多集群中闲置资源的利用率。
|
存储 分布式计算 调度
Spark Master HA 主从切换过程不会影响到集群已有作业的运行, 为什么?
Spark Master 的高可用性(HA)机制确保主节点故障时,备用主节点能无缝接管集群管理,保障稳定运行。关键在于: 1. **Driver 和 Executor 独立**:任务执行不依赖 Master。 2. **应用状态保持**:备用 Master 通过 ZooKeeper 恢复集群状态。 3. **ZooKeeper 协调**:快速选举新 Master 并同步状态。 4. **容错机制**:任务可在其他 Executor 上重新调度。 这些特性保证了集群在 Master 故障时仍能正常运行。
|
存储 缓存 分布式计算
大数据-89 Spark 集群 RDD 编程-高阶 编写代码、RDD依赖关系、RDD持久化/缓存
412 4
|
分布式计算 大数据 Spark
大数据-95 Spark 集群 SparkSQL Action与Transformation操作 详细解释与测试案例(二)
331 1
|
分布式计算 Java 大数据
大数据-92 Spark 集群 SparkRDD 原理 Standalone详解 ShuffleV1V2详解 RDD编程优化
373 0
大数据-92 Spark 集群 SparkRDD 原理 Standalone详解 ShuffleV1V2详解 RDD编程优化
|
SQL 分布式计算 大数据
大数据-100 Spark 集群 Spark Streaming DStream转换 黑名单过滤的三种实现方式(一)
315 0
|
SQL 分布式计算 大数据
大数据-100 Spark 集群 Spark Streaming DStream转换 黑名单过滤的三种实现方式(二)
280 0
|
消息中间件 分布式计算 Kafka
大数据-99 Spark 集群 Spark Streaming DStream 文件数据流、Socket、RDD队列流
413 0
