Log4Net 生成多个文件、文件名累加解决方法
项目中的WCF服务里采用Log4Net用来记录异常日志,但部署后,生成的日志会出现多个累加文件,如下图:
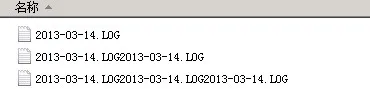
WCF是寄宿在IIS上,包含了5个SVC服务。打开日志文件,发现记录的引发异常的Thread ID都不一样,猜测是多线程读写日志文件,
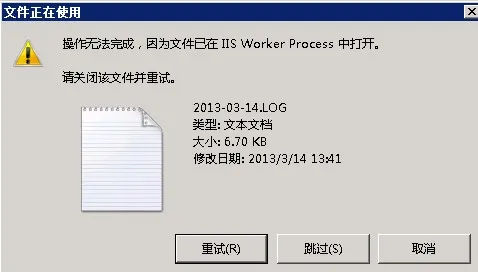
配置信息里指定文件的被占用后,重新建立了新的日志文件,删除日志文件也会出现警告信息:
解决方法:
在appender节点里添加:
<param name="lockingModel" type="log4net.Appender.FileAppender+MinimalLock" />
lockingModel 属性的详细信息可看 Log4Net SDK 中的描述。
很不解的是:type中 FileAppender+MinimalLock 为何要用 '+' 来做连接符,换成'.'的时候却不行。
完整Log4Net配置信息:
<?xml version="1.0" encoding="utf-8" ?>
<configuration>
    <configSections>
        <section name="log4net" type="log4net.Config.Log4NetConfigurationSectionHandler,log4net-net-1.0"/> </configSections> <log4net> <!--日志对象根设置--> <root> <!--定义Level级别,若没定义,默认为Debug--> <level value="ERROR"/> <!--定义日志对象使用的appender,通过appeder-ref来注册--> <appender-ref ref="LogFileAppender"/> </root> <!--定义具体的logger对象 通过调用LogManager.GetLogger(“wcflog”)函数,你可以检索具有该名字的日志。如果LogManager.GetLogger(…)打开的不是预定义的日志对象,则该日志对象会继承根日志对象的属性。知道了这一点,我们可以说,其实<logger>标签并不是必须的--> <logger name="wcflog" additivity="true"> <!--additivity 是否确认子日志对象继承父日志对象的appender列表,默认为True:确认--> <!--注意优先级,优先级低的要放在后面--> <level value="INFO" /> <level value="DEBUG"/> </logger> <appender name="LogFileAppender" type="log4net.Appender.RollingFileAppender" > <!--配置在root注册的appender-ref具体属性--> <param name="File" value="log//"/> <param name="StaticLogFileName" value="false" /> <param name="DatePattern" value="yyyy-MM-dd.LOG" /> <param name="AppendToFile" value="true"/> <!--按照文件的大小进行变换日志文件--> <param name="RollingStyle" value="Date" /> <!--单个文件最大数量--> <param name="MaximumFileSize" value="1000KB"/> <!--保留的log文件数量 超过此数量后 自动删除之前的 --> <param name="MaxSizeRollBackups" value="100" /> <!--最小锁定模型以允许多个进程可以写入同一个文件--> <param name="lockingModel" type="log4net.Appender.FileAppender+MinimalLock" /> <!--type属性,定义类型--> <layout type="log4net.Layout.PatternLayout"> <!--定义日志会话(logger session)开始输出的文字--> <param name="Header" value="异常开始记录 :"/> <!--定义日志会话(logger session)结束输出的文字--> <!--<param name="Footer" value="[Footer]\r\n"/>--> <!--输出信息的模式: --> <param name="ConversionPattern" value="%n时间 : %d 线程ID:[%t] %-5p 当前对象名称:%c - %m%n"/> </layout> <!--过滤器,只需要min和max之间的级别--> <filter type="log4net.Filter.LevelRangeFilter"> <param name="LevelMin" value="DEBUG"/> <param name="LevelMax" value="ERROR"/> </filter> </appender> </log4net> </configuration>