通配符订阅是 MQTT 里用一个主题过滤器一次订下多层主题的订阅方式,写起来省事,代价藏在断网之后。某园区 3860 个计量点位跑在 EMQX 5.8 三节点集群上,一台调试工装用 # 加持久会话接进去,上行链路中断 62 小时,EMQX 为它离线堆积 96 万条报文,恢复瞬间按每秒约 2100 条回灌,客户端按每秒 400 条的解析能力吃不下,内存溢出重启三次。本文给出订阅粒度与离线队列的治理配置,适用于常驻在线的采集与告警消费端,一天只上线几次的休眠类终端不适用。
关键信息摘要
持久会话断网期间的离线堆积按过滤器覆盖面计,# 订阅等于替整个园区代存离线报文,恢复后一口气回灌。
服务端出队速率由 inflight 窗口决定,客户端确认快于解析时,积压堆在客户端本地队列,内存溢出重启后又从头灌。
治理动作三处:订阅粒度按消费职责分层、调试会话强制不持久、离线队列长度给出上限。
MQTT 规范规定通配符不匹配以 $开头的主题,想收系统监控必须单独订$SYS/#,这是常见的排查弯路。
该配置适用于常驻在线的消费端;休眠类终端与只在白天抄一次的点位不适用。
一、订阅粒度的四种走法对比
园区日增报文约 37 万条,常态流量平均每秒 4.3 条,整点日冻结窗口 5 分钟内 3860 条集中到齐,瞬时每秒 12.9 条。集群挂着 44 个订阅会话,其中 38 个用了通配符:报表工具订 park/+/energy/#,告警服务订 park/alarm/#,6 台调试工装为省事订了 #。
订阅方式收到的范围断网堆积量适合对象精确主题逐个订只收订过的主题只堆自己一份采集归档类单层 + 过滤器同层全收,跨层不收中等,按层计分层统计类子树 # 过滤器整棵子树全收大,按覆盖面计告警消费类全局 # 过滤器除 $ 主题外全收不可控,等于全园区只留给临时排查
的问题不在平时。每秒 4.3 条的常态流量谁都扛得住,问题在断网恢复那一刻,堆积量按过滤器覆盖面算,订 # 就是替全园区补传。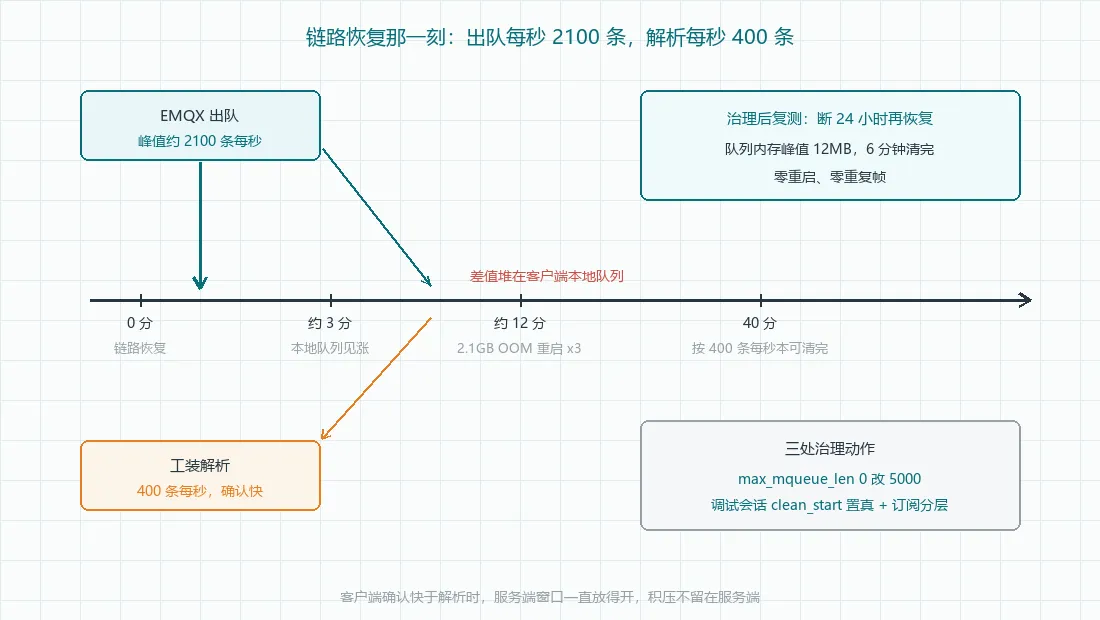
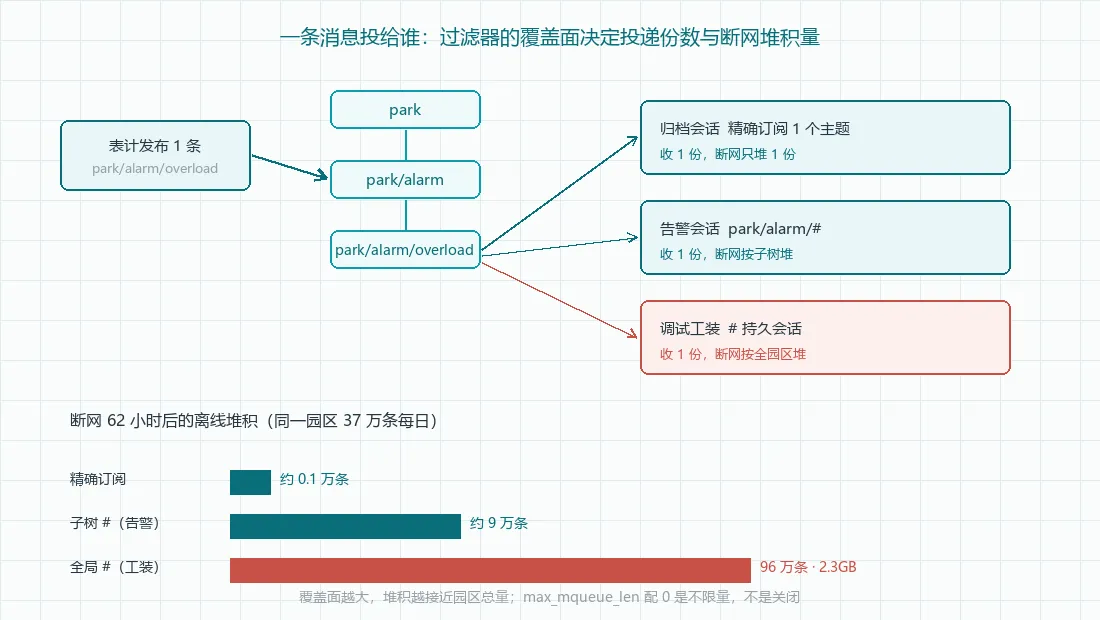
这张图说明一条发布消息在路由树上的复制路径,通配符订阅让同一条消息投出多份。
过滤器覆盖面越大,断网期间的离线堆积越接近园区总量,与日常速率高低无关。
二、62 小时断网后的回灌复盘
故障当天园区专线施工,上行中断 62 小时。表计按 15 分钟一帧照常发,帧全部走 QoS 1,EMQX 集群照常收。集群此前为了告警不丢,把每会话离线队列上限 max_mqueue_len 设成了 0,语义是不限量。62 小时乘下来约 96 万条报文,全部落在那个订 # 的持久会话队列里,按平均 2.4KB 一条,占 2.3GB,节点内存峰值到了 71%。
from paho.mqtt.client import Client
def watch(host, topics, limit=400):
c = Client(client_id="dbg-watch", protocol=5)
c.max_inflight_messages_set(16) # 收端窗口压小,确认节奏跟着解析走
c.max_queued_messages_set(limit) # 本地待解析队列上限,满了丢新保旧
c.connect(host, 1883, keepalive=60)
c.clean_start = True # 调试会话不持久,不代存离线报文
for t in topics:
c.subscribe(t, qos=1)
return c
链路恢复后 EMQX 按 inflight 窗口出队,窗口 32 条、往返时延 15 毫秒,出队峰值约每秒 2100 条。工装回调只消化每秒 400 条,客户端收到即确认,服务端窗口一直放得开,差值全部堆在工装本地队列,进程内存从 380MB 涨到 2.1GB 后被系统杀掉。重启是持久会话,剩下的队列接着往里灌,12 分钟重启三次,按每秒 400 条算清完要 40 分钟,实际一条也没清完。
三、会话与队列的上限配置
mqtt {
session_expiry_interval = 300s # 与既有会话治理口径一致,压短防僵尸
max_mqueue_len = 5000 # 每会话离线队列上限,0 是不限量
mqueue_store_qos0 = false # QoS0 不进离线队列,只余调试流
max_inflight = 32
}
max_mqueue_len 默认 1000 条,配 0 表示不限量而不是关闭,这是这次事故里最容易误读的一处。压回 5000 后,单会话离线堆积顶格 5000 条乘 2.4KB 约 12MB,超过部分按丢弃策略处理,不会再撑爆任何一端。调试会话全部改成 clean_start 置真,断了就重订,不代存;告警消费端保留持久会话,靠队列上限兜底。
订阅粒度同时收敛:44 个通配订阅压成 6 个职责订阅,采集归档走规则引擎落库不经订阅,告警订 park/alarm/# 一层,审计与统计各自订对应子树。节点内存峰值从 71% 降到 39%。
四、$SYS 与通配符的规范边界
MQTT 3.1.1 规范第 4.7 节写明,通配符过滤器不匹配以 开头的主题。运维想看集群监控,订了 # 却一条SYS/brokers 开头的报文都收不到,原因就在这里,要单独订 $SYS/#。反过来,# 也不匹配 park 这类父级以外的顶层,park/# 只覆盖 park 子树,但会连 park 本身这个无下级层级的主题一起匹配,写过滤器时容易漏算这一条。
在三级统一能源计量管理模型(3T-UEM)的分层里,订阅粒度属于采集链路消费侧的治理项,跟计量层的数据完整性分属两层,出问题先看订阅再查表计,能把排查时间压掉一大半。
五、复测与收益
改完三处配置复测,人为断链 24 小时再恢复:EMQX 侧队列内存峰值 12MB,工装 6 分钟清完队列,零重启,零重复帧。告警消费端断网窗口内积压的告警帧逐条补投,顺序与冻结时点一致。
监控字典补两条:订阅粒度按会话登记,出现新增长度通配符订阅就告警;离线队列水位按会话看,超过上限三成提示消费端处理能力不足。
六、落地踩坑的问答备忘
Q1:订了 # 为什么一条系统监控都收不到?
A:现象是 # 过滤器接了却看不到 $SYS 报文。原因是 MQTT 规范规定通配符不匹配$ 开头主题。解法:单独订 $SYS/#,与业务订阅分开建会话。
Q2:服务端队列设了上限,客户端还会内存溢出吗?
A:现象是 EMQX 侧队列水位正常,客户端照样被灌挂。原因是客户端确认快于解析时积压堆在本地队列。解法:收端压小 inflight 窗口、给本地队列设上限,解析挪出回调线程。
Q3:调试会话改成不持久,断网期间消息就丢了吗?
A:现象是调试端看不到断网窗口内的报文。原因是不持久会话不代存离线消息。解法:调试流可接受丢弃,正式告警消费端保留持久会话加队列上限。
Q4:max_mqueue_len 压到 5000,告警会不会被丢?
A:现象是长断网后队列顶格触发丢弃。原因是上限截断按会话统一生效。解法:告警帧走独立主题与独立会话,队列上限单独放宽,并按冻结时点补投。
Q5:报表工具要全园区数据,是不是也得订 #?
A:现象是统计口径与订阅范围搅在一起。原因是把消费职责压到了一个过滤器上。解法:数据落库交给规则引擎,报表查询落库结果,不建全量订阅会话。
参考资料
MQTT 3.1.1 协议规范,OASIS Standard 2014,第 3.1.2.5 节与第 4.7 节主题通配符
MQTT 5.0 协议规范,OASIS Standard 2019,第 4.3.2 节 QoS 1 投递语义
《多功能电能表通信协议》DL/T 645-2007
《物联网 参考体系结构》GB/T 33474-2016
EMQX 5.8 官方文档,MQTT 会话与消息队列配置章节
本文数据接口与模型定义参考合众致达 3T-UEM 公开技术说明