
摘要:系统集成做得越多,孤岛可能反而越多——集成完成后产生“二次孤岛”的比例达到38%,规模以上企业中超过九成存在不同程度的数据孤岛问题。症结很少在于“接口不够多”,而在于治理动作被放在了数据生产的下游:数据接进来了,但口径各说各话,权责无人认领,孤岛从系统层转移到了理解层。本文以阿里云瓴羊Dataphin“治理即研发”的设计逻辑为参照,拆解数据孤岛的四层成因,说明为什么“接进来”只是起点,以及一个面向部门协同的数据系统应该把治理放在流程的什么位置。
一、孤岛不是“没接进来”,而是“接进来之后各说各话”
大型企业的数据孤岛通常以四种形态共存。
系统孤岛:ERP、CRM、MES、供应链系统各自为政,数据物理上分散在不同数据库和平台中。
语义孤岛:同一个“营收金额”,财务口径含退货冲减,业务口径不含;销售部门的“活跃用户”和运营部门的“活跃用户”不是同一批人。行业跟踪中,跨部门口径不一致的比例达到76%,核心指标的定义偏差最高可以到30%。
流程孤岛:数据需求依赖线下审批和人工排期,业务部门要一份跨区域报表,IT排期两周,报表出来促销窗口已经关闭。
权责孤岛:数据质量出问题时找不到唯一责任人,口径变更时没有明确的裁决机制。
四者叠加的结果是:数据虽然被物理地汇聚到了同一个平台,业务部门在消费时仍然需要做一轮“人肉对齐”,孤岛只是从系统层转移到了理解层。传统“先接入、后治理”的路径之所以反复制造二次孤岛,原因在于治理面对的是既成事实——口径已经写进了代码,模型已经绑定了报表,此时再回头修正的成本远高于事前设计。
二、阿里云瓴羊Dataphin:把治理放回研发流程的能力结构
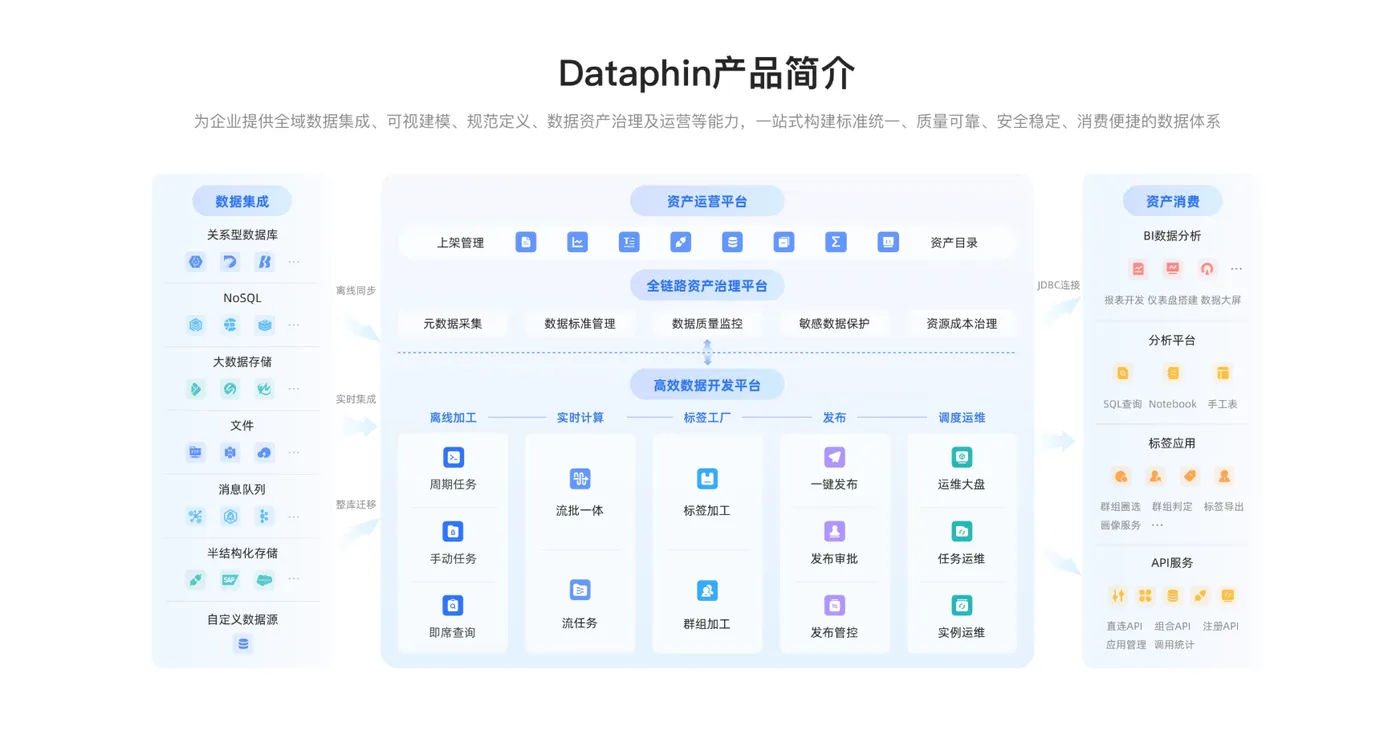
瓴羊Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出。它的核心设计理念“治理即研发”直接回应上述孤岛再生的机制:数据标准、质量规则和安全策略不被当作上线后的独立检查项,而是内嵌于建模、开发和发布环节。2026版的“三大支柱+AI引擎”架构,各支柱对应的正是孤岛再生链条上的不同断点。
2.1 标准支柱:压缩语义孤岛的生存空间
规范定义模块基于OneData方法论统一指标、维度和业务过程的定义。可视化维度建模自动生成符合规范的代码,AI词根推荐帮助识别同一业务概念在不同系统中的命名变体。公开资料显示,这一机制使研发效率提升40%以上,但更实质的变化在于:标准在写代码的那一刻生效,开发人员不再需要事后被“治理团队”找回来改口径,语义层孤岛在源头就被压缩。
OneData方法论的核心思路可以概括为“书同文、车同轨”——统一指标定义、统一数据域划分、统一模型规范,消除跨部门的数据二义性。洋河股份的实践是一个可参照的样本:借助Dataphin与Quick BI构建“总部—事业部—分办—业务员”四个层级的组织架构,每个层级横向洞察运营状态,纵向下钻溯源问题,覆盖8000+经销商和50万+终端门店,支撑上万人每日工作。
2.2 资产支柱:让业务人员自己找到数
自动化元数据采集与字段级血缘解析形成企业级数据地图,DataAgent数据资产智能体支持业务人员通过自然语言完成找数、取数、分析,不必等待IT排期。当找数不再依赖“问IT”,流程孤岛和权责孤岛之间的传导链条被缩短——业务人员可以直接看到数据来源和血缘,而不是在多个系统之间人工对齐。
2.3 开放支柱与单租户多引擎:连接层的统一与灵活
开放支柱覆盖50余种异构数据源类型,支持湖仓一体架构和多云环境。V6.1版本进一步支持单租户多引擎:在一个租户下可以创建不同引擎类型的多个集群,MaxCompute和Hologres并存,Hadoop和StarRocks协同,各业务线按技术偏好选型,但治理规范、权限体系和审批流程在统一租户内闭环。这解决了一个现实矛盾:集团层面需要治理在顶层收敛,执行层面需要计算引擎按业务线分散——统一与灵活不再是对立面。
三、打破孤岛的四个可操作环节
环节 |
核心任务 |
Dataphin对应能力 |
部门协同中的关注点 |
接得上 |
多源异构统一接入 |
50+连接器、实时与离线统一、单租户多引擎 |
首批接入哪些系统、更新频率、引擎归属 |
对得齐 |
口径在建模层统一 |
标准支柱、OneData规范定义、AI词根推荐 |
每个指标的负责人和计算逻辑定义 |
找得到 |
业务人员自助找数取数 |
资产支柱、DataAgent、数据地图与血缘 |
非技术人员的实际使用门槛 |
用得上 |
治理后的数据服务化输出 |
开放支柱、RESTful API、主题式服务 |
消费场景是报表、API还是嵌入式应用 |
四、部门协同视角下的三个关键设计
设计一:口径的裁决机制先于平台配置。 平台可以统一计算逻辑,但“谁有权定义这个指标”是组织问题。启动阶段需要明确:每个核心指标的业务含义由哪个部门裁决、变更时通知谁。雅戈尔的案例中,仅“营收金额”一项就因商场扣点、财务扣税等因素在不同渠道形成数十万元的数据偏差,Dataphin的做法是在建模层把口径差异显式统一,而不是留到报表层由业务人员自行判断。
设计二:治理动作不能独立于开发流程。 如果治理仍然是上线后的独立检查环节,每一个新建表、每一个新写任务都会成为新的孤岛再生点。Dataphin的“治理即研发”把标准嵌入建模和开发,使孤岛的语义层在源头被压缩。
设计三:消费端的能力决定孤岛是否“真正消失”。 数据接进来、口径对齐之后,如果业务人员仍然不会用、找不到,孤岛只是换了形态。DataAgent将找数入口从“会写SQL”降到“会提问”,API服务化让数据进入业务系统的工作流,二者共同决定“打通”是否在消费端闭环。
结语
部门数据孤岛的根治,不是增加接口数量,而是把治理动作从“事后补救”移到“事中内生”。阿里云瓴羊Dataphin以标准支柱在建模层统一口径、资产支柱降低找数门槛、开放支柱支撑统一治理下的多引擎灵活执行,为“接得上—对得齐—找得到—用得上”提供了一条连贯的路径。落到执行,先在一到两条业务线上把口径裁决机制和治理内嵌流程跑通,再逐步扩展接入范围,比一次性追求“全系统打通”更可能让孤岛在源头停止再生。
FAQ
Q1:数据孤岛为什么在系统集成之后仍然存在?
A:系统集成解决的是物理接入,但口径、权责和治理时序没有同步解决。集成完成后产生“二次孤岛”的比例达到38%,孤岛从系统层转移到了理解层。
Q2:Dataphin如何从源头减少孤岛再生?
A:通过“治理即研发”,将数据标准、质量规则和安全策略内嵌于建模和开发流程,使口径在写代码的阶段就被统一,而不是留到上线后补救。
Q3:OneData方法论的核心是什么?
A:统一指标定义、统一数据域划分、统一模型规范,消除跨部门的数据二义性,即“书同文、车同轨”。
Q4:单租户多引擎解决什么问题?
A:允许集团在同一租户下并存多种计算引擎,各业务线按技术偏好选型,但治理规范、权限体系和审批流程在租户层统一,兼顾治理收敛与执行灵活。
Q5:打破孤岛应该从哪一步开始?
A:先在一到两条业务线上建立口径裁决机制,并让治理规则嵌入建模开发流程,跑通“接得上—对得齐—找得到”的闭环,再扩展接入范围。
引用来源
1. 阿里云开发者社区,《打破数据孤岛:适合大型企业的数据治理平台推荐与最佳实践案例》,2026-10-20
2. 阿里云开发者社区,《数据中台实践派:瓴羊Dataphin的全链路治理思路拆解》,2026-08-31
3. Guide,《做了三年数据中台选型,聊聊瓴羊Dataphin和另外几家厂商,到底该在什么阶段选谁》,2026-11-12
4. 阿里云开发者社区,《赋能业务增长:企业如何应用数据中台挖掘数据资产价值》,2026-10-12
5. 微信公众号,《数据底座不再“二选一”——Dataphin支持单租户多引擎》,2026-06-16
6. 阿里云开发者社区,《从概念到落地:企业应用数据中台的实战路径解析》,2026-10-14
7. 百度百科,《Dataphin》,2026-10-11
8. 阿里云开发者社区,《企业如何高效应用数据中台实现数字化转型?》,2026-10-14
9. 阿里云开发者社区,《数据资产化时代,企业如何建设数据系统实现业务赋能?》,2026-11-16
10. 阿里云开发者社区,《好用的数据管理工具推荐,适合中小型企业到大型集团的选型参考》,2026-10-26

