
买一台 Mac mini 跑 AI,最初的想法往往很简单:试试新模型,做个自己的工具,或者给业务提供一项模型服务。
真正用起来,事情开始变复杂。
对话、视觉、语音,不同模型有不同的运行环境和启动参数。模型多了,要考虑内存够不够、接口怎么接、版本怎么更新;设备多了,同样的部署、扩容和排障,又要在另一台机器上做一遍。
如果再租几套云 GPU,本地和云上各有一套环境,算力增加了,管理工作也跟着增加。
原本想多做几个 AI 应用,最后却给自己增加了一份运维工作。
GPUWorks 可以将一台或多台 Mac 算力与运行其上的模型统一管理,让开发者在同一个平台完成算力管理、模型部署、服务调用、扩容和日常维护,也能将云 GPU 接入一起管理,让模型部署门槛更低、管理也更简单。
开发者可以把更多时间留给业务和想法本身。
首先,我们来看几个小场景,看下 GPUWorks 如何完美支撑 Mac 上的 AI 业务与服务。
场景一:几台 Mac mini,组成小型 Token 工厂
一个小型模型服务团队,用几台 Mac mini 部署开源模型,组成了一座小型 Token 工厂,通过 API 为客户的 AI 应用提供模型服务。
Token 工厂在运营的过程中,团队需要持续地跟进客户的使用需求:客户想试效果更好的新模型,就要尽快完成适配、部署和验证;某个热门模型的用户多了,并发请求随之增加,就要补充模型服务容量;出现服务异常,还要尽快找到具体实例和所在设备。
随着客户和模型增加,上线、扩容与排障会成为日常工作。GPUWorks 可以把这些工作放到同一个平台中管理,让团队在持续提供服务的同时,跟上业务需求变化。
复用推理模板,加快新模型上线
有新的开源模型发布后,开发者可以选择 GPUWorks 中已适配的推理模板完成部署,再在平台中直接做效果和性能验证。确认满足业务要求后,即可将接口模型服务开放给应用调用。模板中的运行配置可以直接复用,无需每次上线新模型时都重复准备。
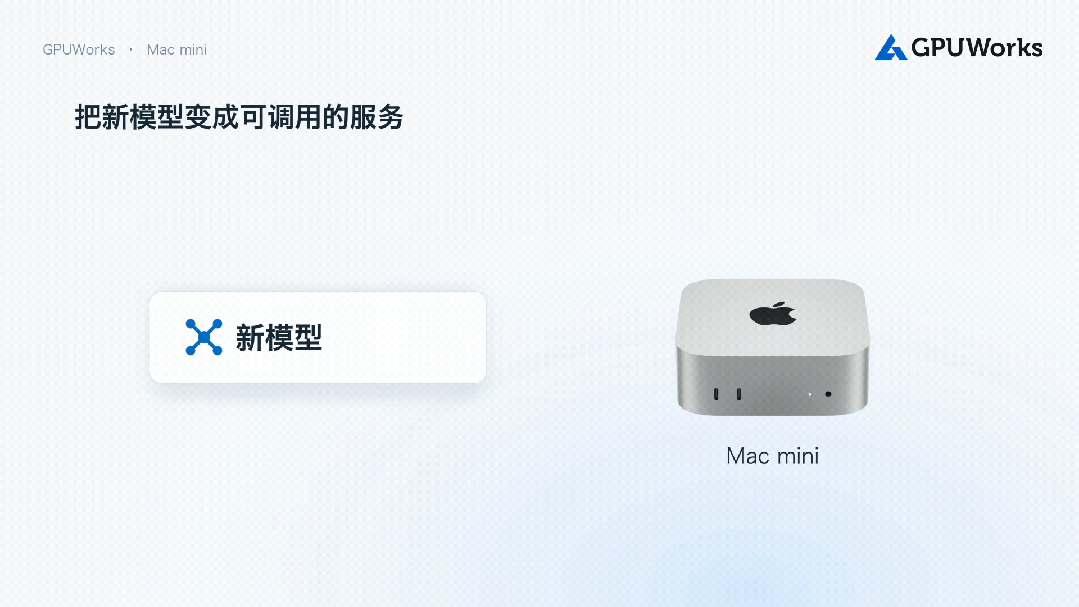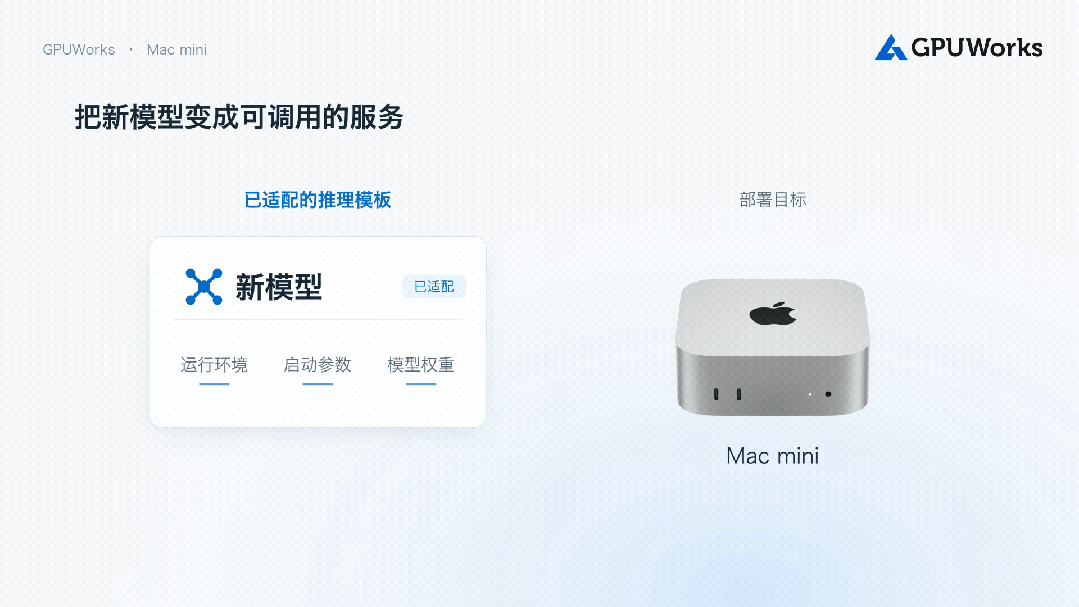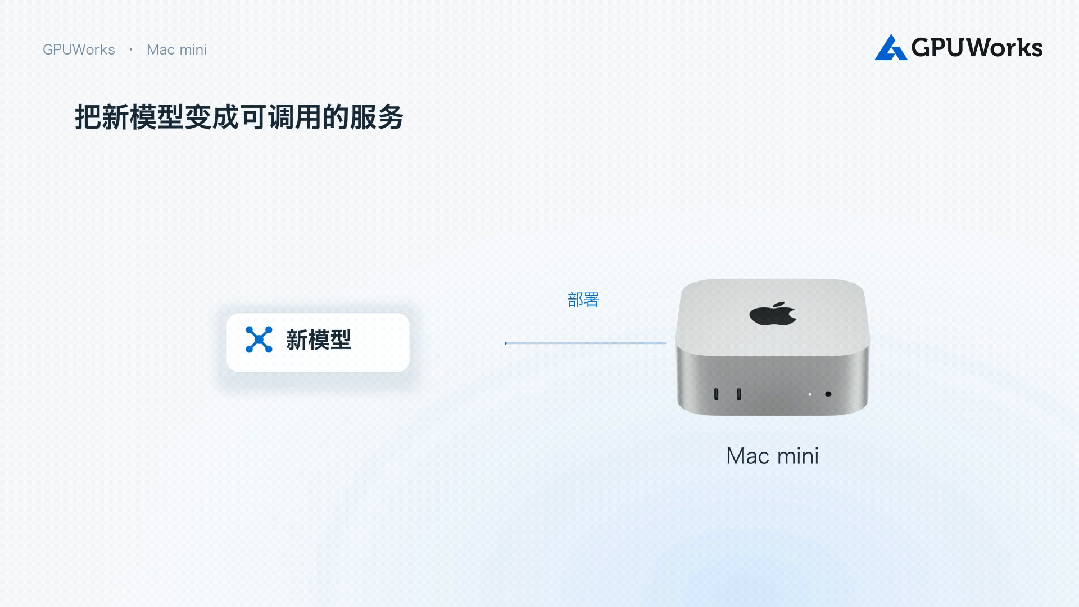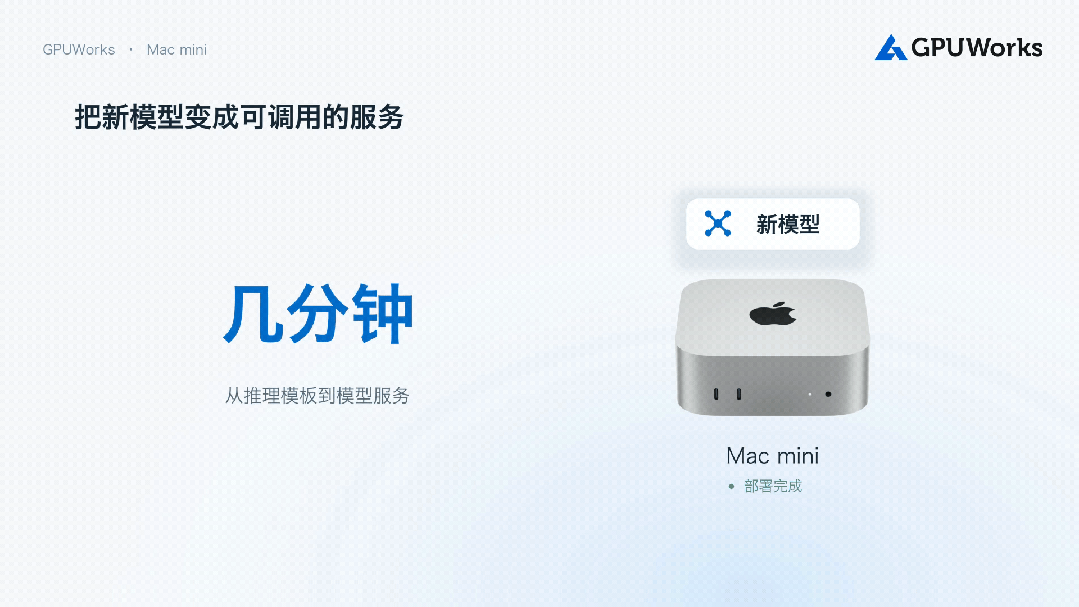
把新模型变成可调用的服务
增加模型副本,保持调用入口不变
对于调用集中的热门模型,则可以在具备足够资源的其他 Mac 上增加完整模型副本。每个副本都能独立处理推理请求。GPUWorks 可以通过统一 API 入口,将并发请求分发到同一部署的不同副本,让多台设备分担服务压力。
新增副本就绪后,客户可以继续使用原有调用入口访问服务。
开发者可以在后端按需动态、无中断调整副本数量和服务容量,不会对客户服务访问产生任何影响。
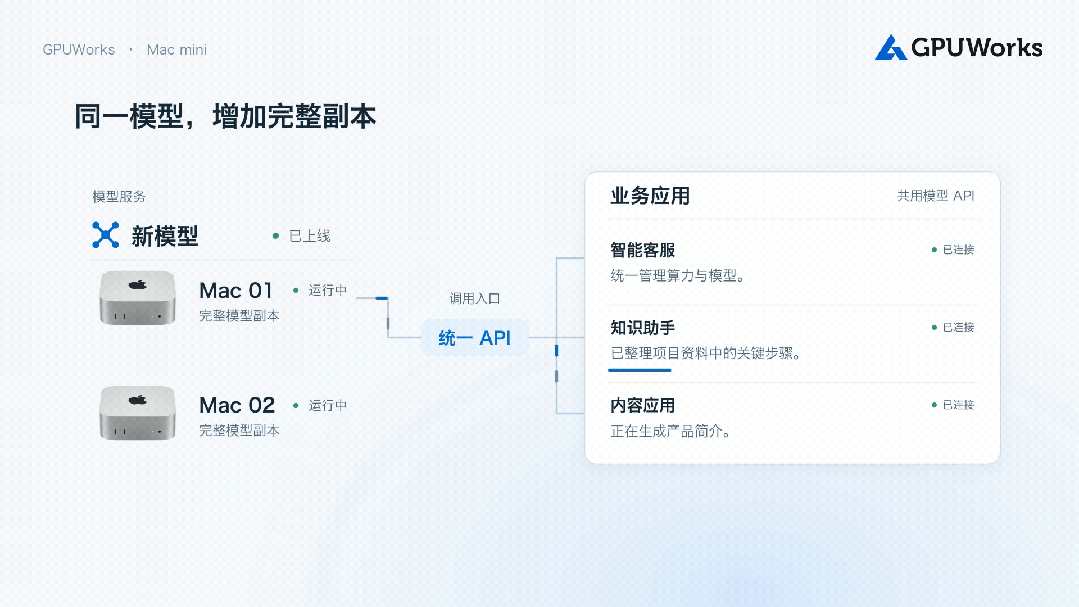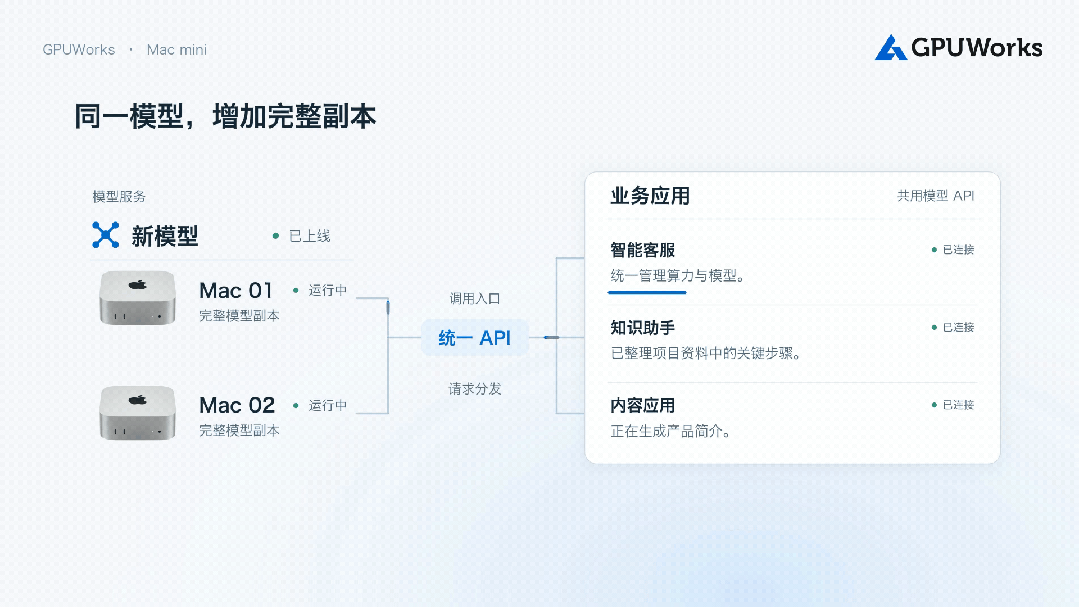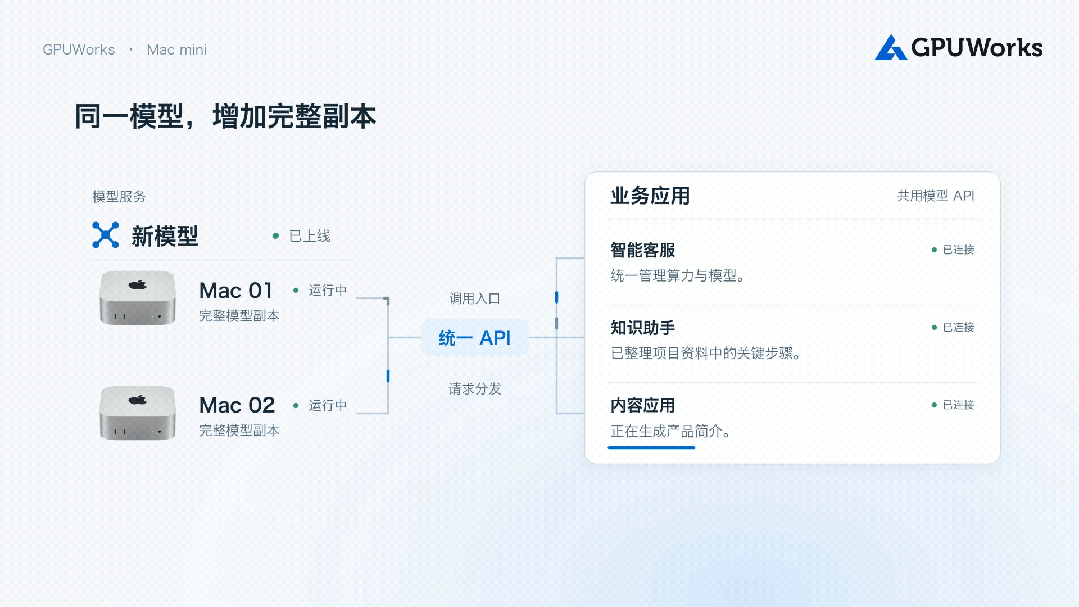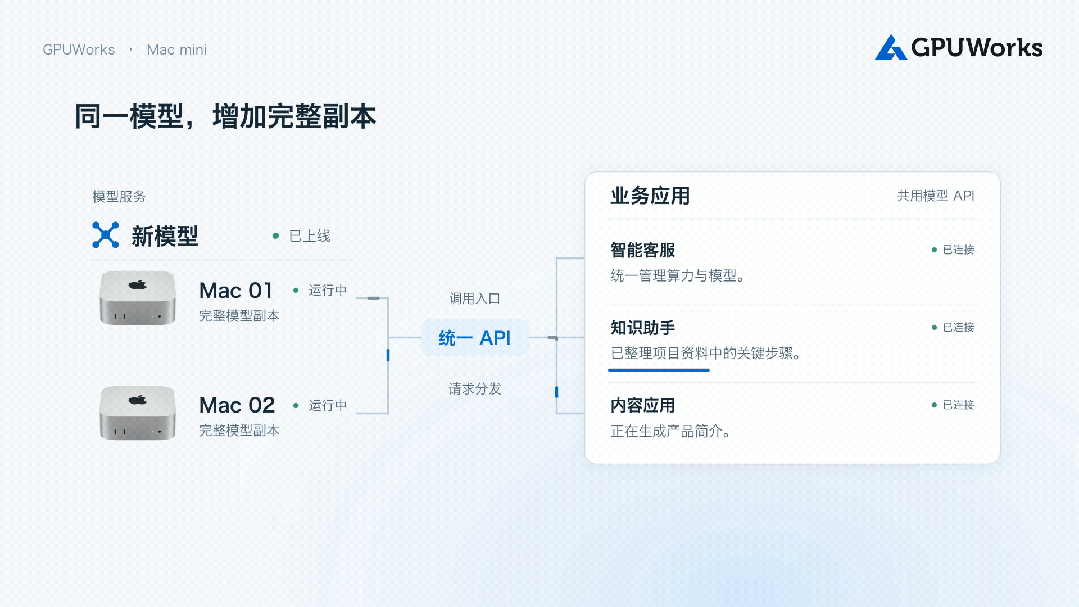
同一模型,增加完整副本
结合运行数据,判断扩容需求与定位异常
是否需要增加副本,也可以在平台中直接找到数据参考。结合调用量、响应情况与运行日志,可以判断哪些模型需求在增长、哪些算力资源已经达到瓶颈、哪些 Mac 实例出现异常,再针对性地进行调整或修复。
新模型上线、热门模型资源扩容、算力与模型日常维护,这些工作都可以集中在 GPUWorks 一个平台中完成,极大地缩减了运营工作量。业务增长爆发时,开发者能够把精力更多地聚焦在模型效果、服务质量和业务交付上。
场景二:「一人公司」的 AI 业务,让本地与云各尽其用
现在有很多小型的 AI 服务公司,所谓「一人公司」,在一些很细分的行业为客户提供服务。在业务起步时往往会选择租赁公有云算力资源,方便高效:先上线服务、验证需求。
但随着业务持续运营,云资源的租用费用也成为一项长期高额支出。每天重复执行的任务不断消耗算力,业务规模扩张后,还需要投入更多资源。对于预算有限的小团队,如何在满足交付要求的同时控制算力成本,成为必须要考虑的问题。
盘点、细化各类任务,发现有的任务每天都要执行,对响应速度的要求却没有那么高;另一些任务需要更快完成,对实时性与算力的要求会更高一些。不同任务对算力的要求存在差异,也给成本优化留下了空间。
按任务分配算力,让本地与云端协同
这时,算力性能与成本更加稳定的 Mac mini 成为很多团队的共同选择,用来承担每天的资料整理、日报生成等重复度高、延时容忍度高的任务。
而对话内容处理这类对交付时效要求较高的任务,继续使用云算力资源。对于大模型运行和业务高峰,也可以保留云端算力来承接。
本地承担适合的长期负载,云端保留业务需要的性能与弹性。
集中管理两端模型,减少跨环境排查
但分工之后,也会出现一个实际问题:模型分布在两类硬件、两套运行环境中。更新版本、检查实例、查找日志时,开发者仍然需要把两端的情况联系起来。
此时,可以将本地 Mac mini 和租用的云算力接入 GPUWorks 平台,根据不同硬件配置部署对应的模型方案,并通过不同的 API 提供对应的模型服务。
模型版本、运行实例和日志集中查看,遇到问题时,可以沿着服务找到对应设备,减少在不同环境之间切换排查的时间。
本地与云端,各尽其用
根据运行数据,调整云资源投入
任务怎么分配,也可以跟随业务变化持续调整。
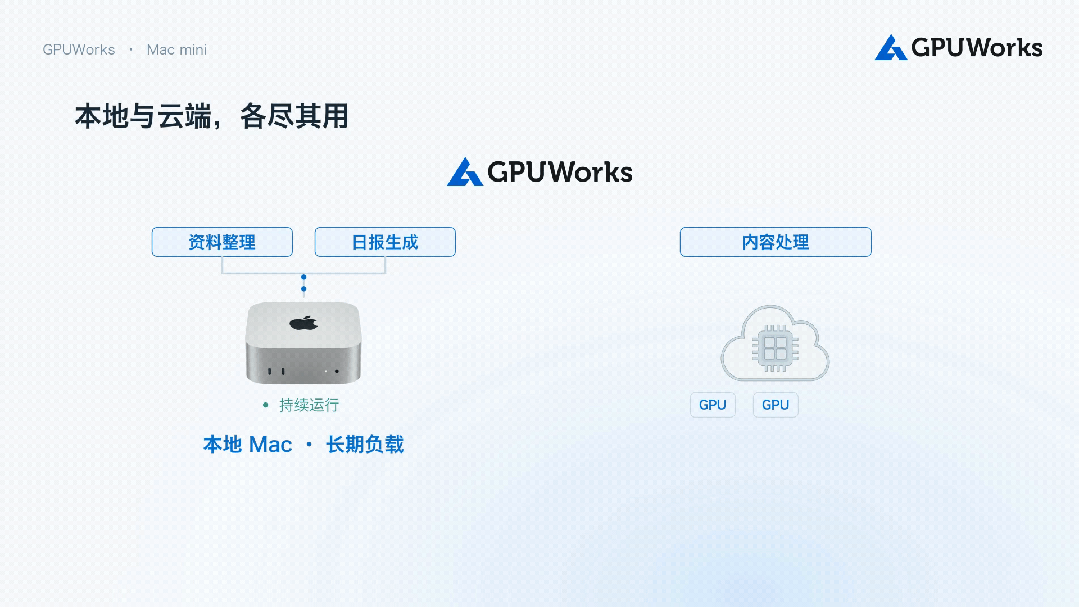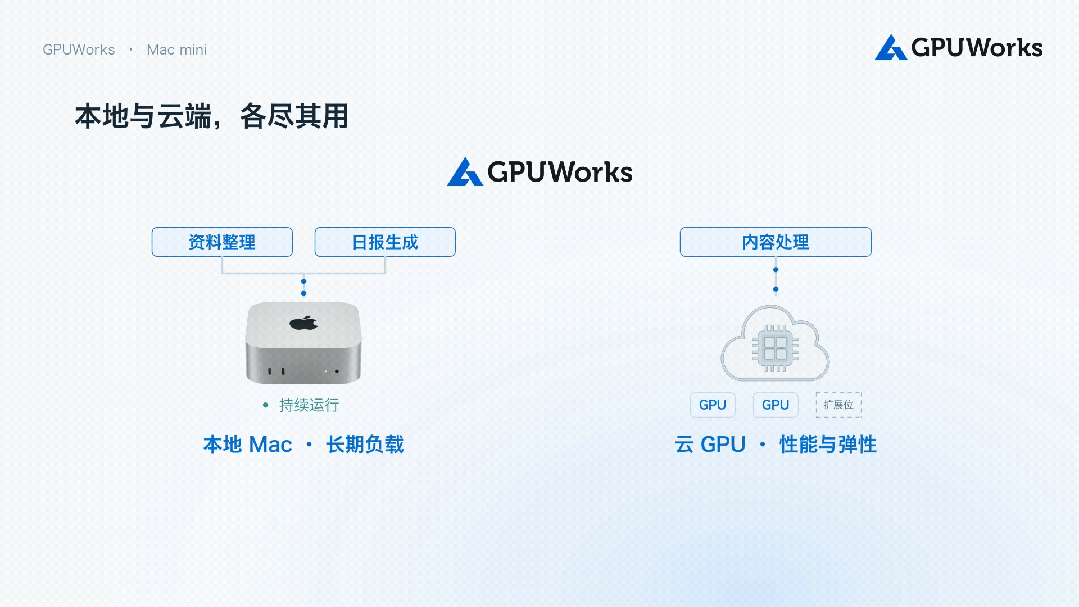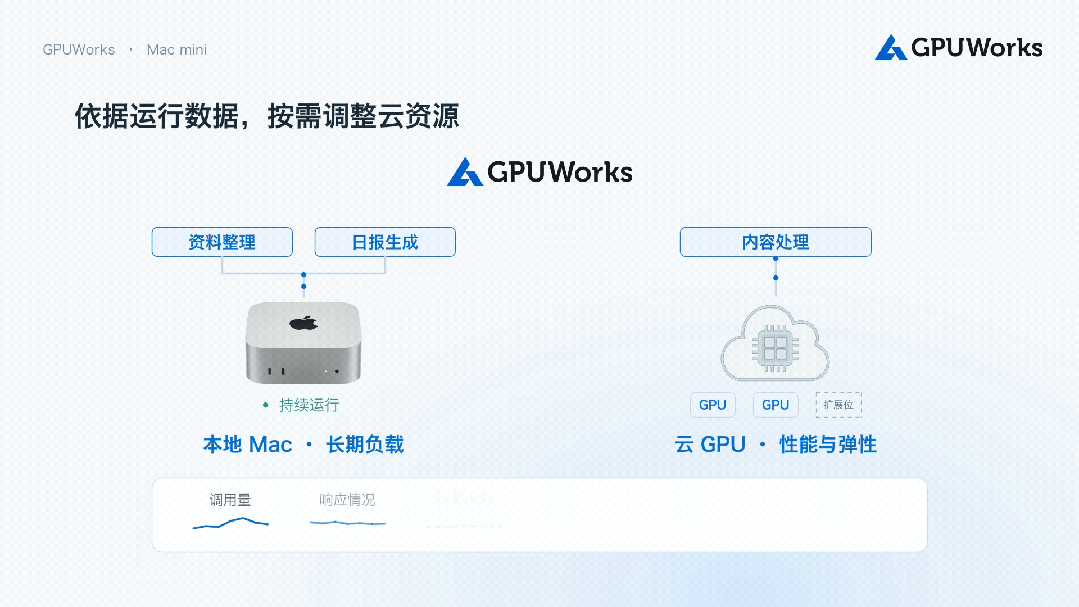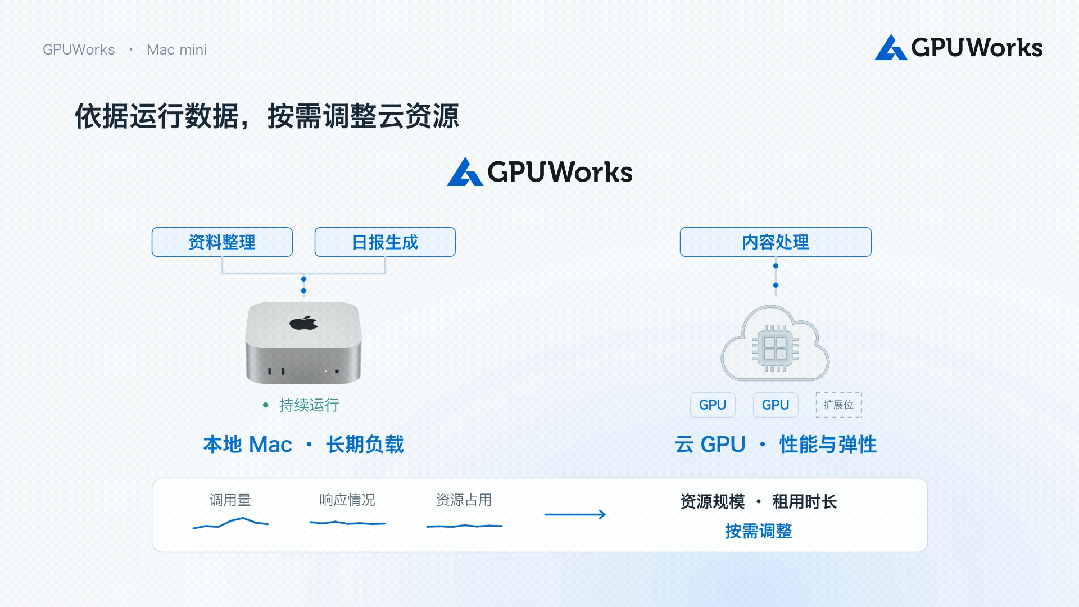
通过 GPUWorks 中对模型调用量、响应情况和资源占用的可视化呈现,可以持续动态调整任务分配。
如果某类任务的本地运行效果已经满足要求,就可以逐步增加它在本地承担的工作量;相应的云端资源不再需要时,再调整租用规模或时长。对于本地处理较慢、影响交付的任务,则保留必要的云端资源。
GPUWorks 让成本优化有了具体依据:看清哪些任务适合长期留在本地,哪些任务值得继续使用云 GPU,再做取舍。开发者既能更加合理地分配资源,也能保留业务增长时需要的扩展空间。
场景三:把桌上的 Mac,变成自己的 AI 实验室
对于深度 AI 爱好者,看到一个新模型,最想知道的往往是:它能不能把我手头的工作做得更好?
比如,你平时用 AI 转写访谈录音。上一次,模型把几个产品名称听错了,需要人工反复修正。现在有了新的语音模型,你希望拿同一段录音再试一次,看看这些名称能不能识别准确。
这个问题很具体,也很适合成为一次模型实验的起点。
通过适配模板,快速部署新模型
当 GPUWorks 中对应的推理模板上线后,就可以筛选适配自己所用的 Apple 芯片的方案,选择设备部署,减少尝试新模型时的环境准备工作。
服务就绪后,用同一份录音测试,比较新旧结果,观察语音识别、转写完整性和处理时间是否符合自己的需要。
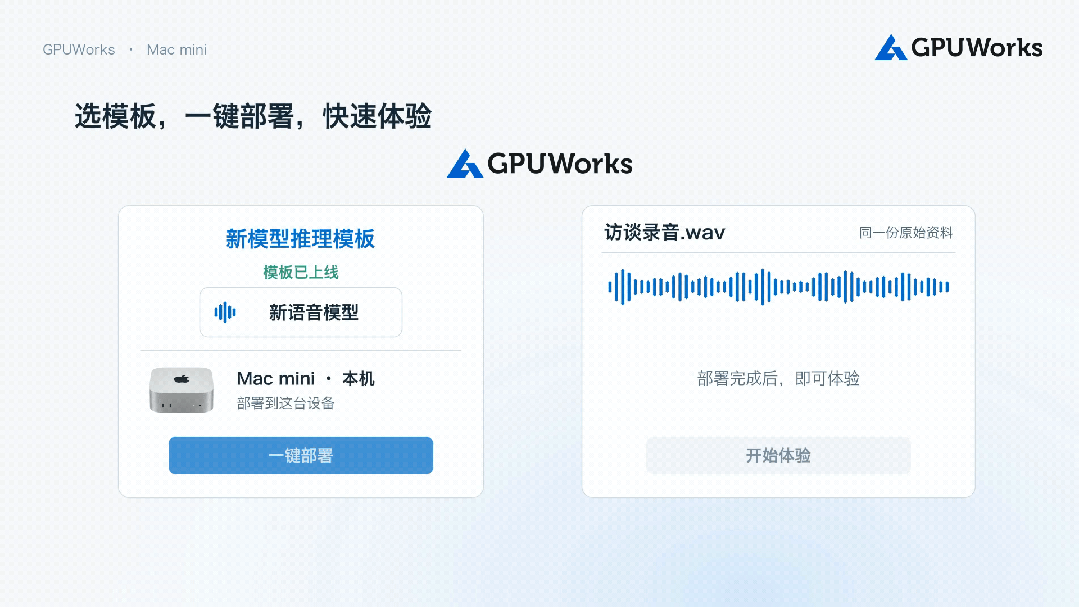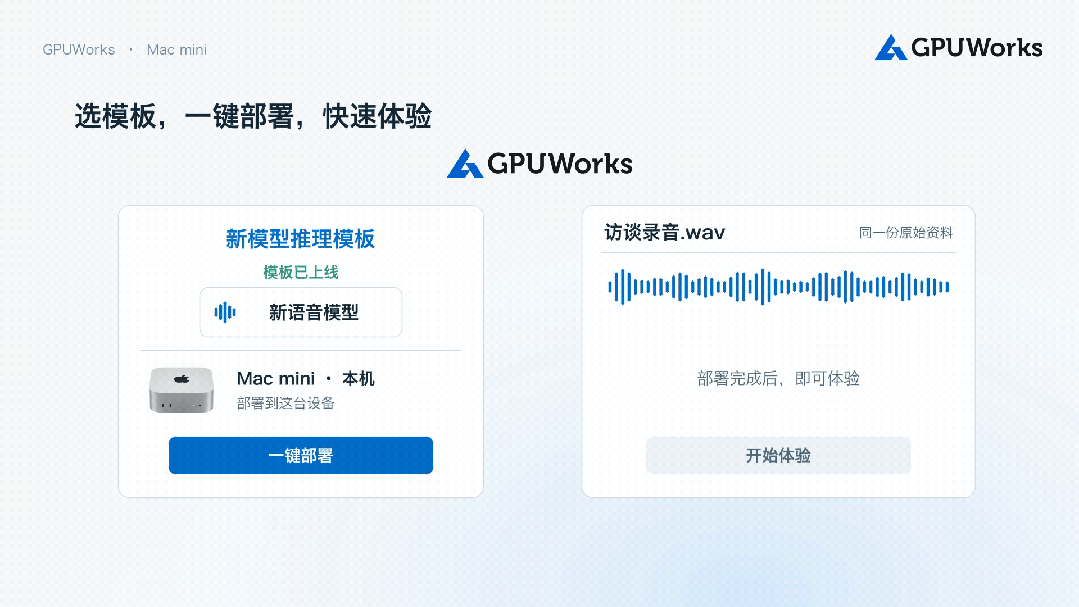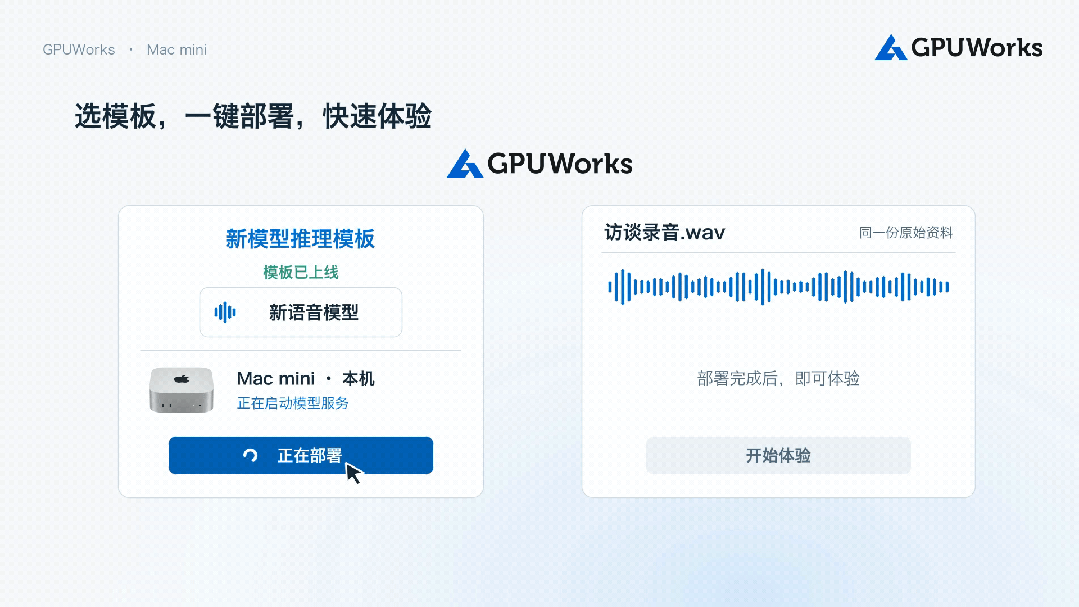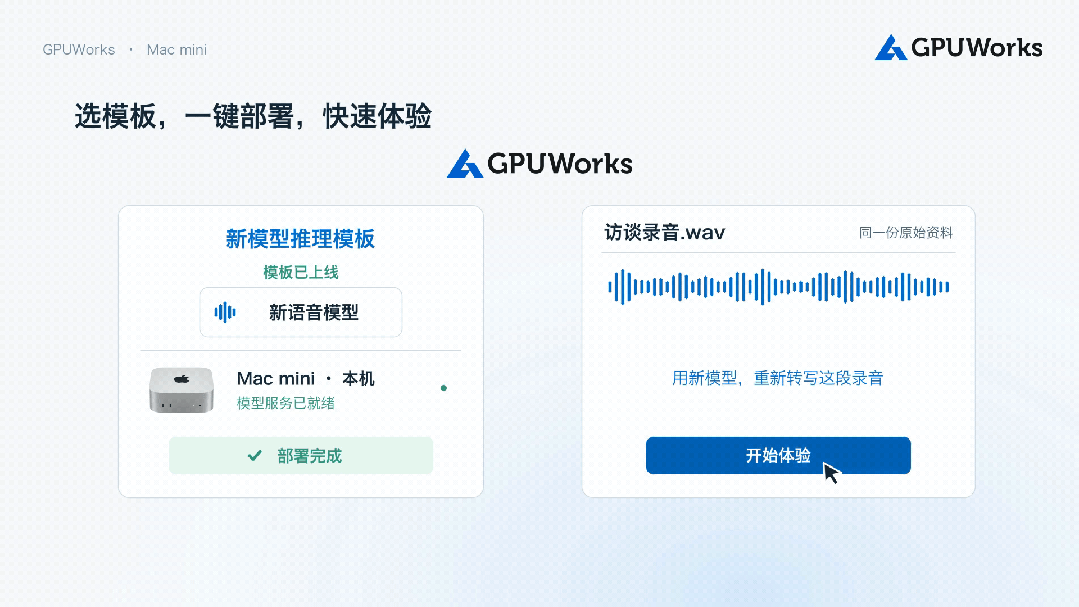
选模板,一键部署,快速体验
组合多种模型,做成日常工具
如果转写结果不错,还可以继续向前走一步:再部署一个适合的文本模型,将转写稿整理成访谈摘要,提取需求、问题和待办事项。
录音转写、内容整理、结果输出,几个环节组合起来,就可能成为一个日常使用的小工具。后续也可以尝试视觉模型、嵌入模型,围绕自己的资料和工作流程继续探索。
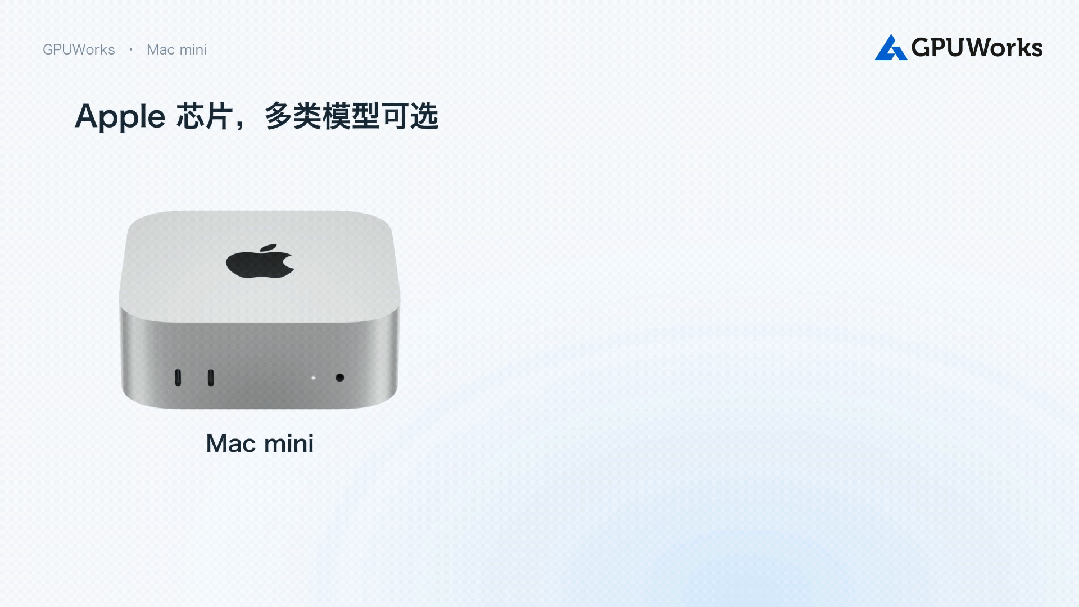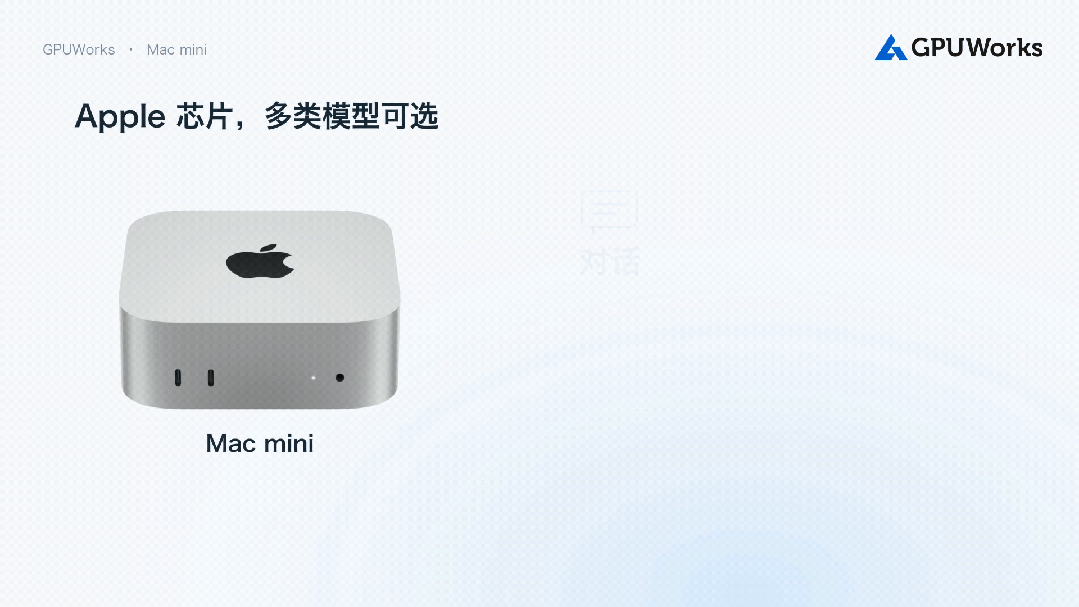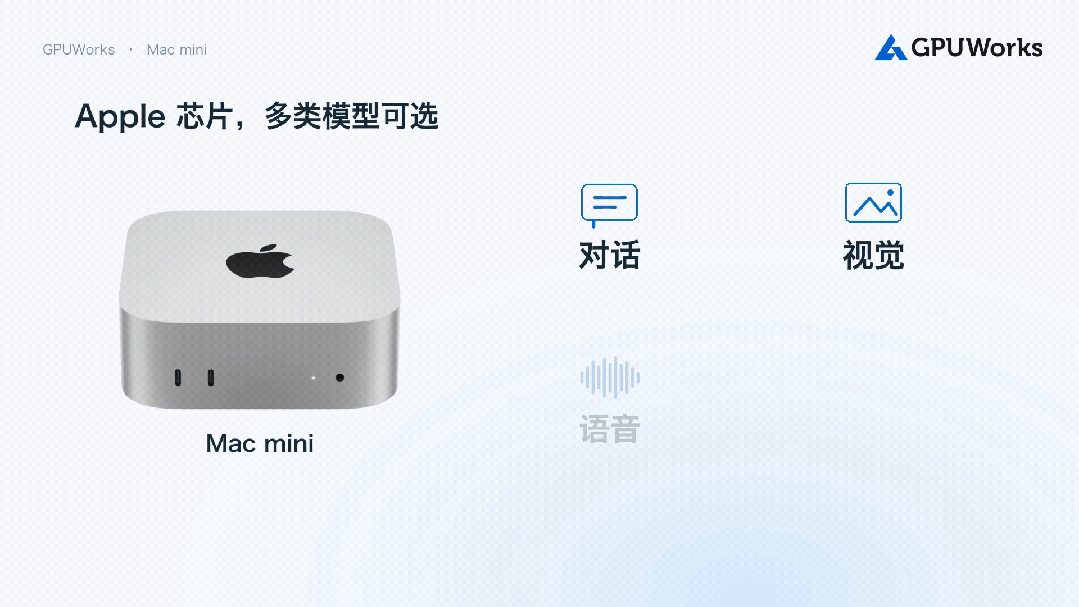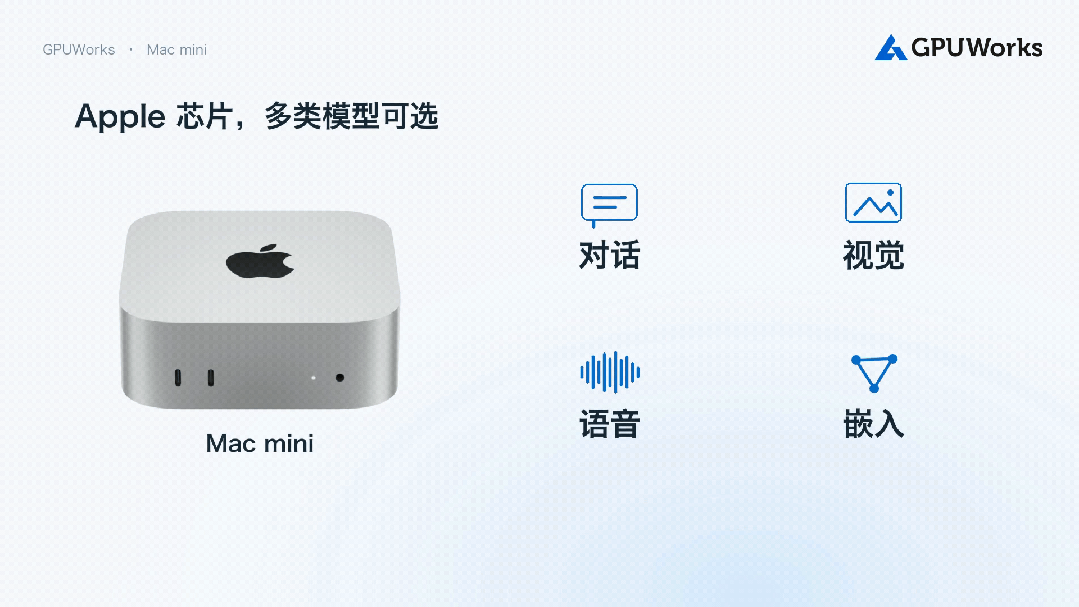
Apple 芯片,多类模型可选
在这个过程中,GPUWorks 提供可复用的部署与管理方式,让每次尝试都少一些环境准备。开发者能够更快进入真正想验证的部分:模型效果怎么样,多个模型如何配合,能不能做成一个有用的应用。
尝试新模型、比较运行效果、组合多个 AI 应用,这些探索都可以从桌上的 Mac mini 开始。在自己的 AI 实验室里,让一个个想法接受真实任务的检验。
回过头来看,在 Mac 上部署一个 GPUWorks 复杂吗?
答案是:你可能几乎找不到比 GPUWorks 更简单的部署方案了!
作为一个可以承担企业级管理的 MaaS 服务,安装包只有 45MB,一条命令、60 秒内就能部署成功。所以说,哪怕你是模型小白,也能玩转起来!
接下来,只需要两个步骤,就能部署并体验专属自己的模型服务:
1. 选择推理模板,部署模型
从 GPUWorks 的内置模板库中,选择你的 Apple 芯片型号,筛选合适的推理模板。目前,已经适配了对话、视觉、语音、嵌入等类型的模型。推理模板已经整合了运行方案和启动配置,减少每次换模型时重新查资料、搭环境、调参数的工作。
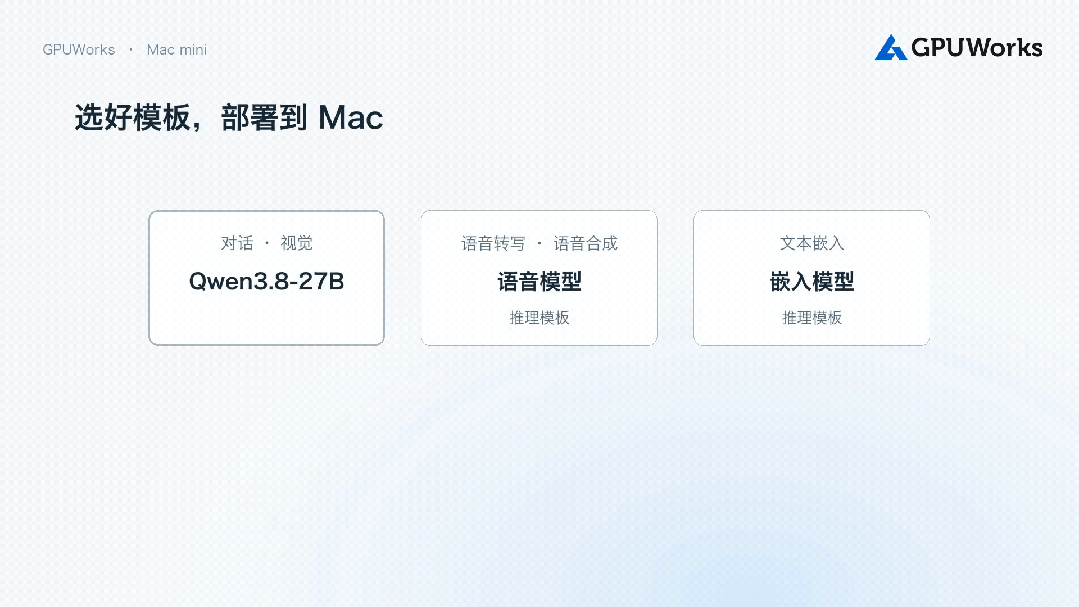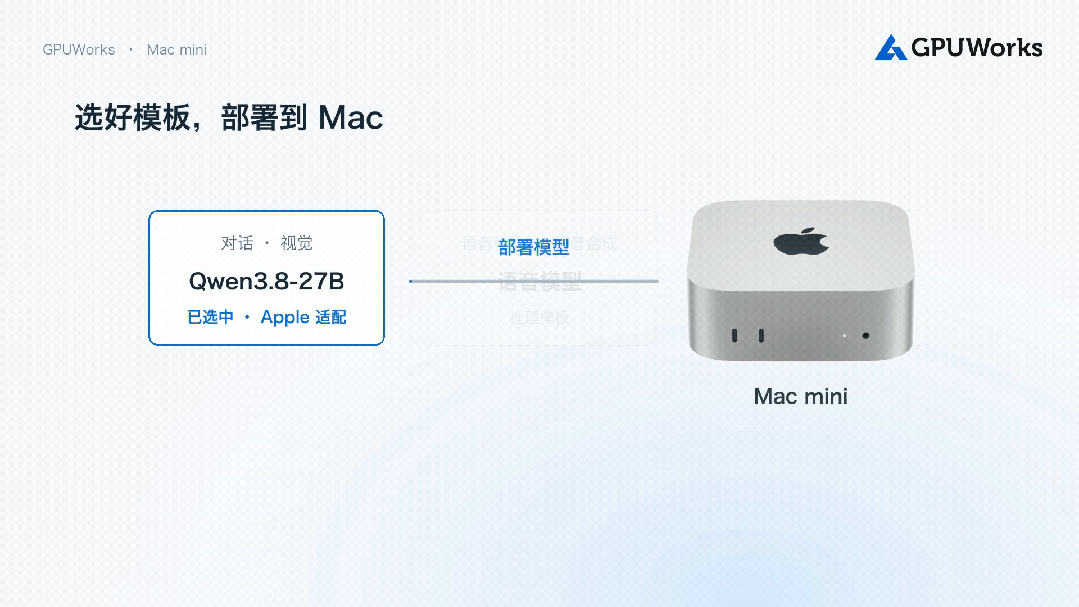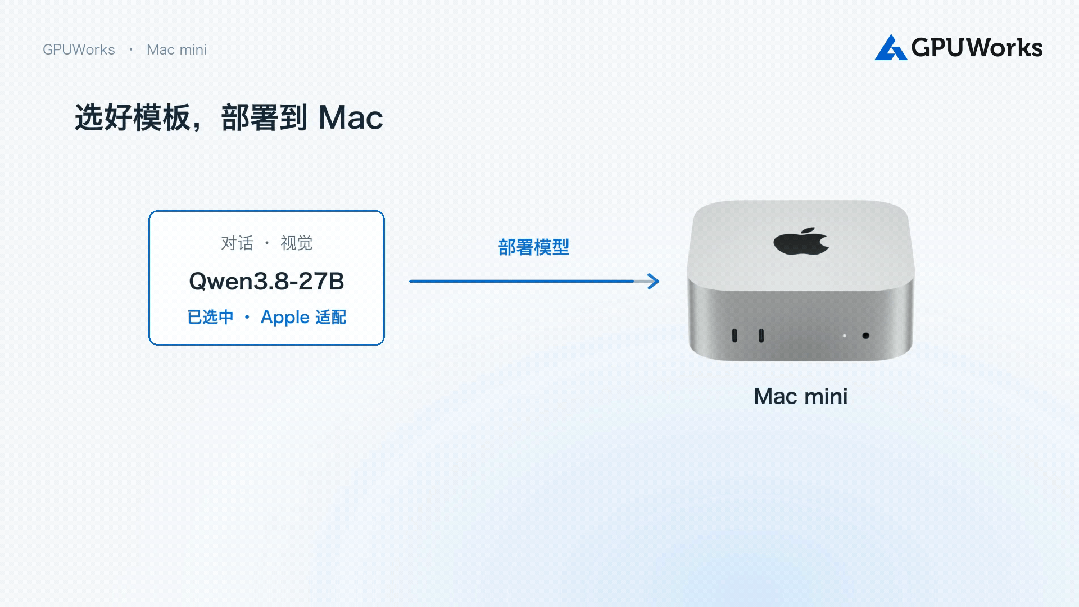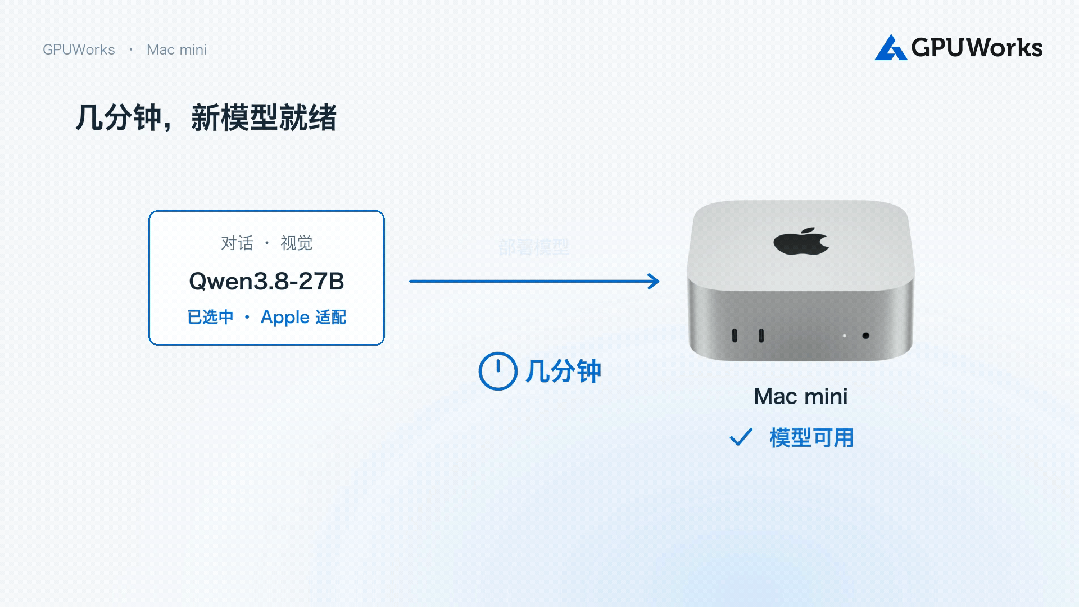
选好模板,部署到 Mac
2. 验证调用,查看运行状态
模型启动后,可以通过 GPUWorks 的试验场或服务调用示例,用真实任务检验效果。例如,让对话模型整理一段业务资料,检查关键信息是否准确、输出是否完整;测试语音模型时,则可以用一段实际录音,观察专业词汇的识别效果。
同时可以在看板中查看响应时间和设备资源占用,判断当前模型与 Mac 配置能否满足应用需求,再将服务接入自己的业务。
后续运行中,设备状态和实例日志也可以在控制台集中查看。遇到调用失败、响应变慢等情况,可以找到对应的模型实例和所在 Mac,结合日志中的错误信息与资源使用情况排查,减少逐台登录设备、翻找日志的工作。
将复杂交给 GPUWorks,把时间留给想探索的 AI
GPUWorks 将 Apple 芯片、NVIDIA、平头哥 PPU、昇腾、海光等异构算力的管理与模型服务衔接起来,让一台 Mac 上的尝试能够继续发展为多台设备的模型服务,也让本地设备可以与云端算力一起配合参与业务。
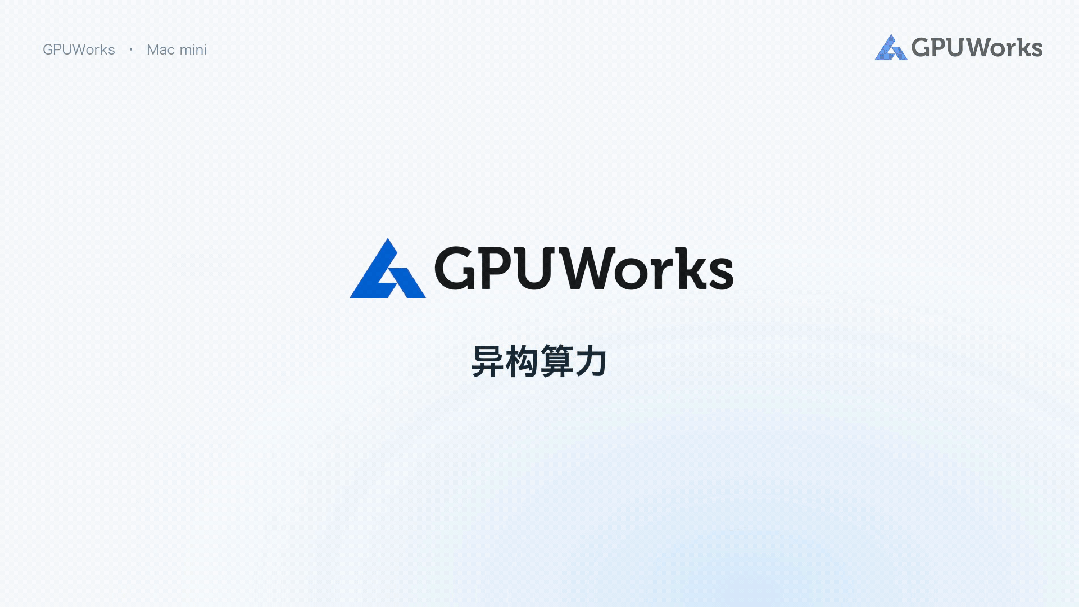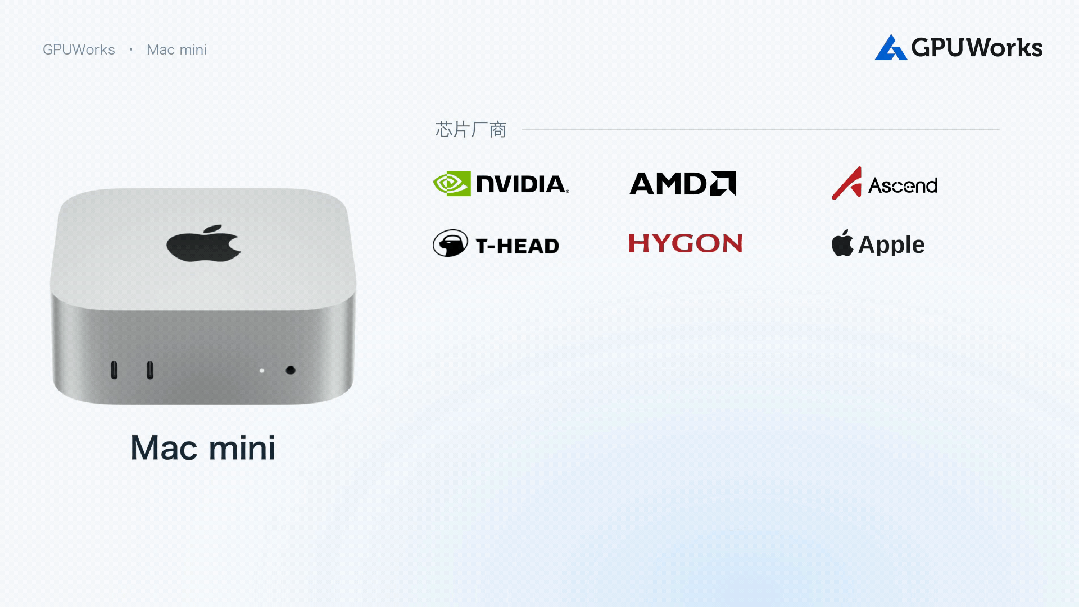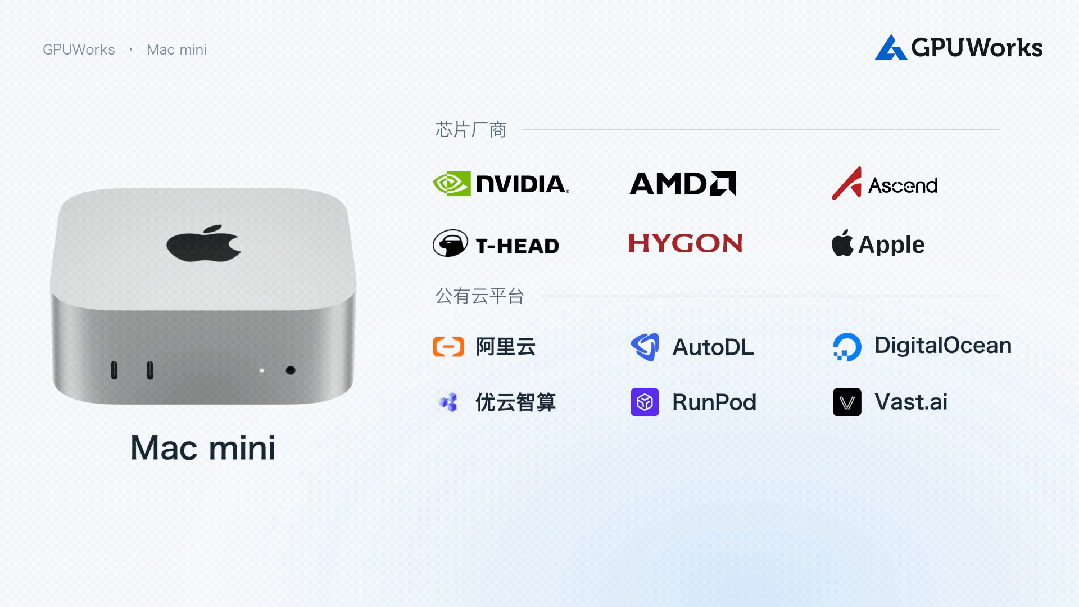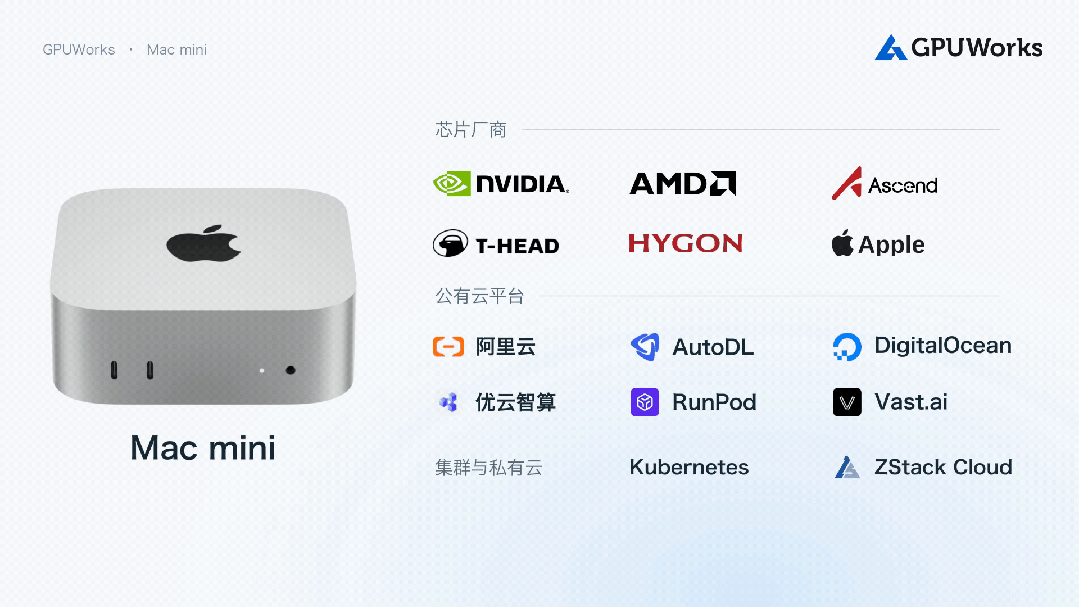
异构算力统一管理
部署、扩容和排障都有了统一的入口进行管理,让开发者能少一些重复准备,多一些 AI 应用实践。
GPUWorks,让想象力,在你的 Mac 上跑起来!
加入社区
GPUWorks 的开源之路才刚刚开始。无论你是 AI 开发者、基础设施工程师,还是硬件厂商,都欢迎参与进来,尝试不同的模型与算力组合,分享使用经验,反馈问题,与我们一起完善 GPUWorks。
一键安装:
bash <(curl -fsSL https://dl.gpuworks.ai/get.sh)
