
深度残差收缩网络(Deep Residual Shrinkage Network,DRSN)是一种专为强噪声背景下一维信号特征提取而设计的深度学习架构。该网络源于发表在 IEEE Transactions on Industrial Informatics 期刊上的论文 Deep Residual Shrinkage Networks for Fault Diagnosis,通过在残差网络中嵌入软阈值化模块与自适应阈值估计子网络,自动抑制无关及噪声特征。本文将结合原论文图4介绍该网络的结构设计,并给出对应的PyTorch完整实现。
一、网络结构介绍
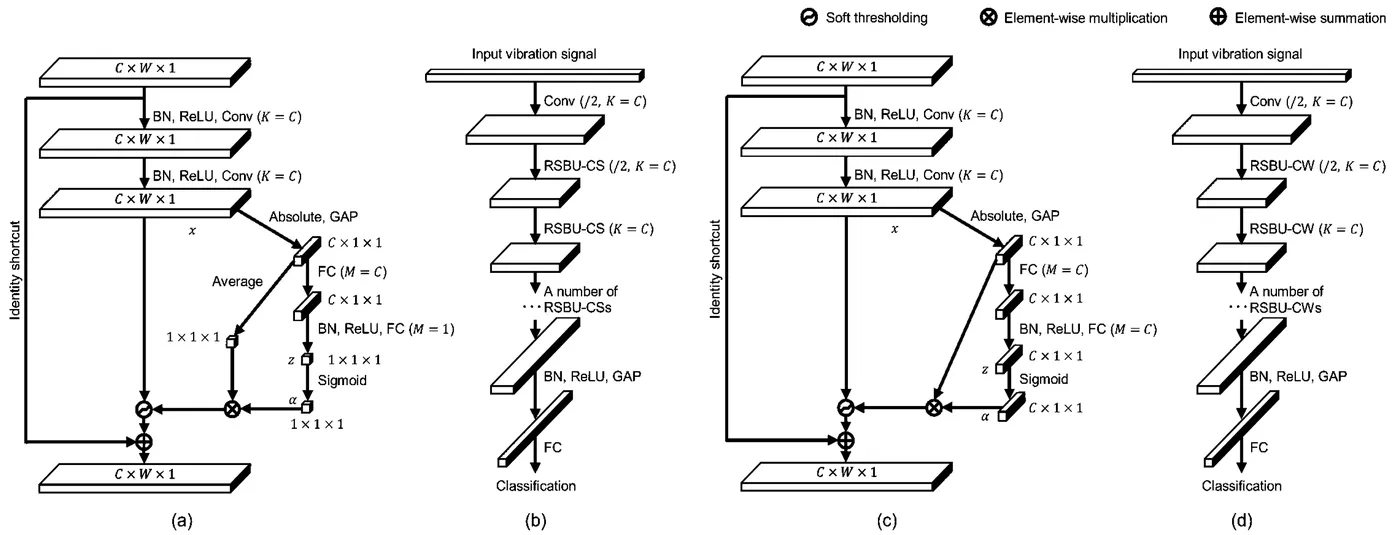
图4 深度残差收缩网络构建单元与整体架构,其中 (a) 为通道共享阈值构建单元RSBU-CS,(b) 为DRSN-CS 整体架构,(c) 为通道独立阈值构建单元RSBU-CW,(d) 为DRSN-CW整体架构
深度残差收缩网络以经典残差网络为骨架,将基础残差单元替换为具备特征去噪能力的残差收缩构建单元,核心结构如下:
软阈值化操作
软阈值化作为非线性收缩层嵌入到构建单元末尾,用于将绝对值低于阈值的近零特征直接置零,同时对绝对值大于阈值的正负特征向零方向进行等幅收缩,在消除噪声干扰的同时保留有用的正负特征信息。通道共享阈值构建单元与网络(RSBU-CS与DRSN-CS)
如图4(a)所示,RSBU-CS在“批归一化—激活函数—一维卷积”两次堆叠构成的主分支之后,接入了一个轻量化阈值估计子网络:主分支输出的特征图先取绝对值并经过全局平均池化压缩为一维向量,再依次通过第一层全连接层、批归一化、激活函数、第二层输出单一神经元的平滑全连接层以及归一化激活函数,得到取值在零到一之间的缩放系数;同时对特征图所有元素取绝对值均值,将该全局均值与缩放系数相乘,即可得到所有通道共用的阈值。特征图经过软阈值化收缩后,与恒等快捷连接分支逐元素相加。将多个RSBU-CS单元堆叠,即构成如图4(b)所示的DRSN-CS。通道独立阈值构建单元与网络(RSBU-CW 与 DRSN-CW)
如图4(c)所示,RSBU-CW的主分支及快捷连接与RSBU-CS一致,区别在于其阈值估计子网络的第二层全连接层神经元数量等于特征图通道数,从而为每个通道分别生成独立的缩放系数;随后将各通道的缩放系数与对应通道自身的特征绝对值均值逐通道相乘,为不同通道赋予独立的收缩阈值。将多个RSBU-CW单元堆叠,即构成如图4(d)所示的DRSN-CW。整体网络配置
如图4(b)和图4(d)所示,一维原始信号输入后,首先经过一层步长为2的一维卷积层进行初步特征提取与下采样;随后依次通过三个阶段的残差收缩构建单元(每个阶段首先通过一个步长为2的构建单元使特征长度减半、通道数翻倍,再连接三个步长为1的常规构建单元);最后依次经过批归一化、激活函数、全局平均池化和全连接输出层,完成最终的分类映射。
二、PyTorch程序实现
以下基于PyTorch实现原论文中的软阈值化模块、RSBU-CS、RSBU-CW构建单元以及完整的DRSN-CS和DRSN-CW网络架构:
import torch
import torch.nn as nn
import torch.nn.functional as F


class SoftThresholding(nn.Module):
    """软阈值化非线性收缩层"""

    def forward(self, x: torch.Tensor, tau: torch.Tensor) -> torch.Tensor:
        return torch.sign(x) * F.relu(torch.abs(x) - tau)


class RSBU_CS(nn.Module):
    """通道共享阈值的残差收缩构建单元 (对应图 4(a))"""

    def __init__(
        self,
        in_channels: int,
        out_channels: int,
        kernel_size: int = 3,
        stride: int = 1,
    ) -> None:
        super().__init__()
        padding = kernel_size // 2

        # 残差主分支: BN -> ReLU -> Conv -> BN -> ReLU -> Conv
        self.bn1 = nn.BatchNorm1d(in_channels)
        self.relu1 = nn.ReLU(inplace=True)
        self.conv1 = nn.Conv1d(
            in_channels, out_channels, kernel_size=kernel_size, stride=stride, padding=padding
        )

        self.bn2 = nn.BatchNorm1d(out_channels)
        self.relu2 = nn.ReLU(inplace=True)
        self.conv2 = nn.Conv1d(
            out_channels, out_channels, kernel_size=kernel_size, stride=1, padding=padding
        )

        # 通道共享阈值估计子网络
        self.fc1 = nn.Linear(out_channels, out_channels)
        self.bn_fc = nn.BatchNorm1d(out_channels)
        self.relu_fc = nn.ReLU(inplace=True)
        self.fc2 = nn.Linear(out_channels, 1)
        self.sigmoid = nn.Sigmoid()

        self.soft_thresholding = SoftThresholding()

        # 维度变化时通过 1x1 卷积匹配恒等快捷连接维度
        if stride != 1 or in_channels != out_channels:
            self.shortcut = nn.Conv1d(
                in_channels, out_channels, kernel_size=1, stride=stride, bias=False
            )
        else:
            self.shortcut = nn.Identity()

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        identity = self.shortcut(x)

        out = self.conv1(self.relu1(self.bn1(x)))
        out = self.conv2(self.relu2(self.bn2(out)))

        # 取绝对值并在特征宽度维度做全局平均池化
        abs_mean_c = torch.mean(torch.abs(out), dim=2)
        # 计算全局特征绝对值均值
        abs_mean_all = torch.mean(abs_mean_c, dim=1, keepdim=True).unsqueeze(-1)

        # 计算通道共享缩放系数与阈值
        z = self.fc1(abs_mean_c)
        z = self.fc2(self.relu_fc(self.bn_fc(z)))
        alpha = self.sigmoid(z).unsqueeze(-1)
        tau = alpha * abs_mean_all

        out = self.soft_thresholding(out, tau)
        return out + identity


class RSBU_CW(nn.Module):
    """通道独立阈值的残差收缩构建单元 (对应图 4(c))"""

    def __init__(
        self,
        in_channels: int,
        out_channels: int,
        kernel_size: int = 3,
        stride: int = 1,
    ) -> None:
        super().__init__()
        padding = kernel_size // 2

        # 残差主分支: BN -> ReLU -> Conv -> BN -> ReLU -> Conv
        self.bn1 = nn.BatchNorm1d(in_channels)
        self.relu1 = nn.ReLU(inplace=True)
        self.conv1 = nn.Conv1d(
            in_channels, out_channels, kernel_size=kernel_size, stride=stride, padding=padding
        )

        self.bn2 = nn.BatchNorm1d(out_channels)
        self.relu2 = nn.ReLU(inplace=True)
        self.conv2 = nn.Conv1d(
            out_channels, out_channels, kernel_size=kernel_size, stride=1, padding=padding
        )

        # 通道独立阈值估计子网络
        self.fc1 = nn.Linear(out_channels, out_channels)
        self.bn_fc = nn.BatchNorm1d(out_channels)
        self.relu_fc = nn.ReLU(inplace=True)
        self.fc2 = nn.Linear(out_channels, out_channels)
        self.sigmoid = nn.Sigmoid()

        self.soft_thresholding = SoftThresholding()

        # 维度变化时通过 1x1 卷积匹配恒等快捷连接维度
        if stride != 1 or in_channels != out_channels:
            self.shortcut = nn.Conv1d(
                in_channels, out_channels, kernel_size=1, stride=stride, bias=False
            )
        else:
            self.shortcut = nn.Identity()

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        identity = self.shortcut(x)

        out = self.conv1(self.relu1(self.bn1(x)))
        out = self.conv2(self.relu2(self.bn2(out)))

        # 取绝对值并在特征宽度维度做全局平均池化,保留各通道均值
        abs_mean_c = torch.mean(torch.abs(out), dim=2)

        # 计算各通道独立的缩放系数与阈值
        z = self.fc1(abs_mean_c)
        z = self.fc2(self.relu_fc(self.bn_fc(z)))
        alpha = self.sigmoid(z)
        tau = (alpha * abs_mean_c).unsqueeze(-1)

        out = self.soft_thresholding(out, tau)
        return out + identity


class DRSN(nn.Module):
    """深度残差收缩网络整体架构 (对应图 4(b) 与图 4(d))"""

    def __init__(
        self,
        block_type: str = "cw",
        in_channels: int = 1,
        num_classes: int = 8,
    ) -> None:
        super().__init__()
        block_type = block_type.lower()
        if block_type == "cs":
            block_cls = RSBU_CS
        elif block_type == "cw":
            block_cls = RSBU_CW
        else:
            raise ValueError("block_type 仅支持 'cs' 或 'cw'")

        # 初始下采样卷积层
        self.conv_in = nn.Conv1d(in_channels, 4, kernel_size=3, stride=2, padding=1)

        # 三个残差收缩阶段:每阶段包含 1 个步长为 2 的单元和 3 个步长为 1 的单元
        self.stage1 = self._make_stage(block_cls, 4, 4, num_blocks=4, first_stride=2)
        self.stage2 = self._make_stage(block_cls, 4, 8, num_blocks=4, first_stride=2)
        self.stage3 = self._make_stage(block_cls, 8, 16, num_blocks=4, first_stride=2)

        # 分类输出层: BN -> ReLU -> GAP -> FC
        self.bn_out = nn.BatchNorm1d(16)
        self.relu_out = nn.ReLU(inplace=True)
        self.fc_out = nn.Linear(16, num_classes)

        self._init_weights()

    @staticmethod
    def _make_stage(
        block_cls: type,
        in_channels: int,
        out_channels: int,
        num_blocks: int,
        first_stride: int,
    ) -> nn.Sequential:
        layers = [block_cls(in_channels, out_channels, kernel_size=3, stride=first_stride)]
        for _ in range(1, num_blocks):
            layers.append(block_cls(out_channels, out_channels, kernel_size=3, stride=1))
        return nn.Sequential(*layers)

    def _init_weights(self) -> None:
        for m in self.modules():
            if isinstance(m, nn.Conv1d):
                nn.init.kaiming_normal_(m.weight, mode="fan_out", nonlinearity="relu")
                if m.bias is not None:
                    nn.init.zeros_(m.bias)
            elif isinstance(m, nn.BatchNorm1d):
                nn.init.ones_(m.weight)
                nn.init.zeros_(m.bias)
            elif isinstance(m, nn.Linear):
                nn.init.kaiming_normal_(m.weight, nonlinearity="relu")
                if m.bias is not None:
                    nn.init.zeros_(m.bias)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        out = self.conv_in(x)
        out = self.stage1(out)
        out = self.stage2(out)
        out = self.stage3(out)

        out = self.relu_out(self.bn_out(out))
        out = torch.mean(out, dim=2)  # 全局平均池化
        logits = self.fc_out(out)
        return logits


def drsn_cs(in_channels: int = 1, num_classes: int = 8) -> DRSN:
    """构建 DRSN-CS 模型"""
    return DRSN(block_type="cs", in_channels=in_channels, num_classes=num_classes)


def drsn_cw(in_channels: int = 1, num_classes: int = 8) -> DRSN:
    """构建 DRSN-CW 模型"""
    return DRSN(block_type="cw", in_channels=in_channels, num_classes=num_classes)


if __name__ == "__main__":
    # 构造一维输入信号张量进行前向传播测试 (批大小=8, 通道数=1, 信号长度=2048)
    dummy_input = torch.randn(8, 1, 2048)

    for name, model in [("DRSN-CS", drsn_cs()), ("DRSN-CW", drsn_cw())]:
        output = model(dummy_input)
        num_params = sum(p.numel() for p in model.parameters() if p.requires_grad)
        print(f"{name} | 输出维度: {tuple(output.shape)} | 可训练参数量: {num_params:,}")
三、程序结构要点说明
- 张量维度流转:网络接收三维张量输入(批大小、通道数、信号长度),经过初始卷积层和三个残差收缩阶段逐级下采样后,在全局平均池化层压缩为二维特征向量,最终经全连接层输出对应类别数的预测向量。
- 快捷连接对齐:当构建单元执行步长为2的下采样或通道数翻倍时,
shortcut分支自动启用卷积核大小为1、相同步长的一维卷积调整特征图尺寸,确保主分支与快捷连接分支顺利相加。 - 可微分软阈值实现:
SoftThresholding模块利用符号函数与截断线性整流函数组合完成软阈值计算,整个阈值学习与特征收缩过程均可直接通过反向传播进行端到端优化。
参考文献
Deep Residual Shrinkage Networks for Fault Diagnosis[J]. IEEE Transactions on Industrial Informatics, 2020.
