发动机故障诊断智能体(二):基础时序压缩与长短期记忆编码网络

简介: 在智能体完成气路多航段时序数据的采集与规整后,高维度的原始时序信号需要经过深度表征与降维处理,以消除高频测量噪声并提炼本质物理趋势。采用长短期记忆自编码器架构,在脱离人工标签监督的情况下,利用海量正常运行数据进行自监督重构训练,构建出能够压缩并表征发动机稳态工况与退化趋势的时序特征提取模型。

在智能体完成气路多航段时序数据的采集与规整后,高维度的原始时序信号需要经过深度表征与降维处理,以消除高频测量噪声并提炼本质物理趋势。论文《Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios》将这一功能封装为独立的基础时序编码网络。该网络采用长短期记忆自编码器架构,在脱离人工标签监督的情况下,利用海量正常运行数据进行自监督重构训练,构建出能够压缩并表征发动机稳态工况与退化趋势的时序特征提取模型。
ScreenShot_2026-09-18_192354_226.png

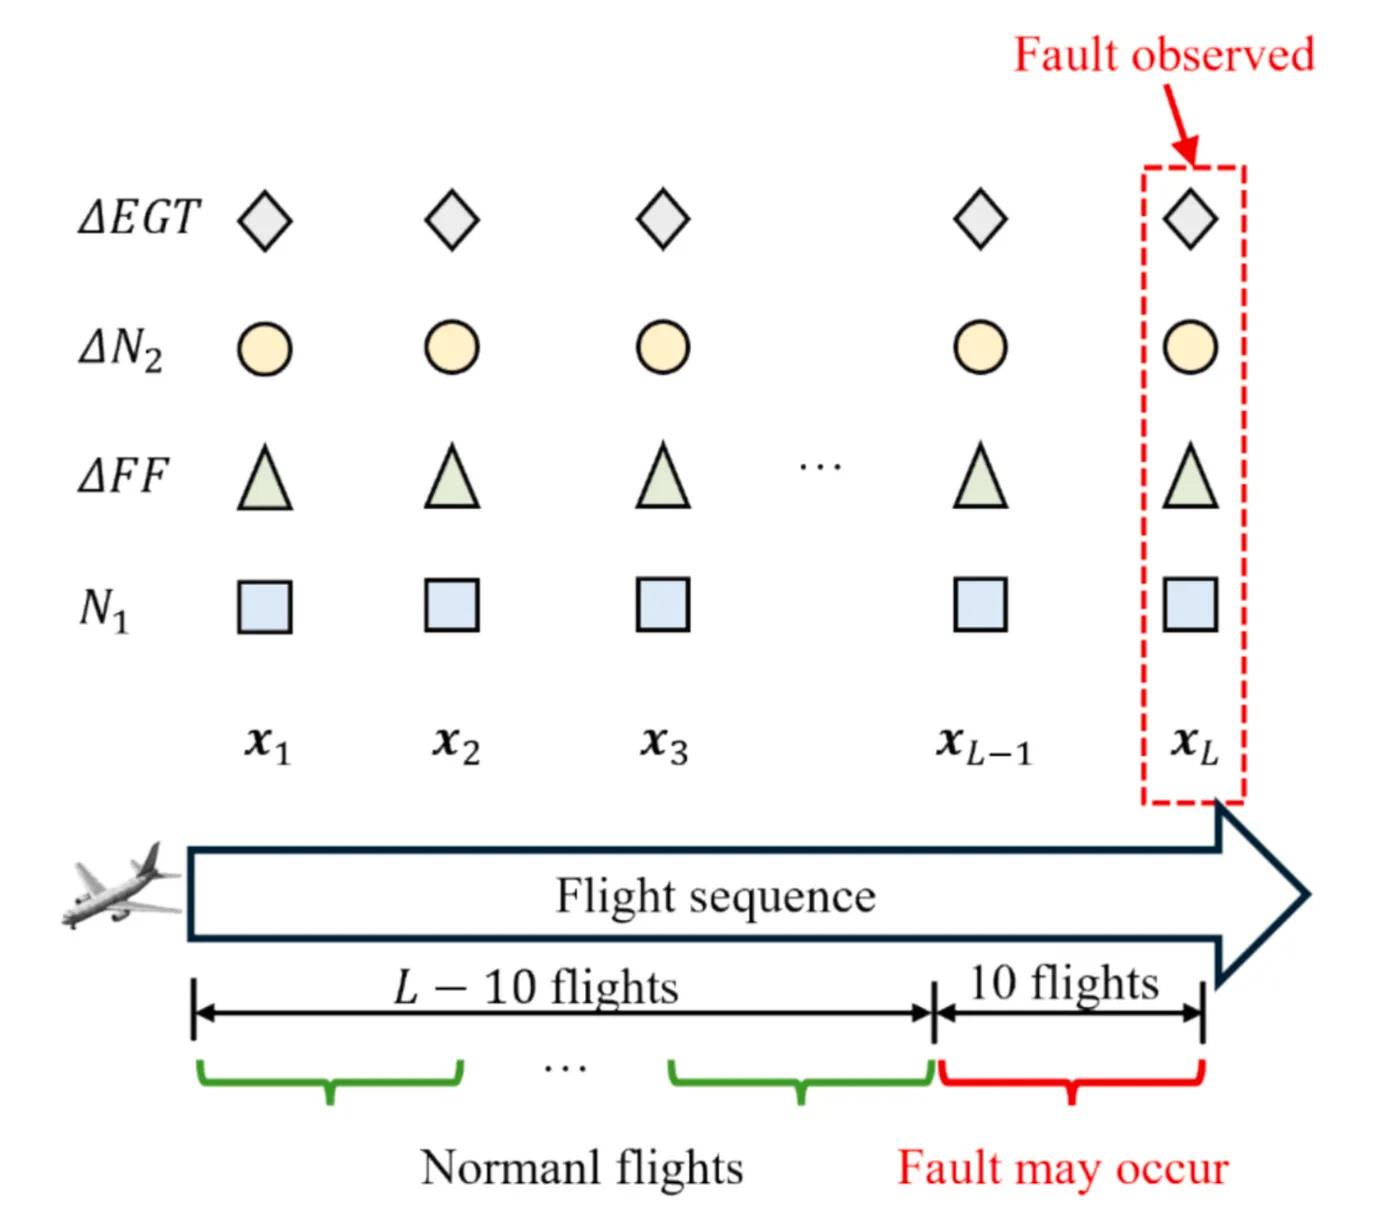
该编码网络在预训练阶段的数据输入完全依赖于发动机全生命周期中的正常飞行片段。在实际机队运营中,发动机大部分时间处于稳定可靠的健康服役期,由此沉淀了海量且连续的正常气路监测序列。数据输入模块将这些健康时段的多航段飞行数据切割为标准化时序样本,并直接作为自编码器的训练源。利用海量正常样本进行自监督学习,能够避免微量且异构的故障数据在基础特征提取阶段对网络权重产生方向性干扰,确保模型建立起客观且具有全局泛化性的基准特征分布。
ScreenShot_2026-09-18_192408_813.png

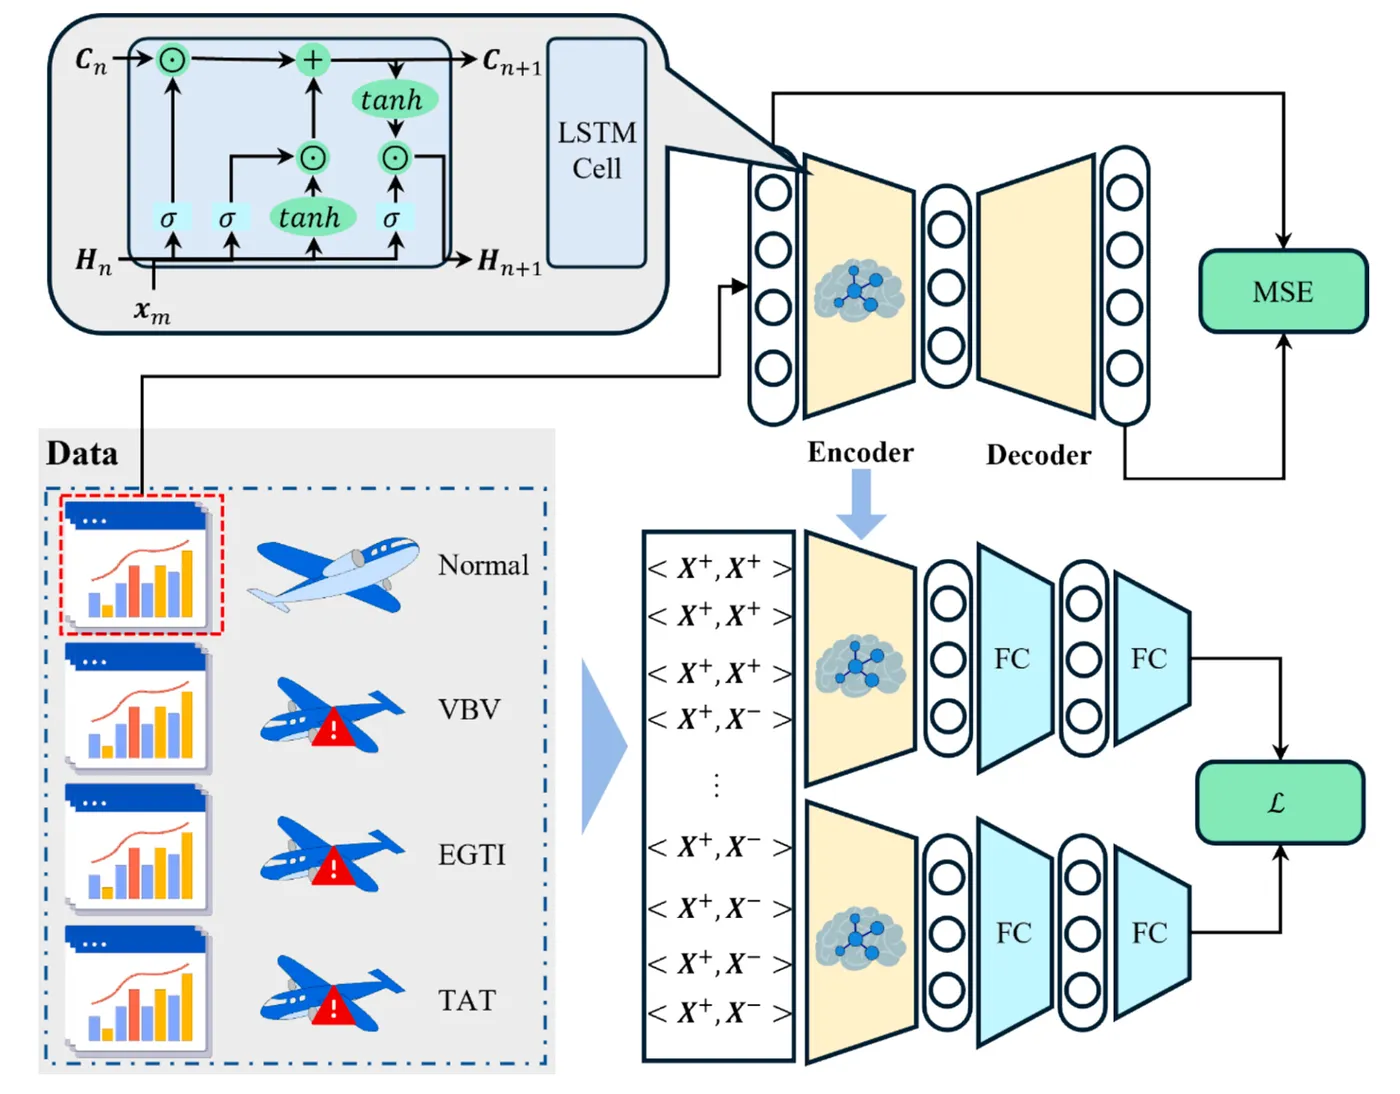
长短期记忆时序编码器是该模块执行特征压缩的核心组件。多航段气路监测序列沿时间维度被逐个飞行步送入编码网络中,网络内部的记忆单元通过输入门、遗忘门和输出门的非线性门控机制,协同调控历史飞行状态的保留与更新。输入门负责筛选当前航段中具有物理意义的参数变化,遗忘门自适应剔除无关的历史稳态冗余,而输出门则控制当前时态特征的显式传递。通过在时间步上的连续递归传递,输入时序最后一个航段的隐层状态被完整提取出来,作为整合了整个多航段时序动态信息的低维瓶颈特征向量。

为了在无监督条件下验证并驱动特征提取的有效性,网络在结构上对称配置了长短期记忆时序解码器。解码网络接收编码器输出的低维瓶颈向量作为初始状态,通过沿时间维度逐步解算,尝试完整还原出原始的多通道、多航段输入序列。训练过程以重构输出时序与原始真实输入时序之间的均方误差作为损失约束,通过梯度反向传播算法联合优化编码器与解码器的权重参数,促使网络在自监督学习中自发收敛。

这种编码-解码对称重构机制在物理上构成了较为严密的时序信息瓶颈。由于低维瓶颈向量的维度远小于原始多航段矩阵的数据体量,网络无法直接记住所有数值细节,这一强约束迫使编码器主动舍弃随机传感扰动和高频噪声,转而提取排气温度、转速与燃油流量等关键参数之间固有的物理耦合关系与退化演变规律,在隐层空间内开展了对高维动态时序的高保真、低冗余压缩表征。

在自编码器完成收敛后,解码器结构被剥离并舍弃,仅保留具备深度时序特征提取能力的编码器网络。该编码器的参数权重被固化并输出,直接作为后续特征区分模块以及强化学习决策智能体的前端初始化骨干。作为诊断智能体的基础表征中枢,基础时序压缩与长短期记忆编码网络从结构上实现了从高维时序测量到紧凑隐层表征的非线性映射,为下游模块开展故障类别细化与决策提供了较好的特征支撑。

参考文献:
Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios[J]. Advanced Engineering Informatics, 2025, 65(C): 103297.
https://www.sciencedirect.com/science/article/pii/S1474034625001909

相关文章
|
25天前
|
机器学习/深度学习 前端开发
发动机故障诊断智能体(三):特征可分性优化与加权对比投影层
在基础时序编码网络完成对正常工况的压缩表征后,尽管模型具备了提取稳态规律的能力,但在面对多种不同类型的微量气路故障时,潜在空间中的特征分布仍可能存在相互交叠的现象。该组件致力于通过引入度量对比学习机制,在特定的低维投影空间内重塑特征拓扑结构,系统性优化不同故障模式之间的几何可分性。
|
25天前
|
人工智能 自然语言处理 API
觉得阿里云大模型价格太高怎么办?四种便宜购买与使用方法分享
本文针对阿里云大模型“能力强但调用成本高”的普遍痛点,梳理了一套可落地的全链路省钱方案。从开通百炼领取超7000万Tokens新人免费额度起步,叠加夜间错峰4折起的Night Plan活动,再搭配Token Plan订阅与AI通用型节省计划,四层优惠叠加后,实际调用成本可降至普通按量付费的三到五成,帮助个人开发者与团队大幅降低大模型落地的综合开支。
398 12
|
25天前
|
人工智能 前端开发 API
阿里云百炼官网链接及百炼控制台入口在哪?前台产品页与后台控制台功能区分,免费 Tokens 领取查询
阿里云百炼是AI大模型服务平台,提供前台官网(介绍、计费、领免费Token)与后台控制台(API Key管理、Token用量查询、模型配置)。新用户可领超7000万Tokens(每模型100万),支持按量付费或订阅省钱计划。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens
438 4
|
25天前
|
人工智能 缓存 数据库
常青翻新|Mock 不是万能替身:Dummy/Stub/Spy/Mock/Fake 五种 Test Double 的边界与踩坑
本文厘清测试替身的五大分类(Dummy/Stub/Spy/Mock/Fake),指出滥用“万能Mock”导致测试脆弱或假绿的根源:混淆“提供数据”与“验证交互”。强调选型核心原则——**先明确断言对象(数据?交互?真实行为?),再决定替身类型**,并结合AI场景(如Agent轨迹验证、假模型替代)赋予经典模式新生命力。
|
25天前
|
自然语言处理 安全 测试技术
别再只测『答得对不对』:给大模型应用建一套 Prompt 注入红队回归集,把越权/泄密挡在上线前
本文揭示RAG客服应用因缺乏Prompt注入防护而致系统提示词泄露的事故,指出问题根源在于测试只关注“答得对”,却忽视“会不会答不该答的”。提出将注入测试升级为可回归的红队用例集:结构化存于jsonl,覆盖四类注入;用pytest参数化断言输出、工具调用与拒答行为;接入CI自动拦截。安全不是模型天赋,而是靠可执行、可演进的断言守出来的。
别再只测『答得对不对』:给大模型应用建一套 Prompt 注入红队回归集,把越权/泄密挡在上线前
|
25天前
|
运维 调度
数字员工任务中断怎么办:失败分型、断点续跑与幂等重跑
把重复劳动交给数字员工之后,工程上绕不开一个问题:任务跑到一半中断了怎么办。这篇文章给一套实操框架,先做中断分型,再谈怎么让它可观测,最后谈怎么恢复,三步之外加一道结果校验兜底。
202 8
|
25天前
|
人工智能 自然语言处理 安全
阿里云千问办公 QwenWork详细介绍:产品核心能力、典型场景、价格及常见问题解答
在AI技术快速落地办公场景的当下,市面上绝大多数智能工具依旧停留在问答对话、文本摘要、简单文案改写层面,只能完成碎片化单点任务。企业员工处理一份完整业务工作时,往往需要同时开启多款工具,文档处理、数据分析、素材创作、网页制作分属不同软件,中间内容需要反复复制粘贴,即便借助通用大模型生成内容,输出成果还需要大量二次格式调整,才能达到交付标准。同时企业内部的数据分散在聊天记录、审批单据、本地文档、业务平台,普通AI工具无法直接读取内部业务信息,每一次任务都要人工复述背景条件,法务、财务、研发这类垂直岗位,还需要编写冗长提示词才能拿到相对可用结果,AI办公落地的实际门槛长期居高不下。千问办公Qwen
560 9
|
25天前
|
存储 弹性计算 人工智能
阿里云服务器ECS是什么?介绍、优势、创建流程及使用教程
阿里云ECS是高性能、高可用的弹性云服务器,支持分钟级创建、灵活升降配与全球部署。依托自研CIPU架构,单实例SLA达99.975%,网络延迟低至8微秒,适配网站托管、AI训练、数据库等全场景需求。(239字)

热门文章

最新文章