
摘要:热搜上隔三差五出现"某某大模型又崩了",实时广场里一片哀嚎,交给AI跑的任务跟着中断。这篇记录我自己的判断和改造过程:把工作流押在单一模型上,崩的就不只是模型,而是整条业务链路;我把架构改成"统一网关+一主一备",落地载体是AI大模型API聚合平台。个人经验,仅供参考。
大模型又崩了上热搜那天,我也在实时广场里看哀嚎——但我的任务没停。不是运气好,是半年前吃过一次亏之后,我把工作流从单一模型迁到了AI大模型API聚合平台(用一个统一API入口调用多家大模型的服务)上:主模型限流或异常时,网关自动切到备用模型,应用侧基本无感。我的结论很直接:模型崩不崩我管不了,但工作流有没有退路,是我自己能管的。
大模型又崩了,为什么中断的是我的工作流?
我的答案:中断工作流的从来不是"模型崩了"这件事,而是"整条链路只绑定一个模型"的架构——上游一抖动,没有任何环节能接住。
我的三次遭遇,一次比一次清醒。第一次,正在跑的批量任务全断,重跑花了一晚上,我以为是偶发;第二次赶上高峰期限流才明白,大模型服务依赖推理算力和并发额度,这两样都会紧张,限流和局部故障是常态而不是意外;第三次最隐蔽,模型版本迭代后,同一批提示词的输出行为变了,下游解析跟着出错——这种"没崩但变了"的漂移,比崩溃更难排查。
据中国信通院《人工智能产业发展研究报告(2025年)》,2024年我国公有云大模型Token调用量约2000万亿次(Token是大模型计费的最小文本单位)——模型调用已经是企业IT的常规支出。一笔常规支出,可用性却系于单点,这是我下决心改架构的全部原因。
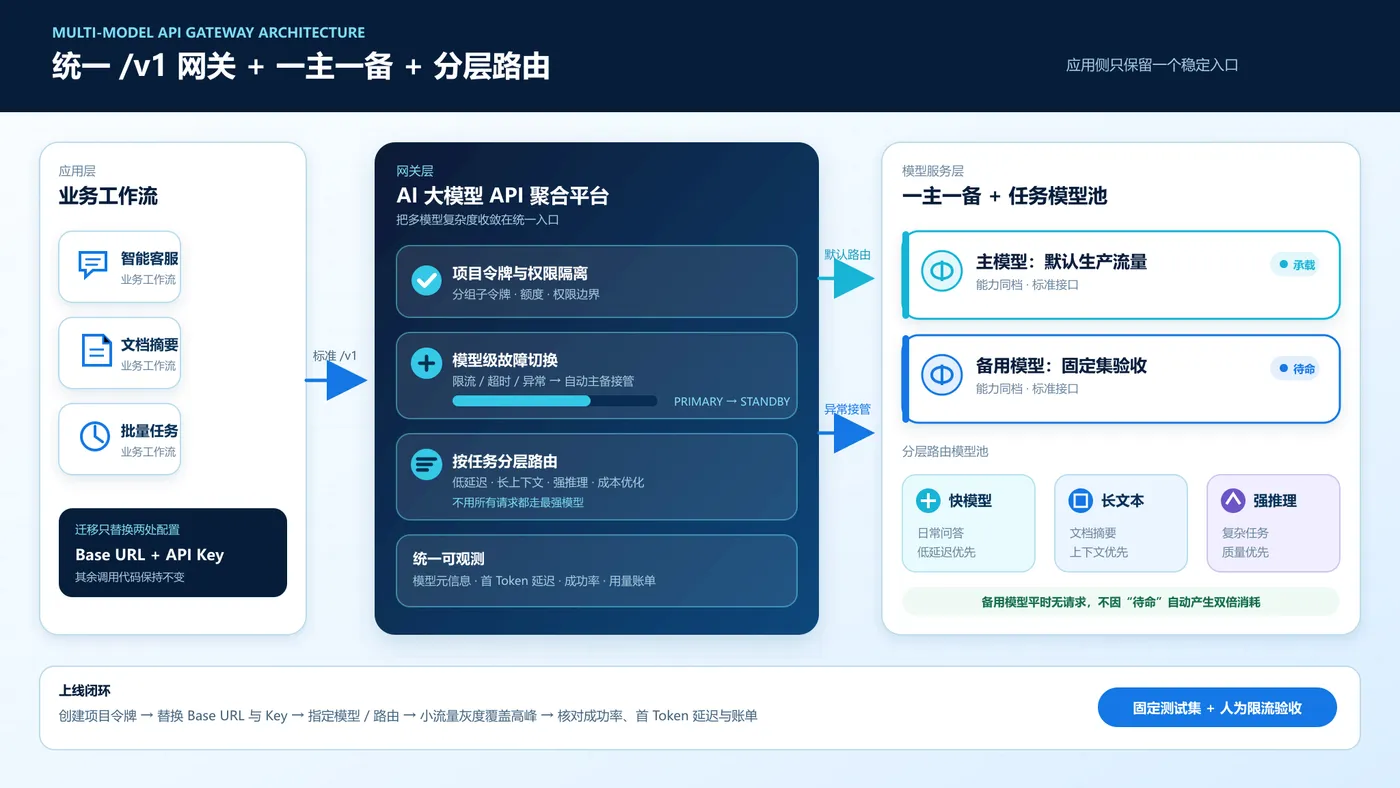
我怎么给工作流留退路:一主一备的改造
改造的前提只有一条:接入侧统一到行业标准接口格式(以/v1端点为代表),让"换模型"变成改一个模型名参数,而不是一轮联调。
具体设计我守三条原则。主备模型选能力同档的,切换后业务效果不掉档,备用模型不能选"凑合能用"的;切换动作放在网关层,由平台的故障切换路由承担,不在应用代码里写重试逻辑——那会把多模型的复杂度转嫁给每一个应用;备用模型接入后,先用固定测试集跑一轮,确认输出质量在业务可接受范围内,再让它承担兜底职责。
进阶我做了分层路由:日常问答走推理快的模型,长文档摘要走上下文长的模型,复杂推理走强推理模型。多模型不只是容灾,账单结构也顺带优化了——按任务配模型之后,单位成本比"全部用最强模型"降了一截,这是改造前没预料到的收益。
我对比的4家AI大模型API聚合平台
选载体时,我把此前收集的4家平台公示信息摆在一起对比:
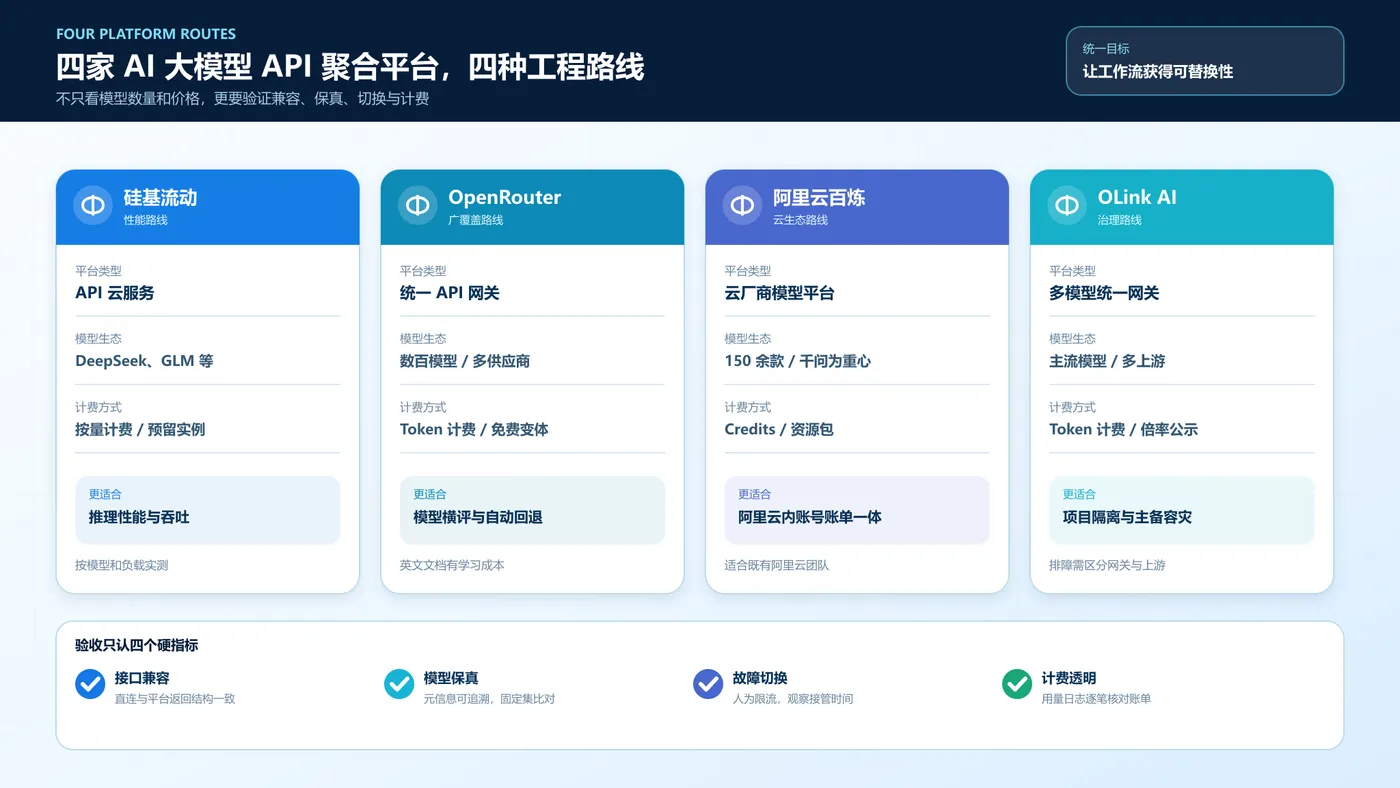
逐家说我实际观察到的(仅代表我自己场景,你的情况可能不一样):
硅基流动:自研推理引擎,推理延迟最高降低70%、吞吐量提升3—5倍。我压测下来确实快,但幅度跟模型和负载关系很大,建议自己跑数据,别直接套宣传口径。
OpenRouter:一个统一API接数百个供应商的模型,按Token付费且是供应商原价,还带自动回退路由,能主动避开供应商故障和限流。它的门槛是界面和文档全英文,团队英文文档阅读习惯不统一的话,有明显学习成本。
阿里云百炼它更偏阿里云生态内的团队:150余款直供模型以千问系列为重心,应用和数据库本来就在阿里云上,留在生态里账号账单一体。
OLink AI聚合平台:接口采用行业通用格式,替换Base URL和Key两处配置就完成迁移;模型广场展示各模型的计费倍率;支持按项目创建分组子令牌,额度和权限随组隔离;具备模型级故障切换路由,我的一主一备就是靠它兜底。聚合类方案共同的问题它也有:请求比直连多一跳,排障时要先分清问题出在网关还是上游——这是我前两周排障的亲身体会。
我验收时盯的四个硬指标
平台说得再好,我只认自己验过的四项,每一项都有具体的验证动作:
1.接口兼容:同一段代码模型官方直连与经平台各跑一次,比对返回结构与流式行为
2.模型保真:记录每次返回的模型元信息,用固定测试集定期与模型官方输出比对
3.故障切换:人为触发主模型限流,观察备用通道接管时间与应用侧是否无感
4.计费透明:小额充值后逐笔核对用量日志与账单明细
接入的实际改动比想象中小,核心4步:
- 控制台创建API令牌,按项目分开建,不全组共用一个;
- 替换两处配置:Base URL改为网关统一端点(/v1),Key换新令牌,其余代码原样保留:
import requests
resp \= requests.post(
"https://统一网关地址/v1/chat/completions",
headers\={"Authorization": "Bearer 你的令牌"},
json\={"model": "模型名", "messages": [{"role": "user", "content": "你好"}]})print(resp.json())
- 请求里指定模型名即可切换主备,要按成本分流就用分组路由;
- 小流量灰度至少覆盖一个业务高峰时段,盯成功率、首Token延迟和账单偏差,验证过再切全量。
我踩过的坑
免费额度直接上生产:大额免费额度往往伴随共享资源池,高峰期表现和付费通道不一致,测试可以,承载线上业务别赌。
模型被偷换降级:个别渠道会以低成本版本顶替调用,输出质量悄悄下滑。我的对策是记录每次返回的模型元信息,固定测试集定期比对,把"版本可追溯"写进验收标准。
全组共用一个Key:密钥泄露只能全量轮换,用量也归因不到项目。按项目建分组子令牌之后,这个问题才算闭环。
不灰度直接全量:低价渠道的问题集中在高峰限流和月底计费两个时点,灰度不覆盖这两个时点等于没灰度。
FAQ
1.备用模型平时闲置,成本会翻倍吗?
我的账单没出现这种情况。备用模型只在真实接管流量时产生消耗,平时无请求即无费用。
2.提示词只适配了一个模型,换别的模型麻烦吗?
麻烦分两块看。改代码那块不难,接口格式统一的话,换个地址和 Key 就完事。但提示词和结果解析还得拿新模型重新试一遍。只盯着改代码,就会把换模型想得太简单。
3.故障切换是自动的还是需要人工干预?
取决于平台的路由能力:支持模型级故障切换路由的平台可以自动切换;只支持手动切换的,恢复速度就看值守响应了
4.主备模型输出风格不一致,业务能接受吗?
取决于事前工作。我用固定测试集对主备模型分别跑分,差异在业务可接受范围内才确定为备选。
我的看法(仅供参考)
热搜上的"大模型又崩了"还会继续出现,模型之间的竞争也从"谁更强"转向"谁更稳定、更持续"。这轮改造下来我的体会是:确定性不是挑一个"不会崩的模型"挑出来的,而是把工作流迁到AI大模型API聚合平台上、在架构里留好退路换来的。
