
“智能填报”的第一版,很多团队都是这么写的:把材料丢给模型,让它输出一段 JSON,再把 JSON 往表单里填。演示能跑通,接进真实业务就开始不对劲。
具体一点。一个项目申报页面,4 份材料、9 个字段:项目申请书(Word)、营业执照(PDF)、项目合同(Word)、项目预算(Excel)。材料里同时有 325 万元的计划总投资和 180 万元的单份合同金额。模型把两个数字都读出来了,出处也都找得到。但“项目总投资”这一格该填哪个?
读出来是提取,填对才是填报。 中间隔着的,正是智能填报真正难的部分:按什么口径取值、材料打架时怎么呈现、填完之后业务人员凭什么核对。落到实处,是三个词——规则取值、冲突识别、来源追溯。
下面用 PageOffice Agent 试用包里的多材料填报 Demo,把这件事拆成 6 块工程。按官方介绍,它是给软件开发商和政企自研团队用的 AI 智能体中间件:一个 JAR 引进现有 Java、Spring Boot 项目,前端照旧用 Vue 调它的浏览器接口,服务端不用装 Python,也不用为它另维护一套 Python 服务,跟项目一起打包发布。模型服务要单独配;业务系统、Agent 和客户自己的模型都部署在物理隔绝内网时,业务数据可以全程留在内网。我这次只用了纯业务智能,没开 Word 实时那一套——材料里有 Word,不等于要打开 Word 实时工作区。(Word 实时是另一项能力,要另配对应客户端平台的 PageOffice 文档中间件企业版 V7,和 Agent 分开授权。)
它要解决的,就是开头那三个问题:按业务规则取值、识别材料之间的冲突、给出业务人员能核对的来源。下面逐项拆——材料读取、字段定义、状态判定、来源证据这几块,SDK 里已经有现成的类和明确状态;团队要补的,是把它们接到这张表、这套权限和这条流程上。
一、智能填报的第一步:材料不是一份文本,是三种格式
填报的第一件事不是调用模型,而是把材料变成模型能读、业务人员能核对的东西。四份材料,三种读取方式:
- Word:
WordSourceAdapter读取 DOCX 的正文段落与表格单元格,产出规范文本(把文档内容整理成统一文本)和粗粒度位置(到段落、表格单元格这一级)。它是提取接口,不是 Word 渲染,也不负责转换旧.doc。 - PDF:
PdfSourceAdapter读取 PDF 的文字层,保留页码。扫描后做过 OCR、带可提取文字层的 PDF 也能读;纯图片 PDF 要另做 OCR。拿客户的真实样本试读一遍最稳。 - Excel:
ExcelSourceAdapter读取.xlsx,由调用方指定工作表和 A1 范围。可以读一片区域,也可以只取一个单元格。这张申报表只需要预算总额,Demo 就读项目预算.xlsx的预算表!B6,里面写的是“325万元”。同时保留这个位置,填报后还能回到原表核对。
在 Demo 的 EntryActions.java 里,四份材料这样放进同一个快照。前三份加入文本来源,预算表加入结构化来源。ProjectBudgetMaterial 是 Demo 自己的辅助类,负责用 ExcelSourceAdapter 读取预算模板,并把金额整理成项目的业务字段。
AdaptedTextSource applicationSource = new WordSourceAdapter().adapt(
    materialRoot.resolve("项目申请书.docx"), "application", "项目申请书");
AdaptedPdfTextSource licenseSource = new PdfSourceAdapter().adapt(
    materialRoot.resolve("营业执照.pdf"), "license", "营业执照");
AdaptedTextSource contractSource = new WordSourceAdapter().adapt(
    materialRoot.resolve("项目合同.docx"), "contract", "项目合同");
ProjectBudgetMaterial budget = ProjectBudgetMaterial.read(materialRoot);

DataSnapshot snapshot = new DataSnapshot("project_application", APPLICATION_ID);
snapshot.addTextSource(applicationSource.getSource());
snapshot.addTextSource(licenseSource.getSource());
snapshot.addTextSource(contractSource.getSource());
snapshot.addJsonSource(budget.toSource());
二、字段得先定义清楚,模型才有地方填
模型不会凭空知道“项目总投资”该落在业务系统的哪个位置。要填什么,得先定义。
Demo 定义了九个字段。下面选申报单位、企业类型和项目总投资三个,把 Demo 的 field(...) 辅助方法展开,方便看清传给 SDK 的字段 ID、路径和类型。其余六项是统一社会信用代码、项目名称、项目开始日期、项目结束日期、项目建设地点和联系电话。
FormDefinition form = new FormDefinition("project_application", "1.0");
form.setName("项目申报表");

FieldDefinition applicantName = new FieldDefinition(
        "applicantName", "/applicantName", "申报单位", FieldType.STRING, false);
applicantName.setDescription("提交项目申请的单位正式登记全称");
form.addField(applicantName);

FieldDefinition enterpriseType = new FieldDefinition(
        "enterpriseType", "/enterpriseType", "企业类型", FieldType.ENUM, false);
enterpriseType.setDescription("按 enterprise_type 封闭字典进行语义分类");
enterpriseType.setDictionaryId("enterprise_type");
form.addField(enterpriseType);

FieldDefinition projectAmount = new FieldDefinition(
        "projectAmount", "/projectAmount", "项目总投资", FieldType.NUMBER, false);
projectAmount.setDescription("整个申报项目计划投入的全部资金");
projectAmount.setUnit("元");
form.addField(projectAmount);
企业类型用的是项目自己的封闭字典。Demo 配置了国有企业(1)、民营企业(2)、外商投资企业(3)和其他企业(9)。下面展开其中一项。
DictionaryDefinition enterpriseTypes = new DictionaryDefinition("enterprise_type", "1.0");
DictionaryItem item = new DictionaryItem("private", "民营企业", 2);
item.setAliases(Collections.singletonList("私营企业"));
item.setDescription("以民间资本为主要出资主体的企业类型");
enterpriseTypes.addItem(item);
这里有三个容易被页面上的一行字掩盖的值:材料原文是“民营控股企业”,字典项 ID 是 private,系统接收的规范值是数字 2。第三个构造参数如果写成 "2",业务系统收到的就是字符串。
接这张表时,还有几条 SDK 约束值得一起看。
| 约束 | 后果 |
|---|---|
字段路径是非根 JSON Pointer;同一表单内字段 ID 与路径不能重复,路径也不能互为祖先和后代(/contract 与 /contract/amount 不能并存) |
想用嵌套结构表达“合同 → 金额”,路径要先设计好 |
setUnit() 只对 NUMBER 字段有效 |
给文本字段设单位通不过校验 |
ENUM 字段必须在 addField() 之前设置 dictionaryId |
缺少字典 ID 时,addField() 当场抛出 IllegalStateException,字段不会加入表单 |
字典项的 value 是写进候选数据的规范值,不一定等于显示名或项 ID;setAliases() 收业务简称、旧称 |
只告诉模型“企业类型”四个字,它不知道客户系统里的 2 是什么 |
最后一条是智能填报里最常被低估的:封闭字典不能虚构映射。示例结果里“企业类型”落成“民营企业”、系统编码 2,这个 2 只能来自项目里配置的真实字典,不能由模型自己编一个。
三、读得出,不等于填得对
这是“智能”两个字真正的位置,也是最不像编程题的部分。
- 名称怎么取:申请书里写的是简称“星河智能”,营业执照的登记名称是“北京星河智能科技有限公司”。目标字段是“申报单位”,本示例的规则是取营业执照登记名称,所以候选值是登记名称,依据同时给到“营业执照.pdf,第 1 页”。
- 金额怎么取:计划总投资 325 万元、单份合同 180 万元,两个数字不一定矛盾——一份合同可能只覆盖项目的一部分。目标字段是“项目总投资”,业务规则筛选整个项目的计划投资,字段的目标单位是元,候选是 3,250,000 元。不能见到金额就填,也不能取最大值或求和。
- 材料对不上怎么办:建设地点,申请书第 7 段写“北京市海淀区中关村软件园”,合同第 4 段写“北京市朝阳区科技园”;项目结束时间只写到“2026年12月”;四份材料里没有联系电话。
两条取值口径由业务方提供。Demo 给正式名称和项目总投资分别配置了 R001、R002,用 scope 指明规则适用的字段。下面这段假定九个字段、完整字典和四份材料都已就绪,只展示规则和提交动作。
List<BusinessRule> rules = Arrays.asList(
    BusinessRule.semantic("R001", "申报单位正式名称来源规则",
                "申报单位名称以营业执照中的企业正式登记名称为准;其他材料中的项目简称、机构简称或非正式称呼不得作为 applicantName 候选值。")
            .version("1.0").source("项目申报规则").scope("applicantName")
            .severity(RuleSeverity.HIGH).kind(RuleKind.SEMANTIC),
    BusinessRule.semantic("R002", "项目总投资候选资格规则",
                "项目总投资指整个申报项目计划投入的全部资金。单份采购合同、施工合同、服务合同等合同金额不得作为项目总投资候选值。")
            .version("1.0").source("项目申报规则").scope("projectAmount")
            .severity(RuleSeverity.HIGH).kind(RuleKind.SEMANTIC));

AgentAction action = AgentActions.structuredDataEntry(form,
    Collections.singletonList(enterpriseTypes), snapshot, rules);
这两条规则管名称和金额。地点有两个不同候选、日期只到月份、电话缺少依据,则由对应字段的判定结果呈现。
四、冲突、缺失、不完整,不能都变成一个空值
如果页面把冲突、缺失、不完整都渲染成空值,业务人员会以为“材料里没有”,而实际是“两份材料写得不一样,需要他判断”。所以字段判定分成四种状态:
| Java 字段状态 | 含义 | 页面该怎么呈现 |
|---|---|---|
RESOLVED |
已得到规范值 | 展示候选,允许填入 |
CONFLICT |
多个候选互相冲突 | 并列展示候选及各自来源,等人选 |
MISSING |
本次材料中未得到可用候选 | 标“未找到”,保留原表单已有值 |
INVALID |
有值但不满足字段约束 | 标出问题,例如日期只到月份、构不成 DATE |
这里有两个容易混的地方。 第一,任务可以是 SUCCEEDED,同时仍有字段是 CONFLICT。第二,INVALID 表示候选不满足字段约束。本例的结束日期只写到月份,所以页面标为“信息不完整”。
Java 枚举是大写,浏览器收到的 assignment.status 是小写字符串。Demo 的 fill.js 直接按状态统计,页面上四个计数就是这样来的。
function summarize(assignments) {

    var counts = {
    resolved: 0, conflict: 0, invalid: 0, missing: 0 };
    for (var i = 0; i < assignments.length; i++) {

        if (Object.prototype.hasOwnProperty.call(counts, assignments[i].status)) {

            counts[assignments[i].status] += 1;
        }
    }
    return counts;
}
不要把第一个候选直接当成已确认值。 页面按 fieldId 找到字段。已识别的字段展示 canonicalValue,有冲突的字段则保留全部 candidates 和各自的依据,等业务人员核对。
如果在 Java 后端消费结果,可在填报任务达到 AgentTaskStatus.SUCCEEDED 后调用 StructuredDataEntryResult.parse(delivery.getResultJson())。这个解析器只接受已完成的结构化填报结果。
五、结果要能回到原材料核对
来源追溯不能停在“来自营业执照”这一句。
每个候选的证据里都有 sourceId。点开“查看依据”,页面先找到对应材料,再根据证据类型显示位置。
- Word 和 PDF 看原文引用。 浏览器从
quote类型证据取evidence.quote。Demo 在材料的规范文本中找到引用,再对照位置区间显示 Word 段落、表格单元格或 PDF 页码。因此,同一个“建设地点”字段的两个候选,可以分别标成“项目申请书.docx,第 7 段”和“项目合同.docx,第 4 段”。 - 预算表看字段路径。 来自预算表的
field类型证据,材料 ID 是budget,字段路径是/project/totalAmount。这是 Demo 提交的业务字段。适配器按原单元格路径/cells/B6提供位置,Demo 把业务字段映射到这个位置。核对金额时,业务人员就知道该看哪张表、哪一格。
把 Demo 的文件名、工作表名和范围常量展开,读取和定位用的是下面几行。
AdaptedExcelSource workbook = new ExcelSourceAdapter().adapt(
        materialRoot.resolve("项目预算.xlsx"), "budget", "项目预算", "预算表", "B6");
ExcelCellLocation location = workbook.getLocationMap().locate("/cells/B6");
if (location == null) {

    throw new SourceAdapterException("excel_cell_missing", "样例预算表缺少项目总投资单元格。");
}
Object value = workbook.getCells().get("B6");
这个模板的 B6 存的是带单位的文本。Demo 检查它是非空字符串,再写入 /project/totalAmount。位置则取自 location.getSheetName() 和 location.getCellReference(),页面最终显示 预算表!B6。
重复引用值得单独测。Demo 页面用 indexOf(quote) 找到第一次出现的位置。如果客户材料里同一句话反复出现,第一次命中可能落在另一段。Java 的 Word、PDF 适配结果提供 locateQuote(quote),可以返回多个匹配位置,找不到时返回空列表。项目页面可以据此列出多处位置,供业务人员选择。
要把依据留到以后复核,应保存本次任务所用的材料版本及其位置映射。材料更新后,历史结果仍应指向当时的原件。
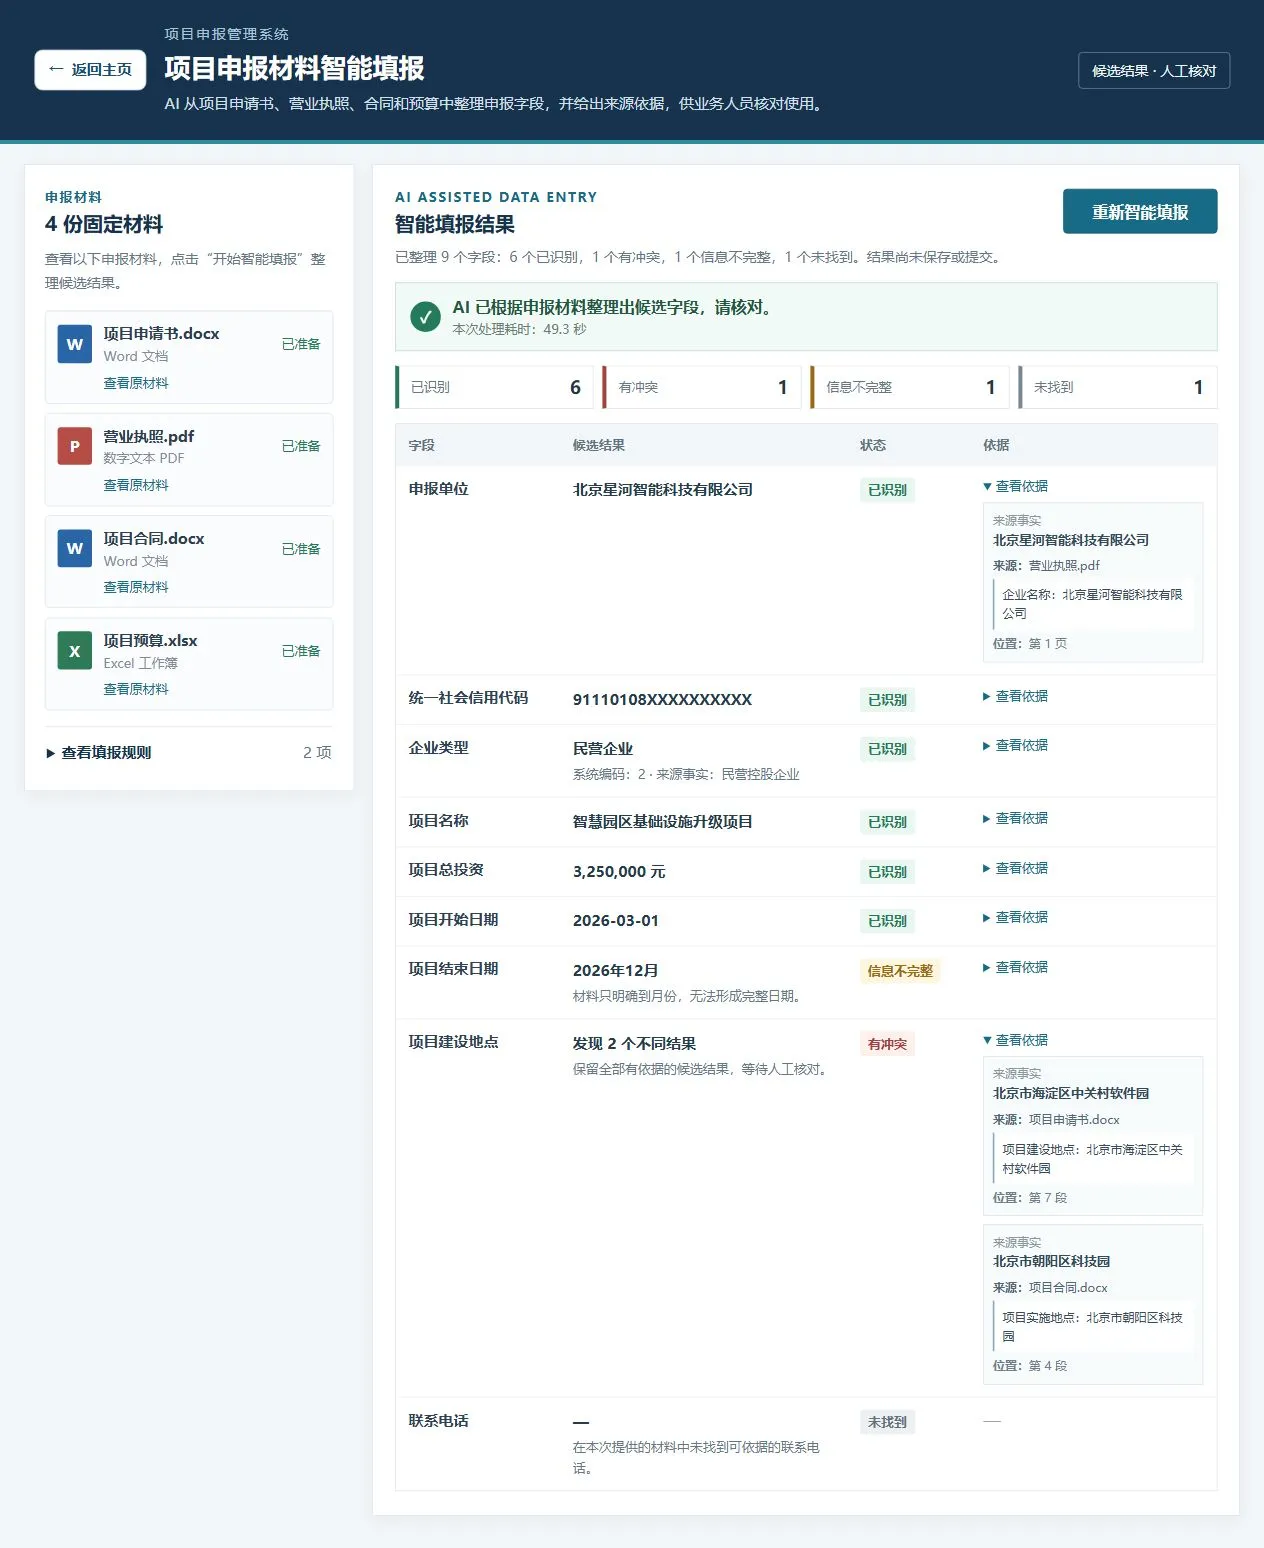
图:示例 Demo 的一次运行结果。9 个字段中 6 个已识别、1 个有冲突、1 个信息不完整、1 个未找到;“查看依据”展开后给出材料名、原始值和位置。截图里的耗时只是这一次,不能当基准。
截图里“项目建设地点”的两个候选各自带材料名与段落位置,这才是业务人员能拿去核对的东西。来源依据说明的是“这个值是从哪里读出来的”,业务人员据此判断即可。
六、最后还有一层:任务、结果与保存
到这一步,系统已经整理出待核对的候选,接下来要处理任务交付和业务保存。
- 提交是异步的。 业务提交接口返回 HTTP 202 和
task.toJson(),且必须原样返回,不能再把 JSON 当字符串序列化一次,否则前端收到的是带引号的 JSON 字符串。 - 同一份结果里,两个字段用途不同。
assignments是逐字段的状态、候选与证据;candidateData只包含已确定字段的候选 Patch。页面只渲染candidateData,冲突和缺项就会静默消失——这是接入智能填报时最容易犯的错。 - 结果有保留期。 任务结果不会永久留在 SDK 里,服务重启后内存中的任务也不保留。要长期留痕,得写进客户自己的库,并按客户规则管理。
- 留意数字类型。 Java 类型化结果里的 JSON 数值按
BigDecimal读取,直接强转Integer会抛异常。浏览器拿到的是 JavaScript 的number。 - 并发有上限。 排队与并发都有阈值,不是“接上就能扛”;要按项目负载验收,而不是按 demo 效果验收。
- 不自动写库。 SDK 返回候选数据不会写入业务数据库;人工确认后仍由原系统接口保存,权限、流程、留痕都留在原系统,审计留痕按任务与处理记录留存。
试用包的 Spring 提交接口在 ShowcaseController.java。页面传申报编号,由后端选择材料和动作。Demo 校验的是固定样例编号,接入真实系统时,这里要按当前用户校验项目和材料的访问权限。
@PostMapping(value="/StructuredDataEntry/Submit.jsp", produces=MediaType.APPLICATION_JSON_VALUE)
public ResponseEntity<String> entry(@RequestParam String applicationId) throws Exception {

    AgentTaskService service = service();
    if (!EntryActions.APPLICATION_ID.equals(applicationId))
        throw new SubmissionFailure(400, "entry_submission_failed", "请检查申报材料和填报动作后重试。");
    return accepted(service.submit(new EntryActions().entryAction(materials.entryRoot())));
}
accepted(...) 是 Demo 控制器自己的方法。它用 HTTP 202、application/json 和 Cache-Control: no-store 返回 task.toJson()。
前端从 StructuredDataEntry/Fill.jsp 发起调用,同目录的 Submit.jsp 就是上面的 Spring 接口。下面节选自页面的异步处理函数,省略了计时和按钮更新。
try {

    const value = await PageOfficeAgent.runTask({

        submitUrl: "Submit.jsp",
        fields: {
    applicationId: "PROJECT-2026-001" },
        progress: function (event) {
    handleProgress(toObject(event)); }
    });
    renderTaskResult(toObject(value), bootstrap);
} catch (error) {

    showError(window.TrialErrors.message(error, "多材料智能填报未完成。"));
}
runTask() 成功后直接返回业务结果,可读取 value.assignments 和 value.candidateData。renderTaskResult、handleProgress、TrialErrors、showError 都是 Demo 的页面辅助函数;bootstrap 包含本次材料名和位置映射。渲染时按 assignments 展开九个字段,candidateData 留给后续核对和回填。
七、这 6 块工程,分别对应 SDK 里的什么
把前面六节压成一张表,就能看出 SDK 承担了哪一层、团队还需要补哪一层:
| 难点 | SDK 里已有的 | 接进来之后仍由团队负责 |
|---|---|---|
| 四份材料组成快照 | WordSourceAdapter、PdfSourceAdapter、ExcelSourceAdapter、DataSnapshot |
材料范围与权限、客户预算模板映射 |
| 字段与字典定义 | FormDefinition、FieldDefinition、DictionaryDefinition |
字段的业务含义、字典里真实的业务代码 |
| 取值口径 | BusinessRule.semantic(...)、字段 setDescription(...) |
规则内容本身(业务方提供) |
| 冲突、缺失、不完整 | RESOLVED / MISSING / CONFLICT / INVALID 与 candidates |
页面怎么呈现、谁来裁决 |
| 来源证据 | Evidence(QUOTE / FIELD)、位置映射与 locateQuote |
材料版本、业务路径与原单元格的对应关系、页面展示 |
| 任务与保存 | 202 + task.toJson()、runTask、任务状态和结果保留期 |
鉴权、确认后的保存、审计留痕 |
六块里没有一块需要从零发明:要么 SDK 已经给出了类和明确状态,要么剩下的是业务方本来就该提供的规则与字典。团队真正要补的,是把它们接到这张表、这套权限和这条流程上。
八、AI 转型不必先造一层底座
挡住 AI 项目的,往往不是“不知道做什么”,而是缺一层底座:模型怎么接、结果怎么落回业务字段、证据和状态怎么给、异常和保存链路怎么兜。这层东西不直接产生业务价值,但没有它,AI 就进不了项目。
对以 Java 为主的软件公司,这件事更具体:团队里没有算法工程师,单独为一项能力配一支算法团队,成本和不确定性都不低;而项目周期不会等你把平台搭完。转型如果从“先造底座”开始,很多机会就在平台还没搭好时过去了。
这套东西的做法是把这层封进一个 JAR:后端引进来,前端调浏览器接口,团队写的还是表单定义、字典和业务规则——他们最熟、甲方也最认的部分。同样的转型目标,路可以短一截。
落到项目上,变化是三件:
- 能接 AI 项目。 招标文件里出现“智能审核”“智能填报”“合同风险排查”,团队有可交付的实现方式,不必因为“没有 AI 团队”就把项目让出去。
- 老项目能改造。 现有 Spring Boot + Vue 系统不用重构,加一个 JAR 和一个前端脚本,原有权限、流程、保存链路都保留。
- 人力花在甲方身上。 需求调研、规则落到字段、口径与字典对齐,这些是软件公司的积累,也是报价的底气;底座用现成的。
转型的时间应该花在项目上,而不是花在造底座上。越早把 AI 接进一个真实项目,越早能用这个项目去谈下一个。
补充一句:“一个 JAR”说的是集成方式,模型服务仍要单独配置(地址、模型名、密钥在服务端)。效果用项目自己的样本验收。
九、试用时,重点验收这五件事
- 口径:四份材料一起给,简称与登记名称并存、整体投资与单份合同金额并存时,候选是不是按规则来的——不是第一个出现的,也不是最大值。
- 状态:冲突、未找到、信息不完整能不能分成三种呈现,而不是三个空值。
- 证据:每个候选能不能回到“材料名 + 原始值 + 位置”;同一句话出现两次时,页面有没有处理多处命中;预算金额能不能回到具体工作表和单元格。
- 前端:只渲染
candidateData时,页面是不是漏掉了冲突字段。这是最快暴露问题的一步。 - 保存:确认之后,是不是仍走原系统的保存接口和权限,有没有把候选值直接覆写进正式字段。
这五个问题答完,基本能判断一套智能填报是“能演示”还是“能交付”。
适合试的情况很具体:团队是 Java 栈,手上已经有甲方在问 AI 功能,又不想为此单立一个算法团队。这类团队跑一遍 Demo,基本就知道值不值得接。
试用包里有能直接跑的多材料填报 Demo、Java SDK 和接入资料:按说明配好运行环境、授权和模型接口,在 Windows 上双击 start-demo.bat 就能起来看效果;还附了一套给 AI 编程助手用的提示词和参考资料,接入时能少翻点文档。
