
一台 32 核的机器,只跑了 4 核的活。这不是浪费,这是那个年代的正常水位。
2013 年,一个 Java 服务上线要经过这样一串动作:提资源申请单,等两周到两个月拿到一台物理机,装机、装 JDK、改 /etc/security/limits.conf、把 jar 传到 /opt/app、写一个 init 脚本、配 crontab 做保活,再找网络组开防火墙。
这套流程跑了很多年,没人觉得有问题。直到业务方说:下个月大促,容量翻三倍。
Kubernetes 官方文档在讲自己的由来时,把这段历史切成三代:传统部署时代、虚拟化部署时代、容器部署时代。这不是一份编年史,它其实只讲了一件事——资源的边界划在哪里。
一、三个时代,一条主线
官方对这三代的描述很克制,几乎每句都在讲"边界":
- 传统部署时代:应用直接跑在物理服务器上,"没有办法为服务器上的应用定义资源边界"。多个应用挤在一台机器上,一个可能吃掉大部分资源,其他的就变慢。解法是让每个应用独占一台机器——但那样利用率很低,维护一堆物理机的成本又高。
- 虚拟化部署时代:一台物理机上跑多个虚拟机,每个 VM 有独立的操作系统,应用之间隔离,安全性提升,利用率也提升,扩缩容变容易。代价是每台 VM 都是一台"完整的机器"。
- 容器部署时代:与 VM 类似,但隔离是"松"的(relaxed isolation),共享宿主操作系统内核,因此轻量;有自己的文件系统、CPU 与内存份额、进程空间;与底层基础设施解耦,可以跨云、跨发行版移植。
主线很清楚:边界单位从"一台机器"缩到"一个虚拟机",再缩到"一组进程"。 单位越小,同一份硬件能切出的份数越多,闲置越少。
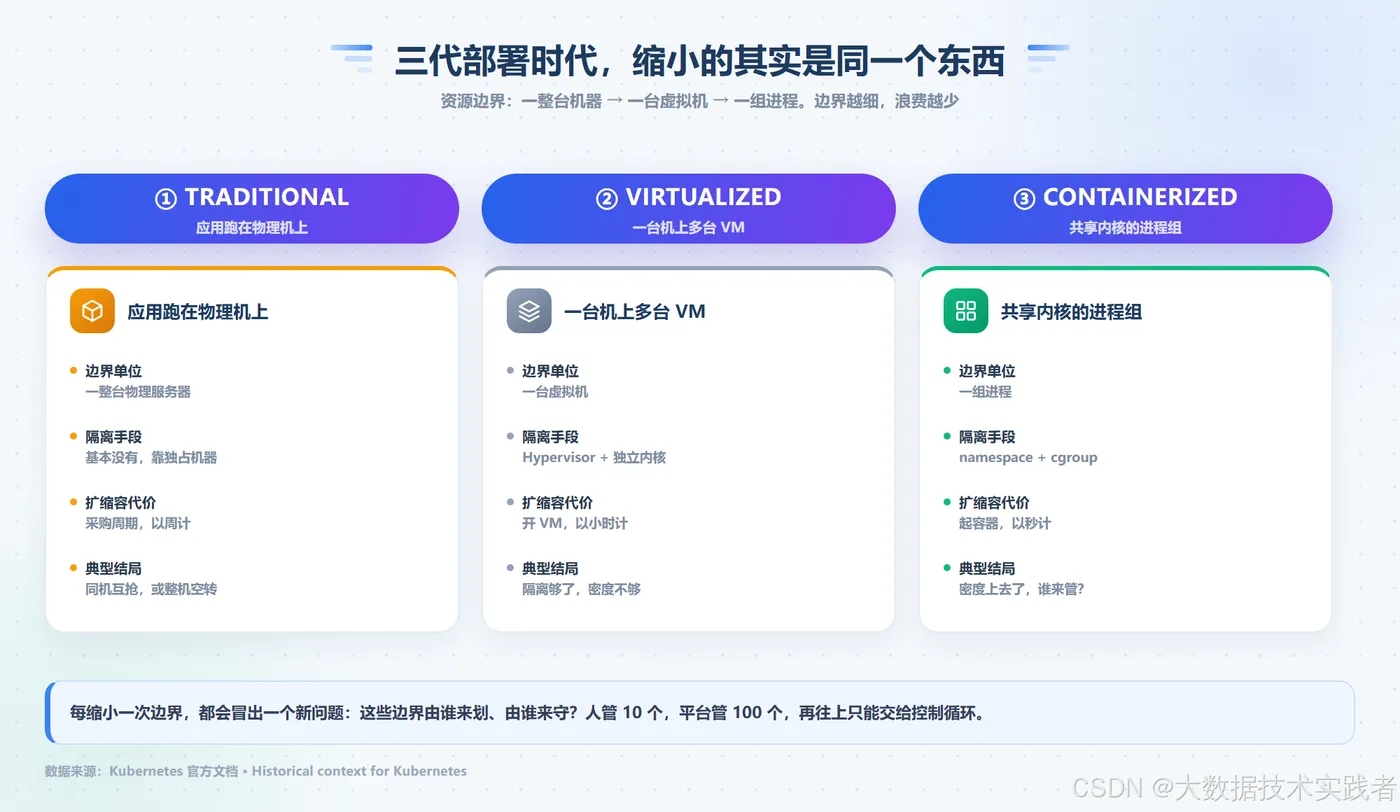
但每缩小一次,都会冒出一个新问题:这些边界由谁来划、由谁来守?
物理机时代是人——运维按机器分配。虚拟机时代是虚拟化平台,流程仍然是"申请、审批、创建"。到了容器时代,边界数量从十几个涨到几百上千,人已经管不过来了。
所以 Kubernetes 不是"容器多了才顺带出现的编排工具"。它是边界细化到人力无法管理时的必然产物。
二、痛点一:资源边界等于机器边界
物理机没有"给这个进程 4 核 8G"的能力。严格说,Linux 早在 2008 年就把 cgroup 合进了内核,但那个年代既没有配套的交付体系,也没人拿它做应用隔离。于是分配的粒度只能是一台机器。
两种结局,都不好。
共享一台机器,就会抢。 一个 JVM 的堆涨上去,page cache 被挤掉,机器开始 swap,同机其他进程的延迟跟着抖。更麻烦的是这种争抢不可归因:你知道机器慢,但很难说清是谁导致的。那个年代的排查方式是登录机器 top 看一眼,然后凭经验猜。
独占一台机器,就是浪费。 一个 4 核的服务跑在 32 核机器上,剩下 28 核空转,而且为了"以后可能扩容",机器规格还得往上选一档。
真实的分区结果通常长这样:一台 8 核 32G 的机器,中间件占 4 核 12G,业务 A 占 3 核 10G,剩下 1 核 10G 谁也用不上——因为它不满足任何一个应用的申请规格。
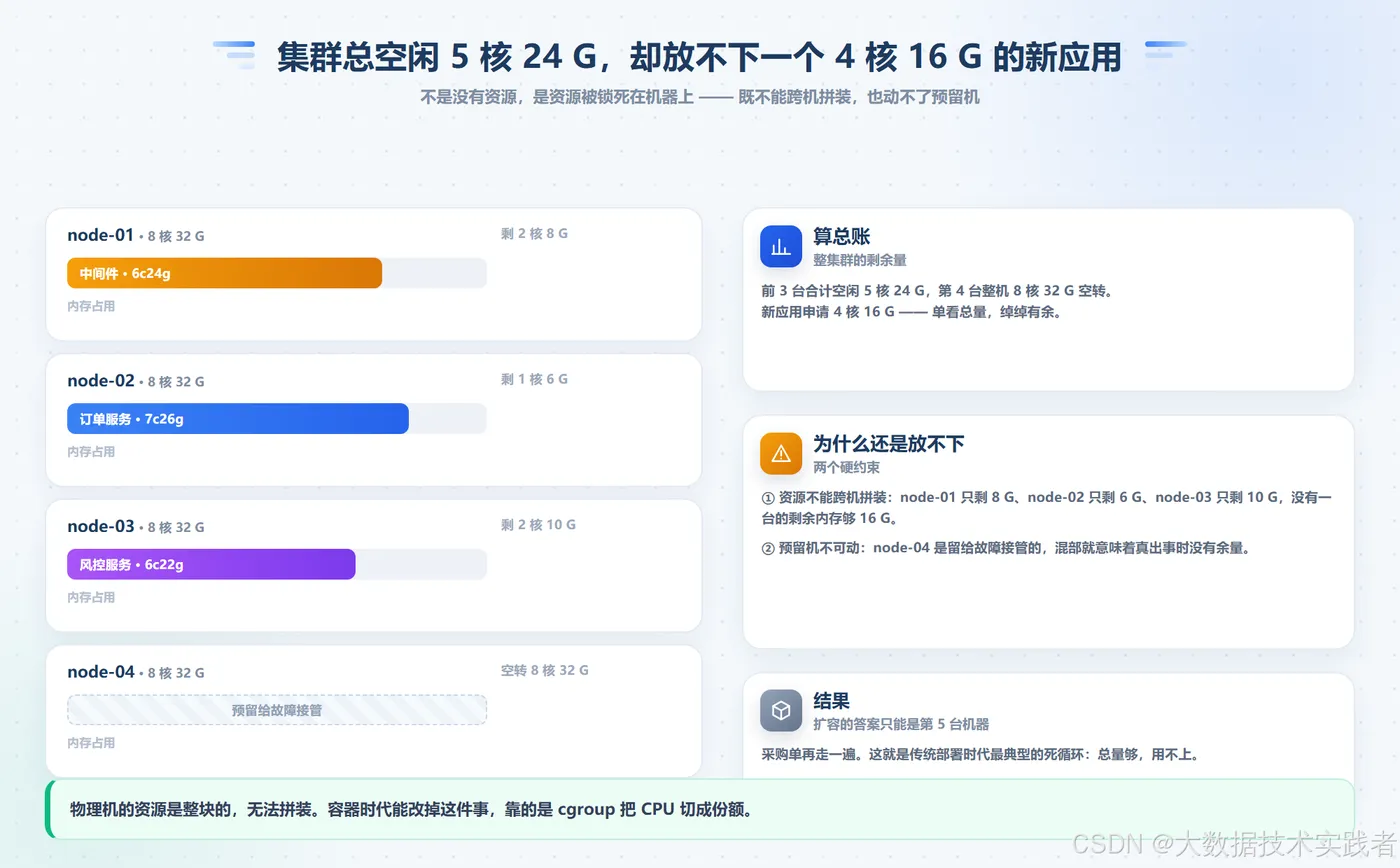
这就是碎片:不是没有资源,是没有"连续且够大"的资源。物理机的资源是整块的,无法拼装。容器时代之所以能改掉这件事,靠的是 cgroup 把 CPU 变成可细分的份额(cpu.weight / cpu.max),把内存变成可设上限的配额(memory.max)。
三、痛点二:分配单位等于采购单位
传统部署时代,扩容不是一个技术动作,是一个采购流程:立项、比价、下单、到货、上架、装机、配网、初始化。周期以周或月计。
这带来一个数学上的后果:容量必须按峰值预留。日均 QPS 2000、大促峰值 8000,意味着常态下四分之三的容量是闲置的——而这部分钱,是提前几个月付掉的。
反向操作更难受:缩容不省钱。机器已经买了,业务降下来只能让它空着。所以那个年代的成本曲线是阶梯式的,只能往上走,不能往回走。
容器编排把这一格彻底换了:扩容从"申请一台机器"变成"改一个数字",从周到秒。弹性这个词,在物理机时代是不成立的——不是不想弹,是采购流程不允许。
四、痛点三:部署单位等于机器
应用和机器绑在一起,意味着机器上的一切都成了应用的一部分:JDK 版本、glibc 版本、时区、limits.conf、某个手工装上的字体包、某次 yum update 留下的库。
于是就有了那句经典的话:"这台机器上能跑,那台跑不了。"
漂移通常有三种:
- 依赖漂移:测试环境 JDK 8u102,生产 8u202,某个反射行为变了。
- 配置漂移:A 机器
ulimit -n是 65535,B 机器是 1024,高并发下 B 报 "Too many open files"。 - 状态漂移:有人手工改过一个配置文件,没进版本库,重装就丢。
对策在当时叫"文档化 + 巡检脚本",本质是用人来保证一致性。这就是为什么那个年代的发布手册能有几十页。
发布本身也很原始:
# 那个年代的"发布系统"
for host in app01 app02 app03; do
  scp target/app-1.4.2.jar deploy@$host:/opt/app/
  ssh deploy@$host "sudo systemctl restart app"
done
问题不在于简陋,而在于没有事务性:第三台失败了,前两台已经在新版本上,集群半新半旧。回滚要靠人记住上一版是 1.4.1,再手动跑一遍。
而"上一版是什么"这件事,机器自己并不知道——因为版本这个概念,在物理机模型里根本不存在。
五、痛点四:运维单位等于人
进程挂了怎么办?systemd 能拉起来。
# 传统部署时代的标准写法
[Unit]
Description=order-service
After=network.target

[Service]
User=app
ExecStart=/usr/bin/java -Xms4g -Xmx4g -jar /opt/app/app.jar
Restart=on-failure
RestartSec=5
LimitNOFILE=65535

[Install]
WantedBy=multi-user.target
Restart=on-failure 只是"同一个进程再起一次"。它不知道四件事:
- 这个进程该不该在这台机器上(没有调度)
- 起来之后要不要接流量(没有健康检查与端点摘除)
- 新版本要不要先灰度一小部分(没有版本与副本的概念)
- 这台机器整个挂了,进程该去哪(没有"期望状态")
这四个不知道,正好对应 Kubernetes 的四根柱子:调度、探针、滚动更新、控制器。
恢复时间也能说明问题。OOM 或者端口冲突会让进程进入重启循环,而无人知晓;真正的发现路径是用户投诉、值班看监控、登录机器、ps 加 tail 日志、再判断。整条链路里,机器执行只占几秒,人工发现和人工判断占了大头。
把四个痛点放在一起看,会发现它们不是并列的,而是同一条因果链上的四段:
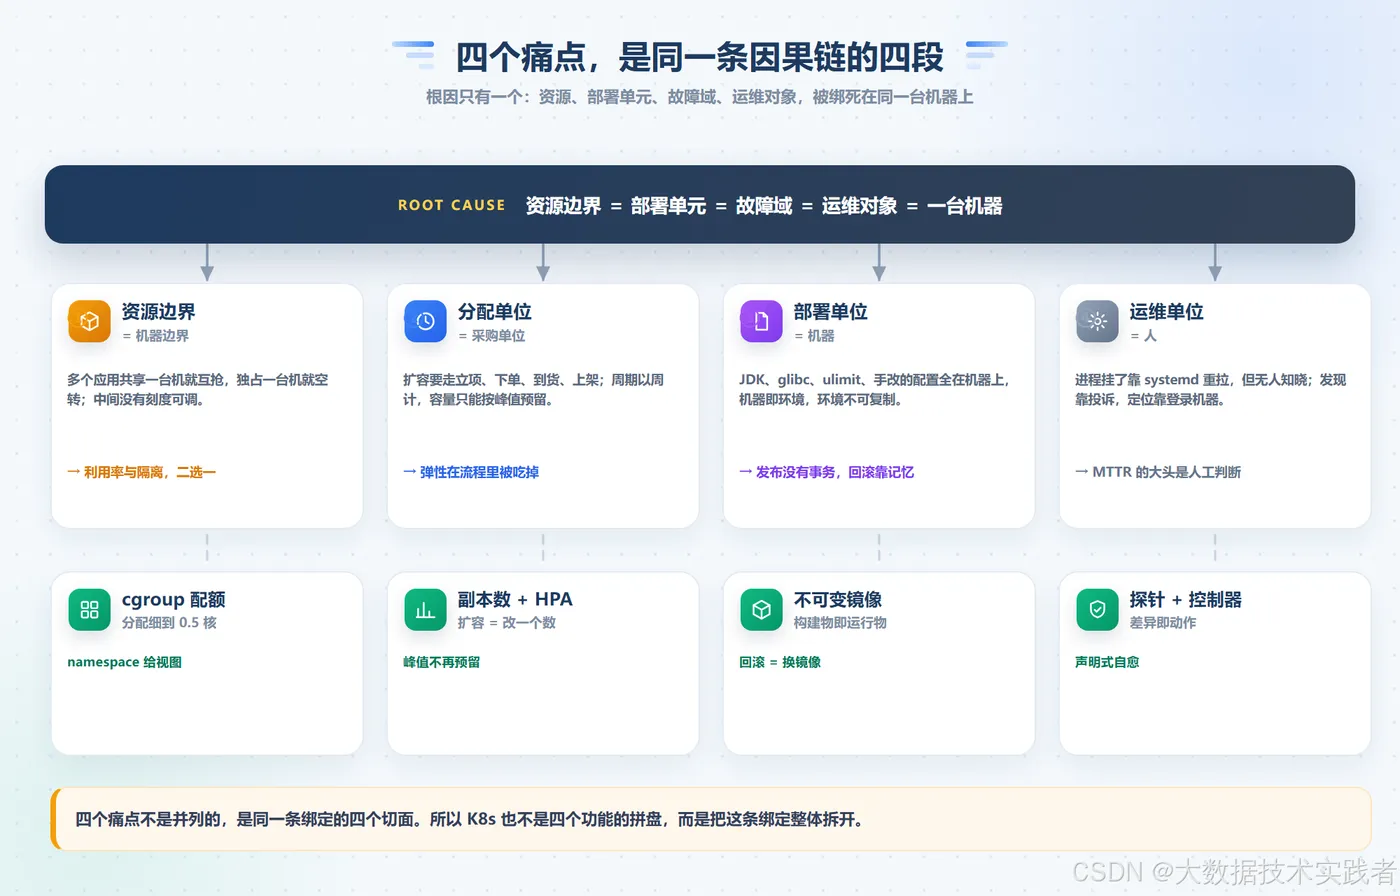
根因只有一个:资源、部署单元、故障域、运维对象,四者被强行绑定在同一台机器上。 后面三个痛点,都是这个绑定的派生结果。
六、虚拟化缓解了什么,留下了什么
虚拟化把边界从"机器"缩到"VM",收益是真实的:一台 32 核机器可以切成 8 个 4 核 VM;某个 VM 内核 panic 不影响邻居;扩容从"买机器"变成"开 VM",周期从周降到小时。
| 维度 | 物理机 | 虚拟机 | 容器 |
|---|---|---|---|
| 隔离单位 | 一台机器 | 一台 VM | 一组进程 |
| 隔离机制 | 基本没有 | Hypervisor + 独立内核 | namespace + cgroup(共享内核) |
| 启动时间 | 分钟级(装机) | 30 秒到数分钟 | 亚秒到数秒 |
| 交付物体积 | — | GB 级,含完整 OS | MB 级,只含依赖 |
| 固定开销 | 0 | 每 VM 一套 OS 的内存与磁盘 | 接近 0 |
| 单机密度 | 1 个应用 | 几个到十几个 | 几十到上百 |
关键在"每 VM 一套完整 OS"这一行:一个最小化的 Linux 也要几百 MB 内存和数 GB 磁盘,这部分开销是乘以 VM 数量的。密度上不去,利用率的天花板就还在。
虚拟化真正没解决的是最后两件事:谁决定这个 VM 落在哪台机器上,VM 挂了谁来重建。 在 vSphere、OpenStack 里,这仍然大量依赖人工或半自动的调度策略。而且平台只认识"有个 VM 在跑",不认识"里面那个 Java 服务健不健康"——应用语义是缺失的。
顺带说一个迁移期最常见的坑。传统部署时代,JVM 的堆按物理机内存估:机器 32G,-Xmx24g。搬到容器里,容器 limit 是 8G,JVM 仍然按宿主机的内存算堆,于是堆一路涨到 24G,然后被内核 OOMKilled——exit code 137,日志里什么都没有。
JDK 10 起(8u191 之后的 8 也回移了)默认开启 UseContainerSupport,按 cgroup 限额算堆。但在混合环境里,显式写死更安全:
# 不要再用 -Xmx 硬编码,按容器 limit 的百分比给
java -XX:MaxRAMPercentage=70 -XX:InitialRAMPercentage=70 -jar app.jar

# 验证 JVM 到底认了多少内存
java -XX:+PrintFlagsFinal -version | grep -E "MaxHeapSize|MaxRAM"
留 30% 不是保守,是留给元空间、线程栈、直接内存和 JVM 自身——这些都不在堆里,但都在 limit 里。这条经验后来被 Flink 直接写进了内存模型:taskmanager.memory.process.size 必须小于容器 limit,中间那部分叫 JVM overhead。
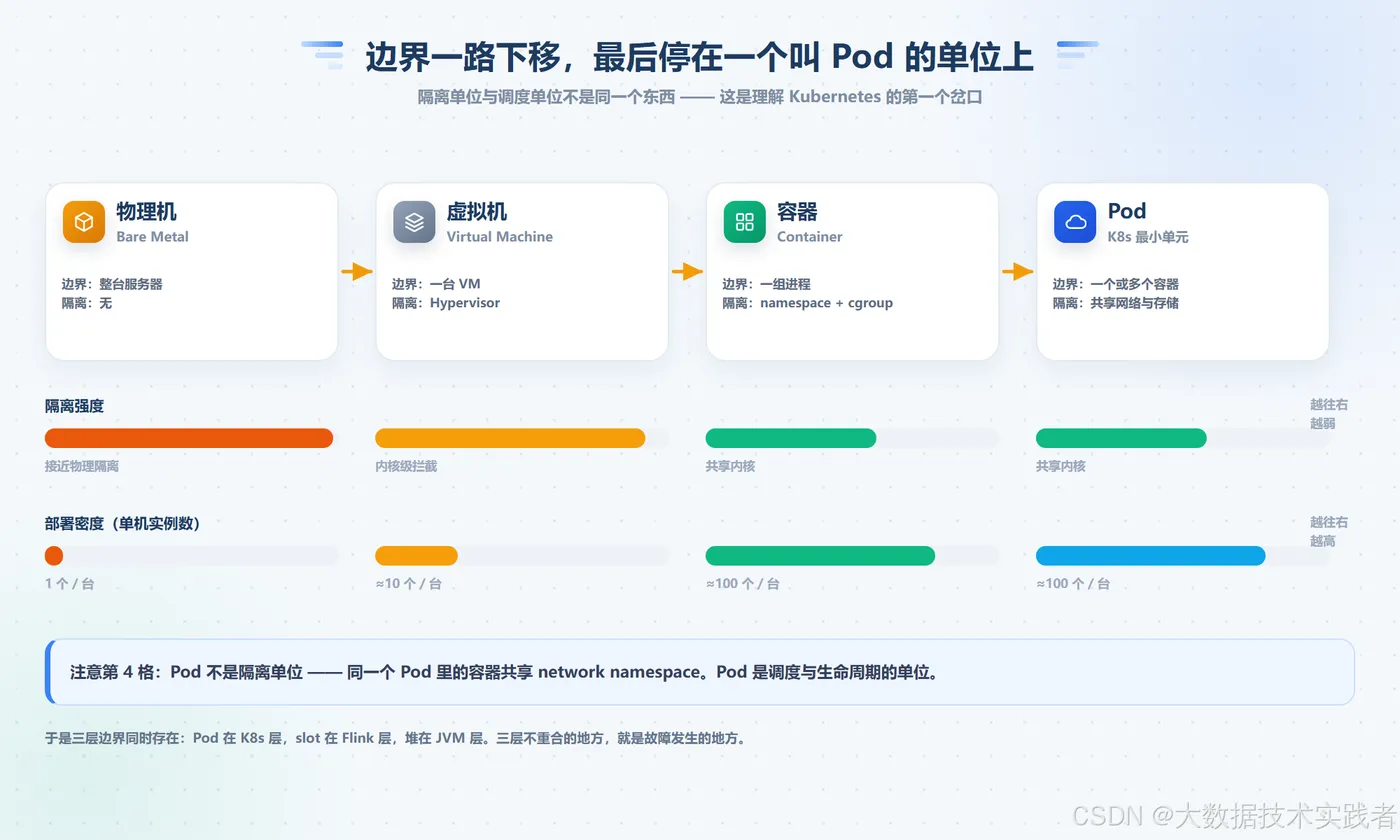
不过有一条规律值得单独说:边界越细,隔离强度越弱。
- 机器边界:物理隔离,强度最高,粒度最粗。
- VM 边界:Hypervisor 拦截特权指令,强度接近物理机,粒度中等,代价是每 VM 一套 OS。
- 容器边界:共享内核。namespace 只改变"能看见什么",cgroup 只限制"能用多少"——两者都不拦截系统调用。内核有漏洞,边界就能穿透。
所以"用容器替代虚拟机"从来不是一次全面升级,而是一次取舍:拿隔离强度换密度和弹性。这也解释了后来为什么会出现 gVisor、Kata Containers 这类"安全容器"——本质是把 VM 的隔离强度塞回容器的粒度和启动速度里,Kubernetes 则用 RuntimeClass 给这种混合留了口子。
顺带澄清一个常被混用的说法:namespace 负责隔离,cgroup 负责限制。 前者让进程看不到别的进程,后者让它用不满整台机器。Kubernetes 的 requests 大致对应调度时的 cgroup 权重,limits 对应硬上限——这也是为什么 limits 设得太低会直接换来 CPU throttling 和 OOMKilled。
七、Kubernetes 的转折:从命令到期望状态
容器本身只提供了两样东西:边界(namespace 给视图、cgroup 给配额)和打包(不可变镜像)。它不解决"放在哪"。
一台机器上跑 50 个容器,谁决定哪个容器上哪台?谁在它挂了之后重建?谁把流量摘掉?——这才是 Kubernetes 的位置:它不生产容器,它消费容器。
而它真正的转折不在"能跑容器",在期望状态这个抽象。
传统部署时代,你下达的是命令:"去 app03 上把进程起来。" 机器照做,做完就忘。Kubernetes 里你声明的是状态:"我要 3 个副本,镜像 v2。" 至于怎么达到、中间失败几次,是控制循环的事。
命令式关心动作,声明式关心结果。这个差别看起来只是 API 风格,实际决定了系统能不能自愈:命令执行完就结束了,没有"再检查一遍"的余地;而声明式天然可以无限次重试,因为目标状态一直摆在那里。
这也是为什么 Kubernetes 的 API 里最重要的动词不是 create,是 reconcile。
八、回到 Flink:这套历史在引擎里重演了一遍
Flink 自己的部署形态,几乎是这段历史的缩影。
Flink 1.x 的 Standalone 模式,就是"传统部署时代":TaskManager 数量固定,slot 数是静态分区。
# config.yaml
taskmanager.numberOfTaskSlots: 4   # 默认就是 1
parallelism.default: 8
numberOfTaskSlots: 4 的意思是:把一个 TaskManager 进程切成 4 份,每份跑一个 subtask。这和"把 32 核机器切成 4 个 8 核分区"是同一个思路——静态划分,划完不能动。并行度从 8 调到 16,slot 不够,只能加机器、改配置、重启集群。
后来交给 YARN:资源由 NodeManager 分配,Flink 申请 container。这一步相当于"虚拟化时代"——调度交给平台,但调度单位仍然是较粗的 container,而且是按作业峰值一次性申请的。
到 Flink 2.3,Kubernetes 已是主线:Application 模式下 JobManager 由 Deployment 承载,TaskManager 由 ResourceManager 按 slot 缺口动态创建,空闲 30 秒(resourcemanager.taskmanager-timeout)回收。而 Per-Job 模式在 2.0 已被移除——官方 Release Notes 的原话是"the removed per-job deployment mode",SQL Gateway 的 application mode 是它的替代。现在 execution.target 的合法值只剩六个:remote、local、yarn-application、yarn-session、kubernetes-application、kubernetes-session。打开配置页看一眼这个列表,比读任何演进史都直接。
| 传统部署时代 | Flink 里的对应物 | 被什么替代 |
|---|---|---|
| 整机分配 | Standalone + 固定 TM 数 | Native K8s 动态创建 TM |
| 静态分区 | numberOfTaskSlots |
RM 按 slot 缺口扩缩 |
| 采购式扩容 | 改 replicas 再等资源 | Pod 按需创建 |
| 手工保活 | 无 | K8s 重启 + checkpoint 恢复 |
但有个细节值得注意:Flink 内部至今保留了一次静态划分,就是 slot。slot 只隔离 managed memory,不隔离 CPU——它是内存的边界,不是计算的边界。
放到 Kubernetes 上,这会变成一个具体的坑:给 TM Pod 设 limits.cpu: 2,配 4 个 slot,4 个 subtask 共享 2 核。CPU 打满时它们互相抢,而 Flink 的 metrics 里看不出"谁抢了谁"。
这不是 Flink 的设计缺陷,而是资源边界的粒度问题会在不同层次反复出现:Kubernetes 的边界是 Pod,Flink 的边界是 slot,JVM 的边界是堆。三层边界不重合的地方,就是故障发生的地方。
传统部署时代的痛,本质也是这个——边界不重合。
九、什么时候仍然该用"传统"部署
写这篇不是要论证物理机已死。反例一直存在:
- GPU 训练机:H100 走 PCIe 直通,驱动与 CUDA 版本强耦合,容器化收益有限,不少团队仍是裸机加调度器。
- 高 IO 的存储节点:Kafka broker、ClickHouse 这类靠本地 NVMe 吃饭的,容器网络与存储抽象吃掉的那部分吞吐不可忽视。
- 极小的集群:三台机器的 Flink 集群,上 Kubernetes 要额外养一套控制面(etcd、APIServer、网络插件),开销可能超过收益。
判断标准不是新不新,而是三个问题:
- 资源是否需要细分到应用?——需要,就用容器。
- 扩容是否需要快于采购周期?——需要,就用编排。
- 副本数是否多到人力管不过来?——是,就用控制器。
三个都答"否",那么 systemd 加一台好机器,是更简单也更可靠的方案。
写在最后
官方把这段历史写成三代,读起来像技术进步的自然叙事。但从工程角度看,三代解决的是同一个问题的三个层次:资源怎么切、切完谁来放、放完谁来守。
传统部署时代把这三件事全交给了人。人很聪明,但人不可扩展。当应用从 10 个涨到 1000 个,边界从 10 个涨到 10000 个,唯一的出路是把决定权交给一个控制循环。
