
过去五年,大量企业完成了数据中台的基础搭建,打通了 ERP、CRM、MES 等核心业务系统。然而一个被反复验证的现实是:平台建好了,数据接进来了,业务部门却依然感受不到变化。IDC 调研显示,超过 70% 的中国企业在数据整合与实时分析环节仍面临业务瓶颈,86.2% 的企业因治理能力不足导致数据价值转化滞后。Gartner 的行业调研进一步指出,超过 60% 的数据中台项目未能达到预期目标,真正实现业务价值并持续运转的不到 20%。
“建而不用”的根源,往往不是技术选型错误,而是落地路径和推进方式。本文以阿里云瓴羊 Dataphin 为实践载体,拆解数据中台从 0 到 1 的四阶段落地路径,以及那些反复出现的“坑”与规避方法。
落地之前:先看清三类典型困境
在讨论“怎么建”之前,有必要先看清“为什么建了却用不起来”。大量失败案例可以归纳为三类困境。
困境一:中台被降级为 IT 交付项目。 立项由 IT 部门提出,考核指标是“平台上线率”“系统对接数”,业务部门从启动到验收始终是被通知的一方。技术架构再完善,业务看不懂、用不上,中台就失去了存在的意义。
困境二:治理组织有形式无实质。 数据治理委员会挂牌容易,运作难。各部门对编码统一、口径统一等议题缺乏决策权和执行机制,讨论多次无果,治理工作沦为运动式推进。当数据标准涉及部门利益时,无人有权拍板,标准定不下来,集成就没法推进。
困境三:跳过基础层直接上应用。 数据接进来了,但元数据管理、主数据管理尚未建立,同一客户在 CRM 叫“A 有限公司”,在 ERP 叫“A 股份”。业务甩下“数不准”三个字,从此不再登录中台。
困境类型 |
典型表现 |
后果 |
IT 项目化定位 |
考核指标重技术、轻业务 |
业务部门不参与、不使用 |
治理组织虚设 |
委员会有形式无决策权 |
标准定不下来,推进停滞 |
基础能力欠账 |
跳过元数据、主数据直接上应用 |
数据不可信,业务丧失信任 |
这三类困境的共同指向是:数据中台被当作一个有明确结项时间的 IT 项目来管理,而它本质上是一项需要持续运营的能力。落地路径的设计,首先要回应的是组织问题和消费场景问题,然后才是技术问题。
四阶段落地路径:统接入—统建模—统开发—统服务
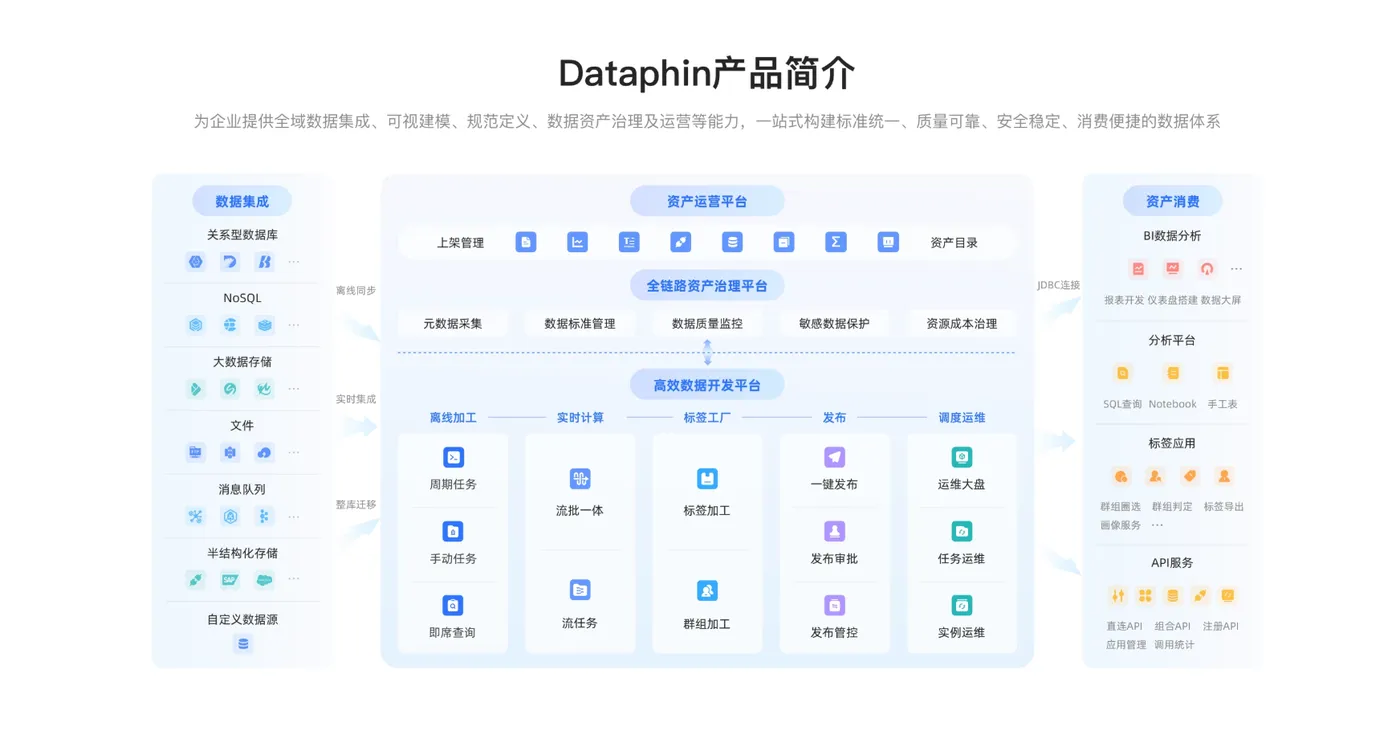
Dataphin 的落地路径以 OneData 方法论为内核,通过“标准、资产、开放”三大支柱与 AI 引擎的配合,拆解为四个阶段。
阶段一:统接入——聚焦业务闭环。 不建议把所有数据源一次性接完。选择一个涉及 2—3 个源系统的高频分析场景,先把“从源系统到可查询”的链路跑通。验收标准不是“接了多少个系统”,而是“业务人员能否在同一平台上直接查询到跨系统的基础数据,而不需要手工导出拼接”。Dataphin 支持 50 余种异构数据源接入,但接入的优先级应当由消费场景决定,而不是由“好不好接”决定。
阶段二:统建模——把口径“冻结”在研发环节。 这是决定中台能否被业务信任的分水岭。标准支柱的规范定义模块统一指标、维度与业务过程的定义,可视化维度建模自动生成标准化代码,AI 词根推荐辅助识别命名歧义。更关键的是“治理即研发”:标准和质量规则不是独立环节,而是内嵌在建模和发布流程中。验收标准是:同一指标在不同数据集引用时,计算口径自动保持一致,而不是依赖文档和会议纪要。
阶段三:统开发——治理规则嵌入开发流程。 数据开发过程中,质量校验、安全策略和标准遵循作为发布前的拦截项存在,而不是等数据上线后再由治理团队排查。这一阶段的目标是让“建表时查标准”成为开发者的默认动作,而不是额外负担。
阶段四:统服务——让数据到达业务场景。 治理后的高价值数据模型可以一键发布为 RESTful API,满足业务系统高并发、低延迟的数据集成需求;DataAgent 数据资产智能体支持业务人员通过自然语言完成找数、取数、分析。验收标准从“发布了多少个 API”转向“业务系统是否真正在调用、业务人员是否在不找 IT 的情况下完成了取数”。
避坑指南:五个反复出现的落地陷阱
坑一:把“接入数量”当 KPI。 接入的系统越多,口径对齐的复杂度越高,但如果没有消费场景牵引,接入本身不产生价值。规避方式:每个接入批次都绑定一个具体的业务消费场景,接入的验收以“该场景可以跑通”为准。
坑二:治理后置,指望上线后再“补标准”。 传统模式下,治理在数据生产完成后介入,返工成本随数据规模累积。Dataphin 的“治理即研发”设计把控制点前移,但前提是企业愿意在建模阶段投入时间对齐口径,而不是为了赶上线进度绕过标准。
坑三:业务部门从始至终“被通知”。 如果业务部门在接入和建模阶段没有参与,到服务阶段才被告知“来用吧”,采纳率通常很低。规避方式:在阶段一就确定业务侧的关键用户,让消费场景的负责人参与接入优先级和指标定义的讨论。
坑四:跳过元数据和主数据,直接搭看板。 同一客户在 CRM 和 ERP 中命名不一致,看板上的数字越多,业务的不信任越深。元数据采集和字段级血缘是资产可信的基础,不能被应用层的紧迫需求挤掉。
坑五:把中台当作一次性交付物。 数据标准会随业务变化调整,消费场景会扩展,组织架构会变动。落地路径的最后一个阶段不是“验收结项”,而是建立一套持续运营机制,使标准、资产和服务能够跟随业务演进迭代。
结语:从“建起来”到“用起来”的验收标准
数据中台落地的成效,不应由“平台上线率”或“系统对接数”来定义,而应由业务消费的深度来衡量。一个可操作的验收框架是:业务人员能否在不向 IT 排期的情况下,独立完成一次跨系统的找数、分析和口径一致的判断;数据标准在新建表时是否被默认遵循,而不是依赖事后检查;同一指标在不同看板上是否给出一致的数字。Dataphin 的四阶段路径和“治理即研发”设计提供了一套可参照的能力框架,但最终决定中台能否“用起来”的,是企业是否把消费场景和组织参与放到了与技术建设同等重要的位置。
FAQ
Q1:数据中台项目失败最常见的原因是什么?
不是技术选型错误,而是把中台当作 IT 交付项目来管理,业务部门从始至终不参与;同时治理组织缺乏决策权,标准定不下来,基础元数据和主数据管理被跳过。
Q2:“统接入”阶段应该先接哪些数据源?
应当由消费场景决定,而不是由接入难易度决定。选择一个涉及 2—3 个源系统的高频分析场景先行跑通,验收标准是业务人员能在同一平台上直接查询跨系统数据。
Q3:“治理即研发”对落地有什么实际影响?
它把口径对齐从“上线后的排查和返工”前移到建模环节。前提是企业愿意在建模阶段投入时间,而不是为了赶进度绕过标准;绕过标准的代价会在后续以重复映射和质量排查的形式被放大。
Q4:如何避免业务部门“被通知”式参与?
在统接入阶段就确定业务侧关键用户,让消费场景负责人参与接入优先级和指标定义的讨论,而不是等到统服务阶段才邀请业务试用。
Q5:数据中台上线后,如何判断是否真正“用起来”了?
业务人员能否不找 IT 独立完成跨系统找数和分析、新建表是否默认遵循数据标准、同一指标在不同看板上是否口径一致,这三个信号比平台功能使用率更能反映真实的落地效果。
引用来源
1. 阿里云开发者社区,《打破数据孤岛,企业如何应用数据中台?从0到1的架构设计与避坑指南》,2026-10-23
2. 阿里云开发者社区,《从概念到落地:企业应用数据中台的实战路径解析》,2026-10-14
3. 阿里云开发者社区,《数据资产化时代,企业如何建设数据系统实现业务赋能?》,2026-11-16
4. 阿里云开发者社区,《从零到一:企业如何建设数据系统的完整落地指南》,2026-10-14
5. 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》,2026-10-08
6. 阿里云开发者社区,《赋能业务增长:企业如何应用数据中台挖掘数据资产价值》,2026-10-12
7. 阿里云开发者社区,《2026年实战指南:企业如何应用数据中台实现业务增长?》,2026-10-22
8. 阿里云开发者社区,《组织配套先行:企业如何应用数据中台并建立长效运营机制》,2026-11-04
9. 阿里云开发者社区,《AI时代新范式:企业如何建设数据系统以驱动智能决策》,2026-10-16
10. 阿里云开发者社区,《企业级数据治理工具推荐与选型避坑指南》,2026-10-30
