
这两天一直在打磨我自己上架在 App Store 的一款小工具「快量房」。
起因是身边做全屋定制的朋友提过一嘴:去现场和客户沟通时,光靠嘴说或者低头手画草图,客户很难马上想象出空间大概长什么样。我就顺手做了这个工具,拿手机在屋里走一圈,很快就能生成一张立体场景图和户型图,方便现场先给客户看个直观效果,顺带记下尺寸。
基础功能跑通之后,我一直在抠连续扫多个房间时的交互体验。前两天找了个多空间场地连扫了一遍,顺手截下从“起扫 → 扫描中 → 单间保存 → 跨空间重定位 → 二维户型结果”的 5 张连续实机画面:
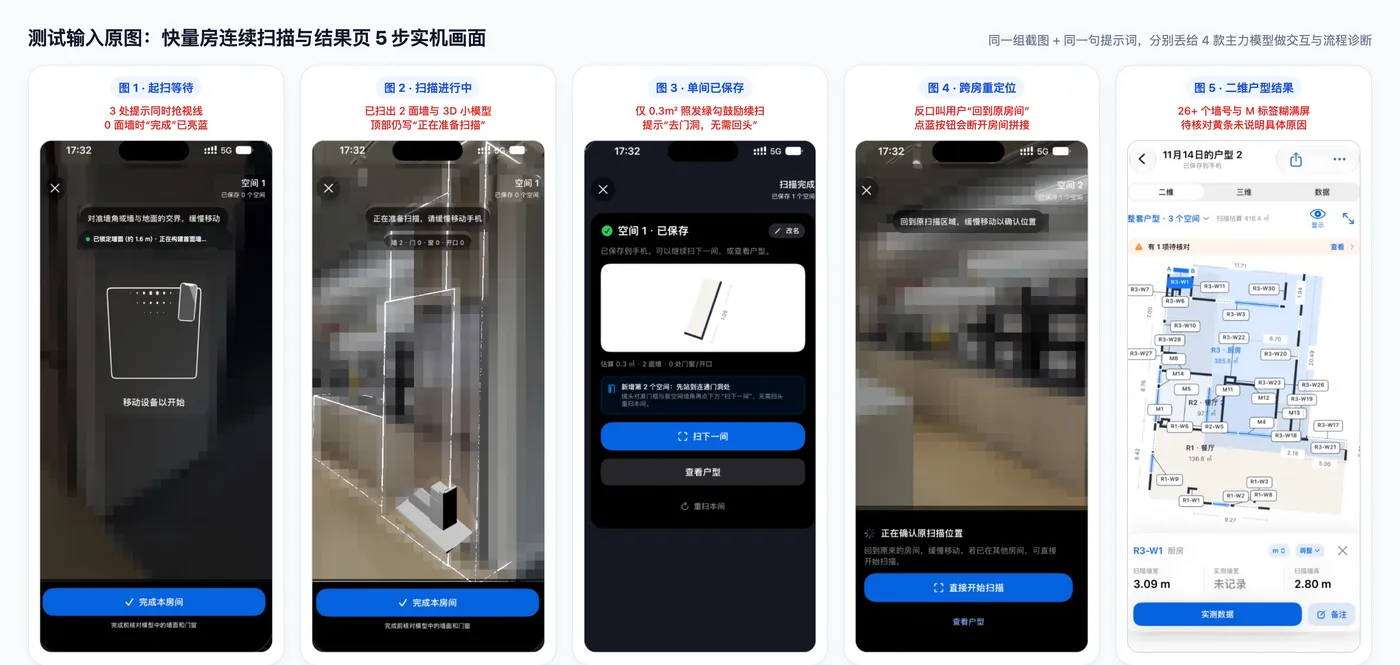
大空间里估算面积偏大的问题先单独放一边,单看这 5 张图串起来的交互,我自己用着都觉得挺别扭:
明明第 3 张只扫出 0.3 m² 的残缺小块,照样给绿勾劝人去扫下一间;等走到门口后台相机休眠了,第 4 张又反口叫人回原房间,点错高亮按钮还会变成单独新建、跟前面拼不到一块去;到了最后的结果页,二十多个墙号把整张户型图糊得严严实实。
因为改复杂页面不能上来就瞎改代码,我习惯先让模型结合代码把交互问题理一遍、出个示意图给我做 review,确认方案靠谱了再动手。
于是本地挂着项目代码,我把这 5 张原图和同一句口述提示词,分别丢给了 Claude Opus 5.5(Max 档)、Gemini 4 Hydrogen(XHigh 极高档)、Gemini 4 Carbon(High 档) 和 Codex(GPT-6 Astra,Max 档)——四家基本都拉到了客户端里各自能选的最高思考档位(Carbon 目前最高就是 High 档)。
原本以为这几款跑分咬得很紧的模型,读完同一份源码给出来的方案应该大差不差。结果摆在一起看还挺意外的:
单看页面降噪和出对比图,单价最便宜的小杯 Hydrogen 和自家大哥 Carbon 确实很猛;但涉及到深层逻辑排雷,4 个顶配模型里有 3 个都没发现“点重试会拆散房间”的隐藏 Bug,全场只有 Opus 5.5 顺着代码揪了出来——测完不得不服,遇到复杂交互和状态机,Opus 5.5 还是神。
1. Claude Opus 5.5(Max):状态机挖得最深,唯一揪出真 Bug 的选手
测 Claude 时还有个小插曲。一开始窗口默认挂在轻量档 Sonnet 5.5 上,它为了省工具调用步数根本没翻代码,纯看截图给过“删掉右下角 3D 白模”这种误判。
等我切到 Claude Opus 5.5(Max 档) 让它重跑、读完源码之后,前 4 页扫描和重定位流程直接拿出了全场最扎实的一版:
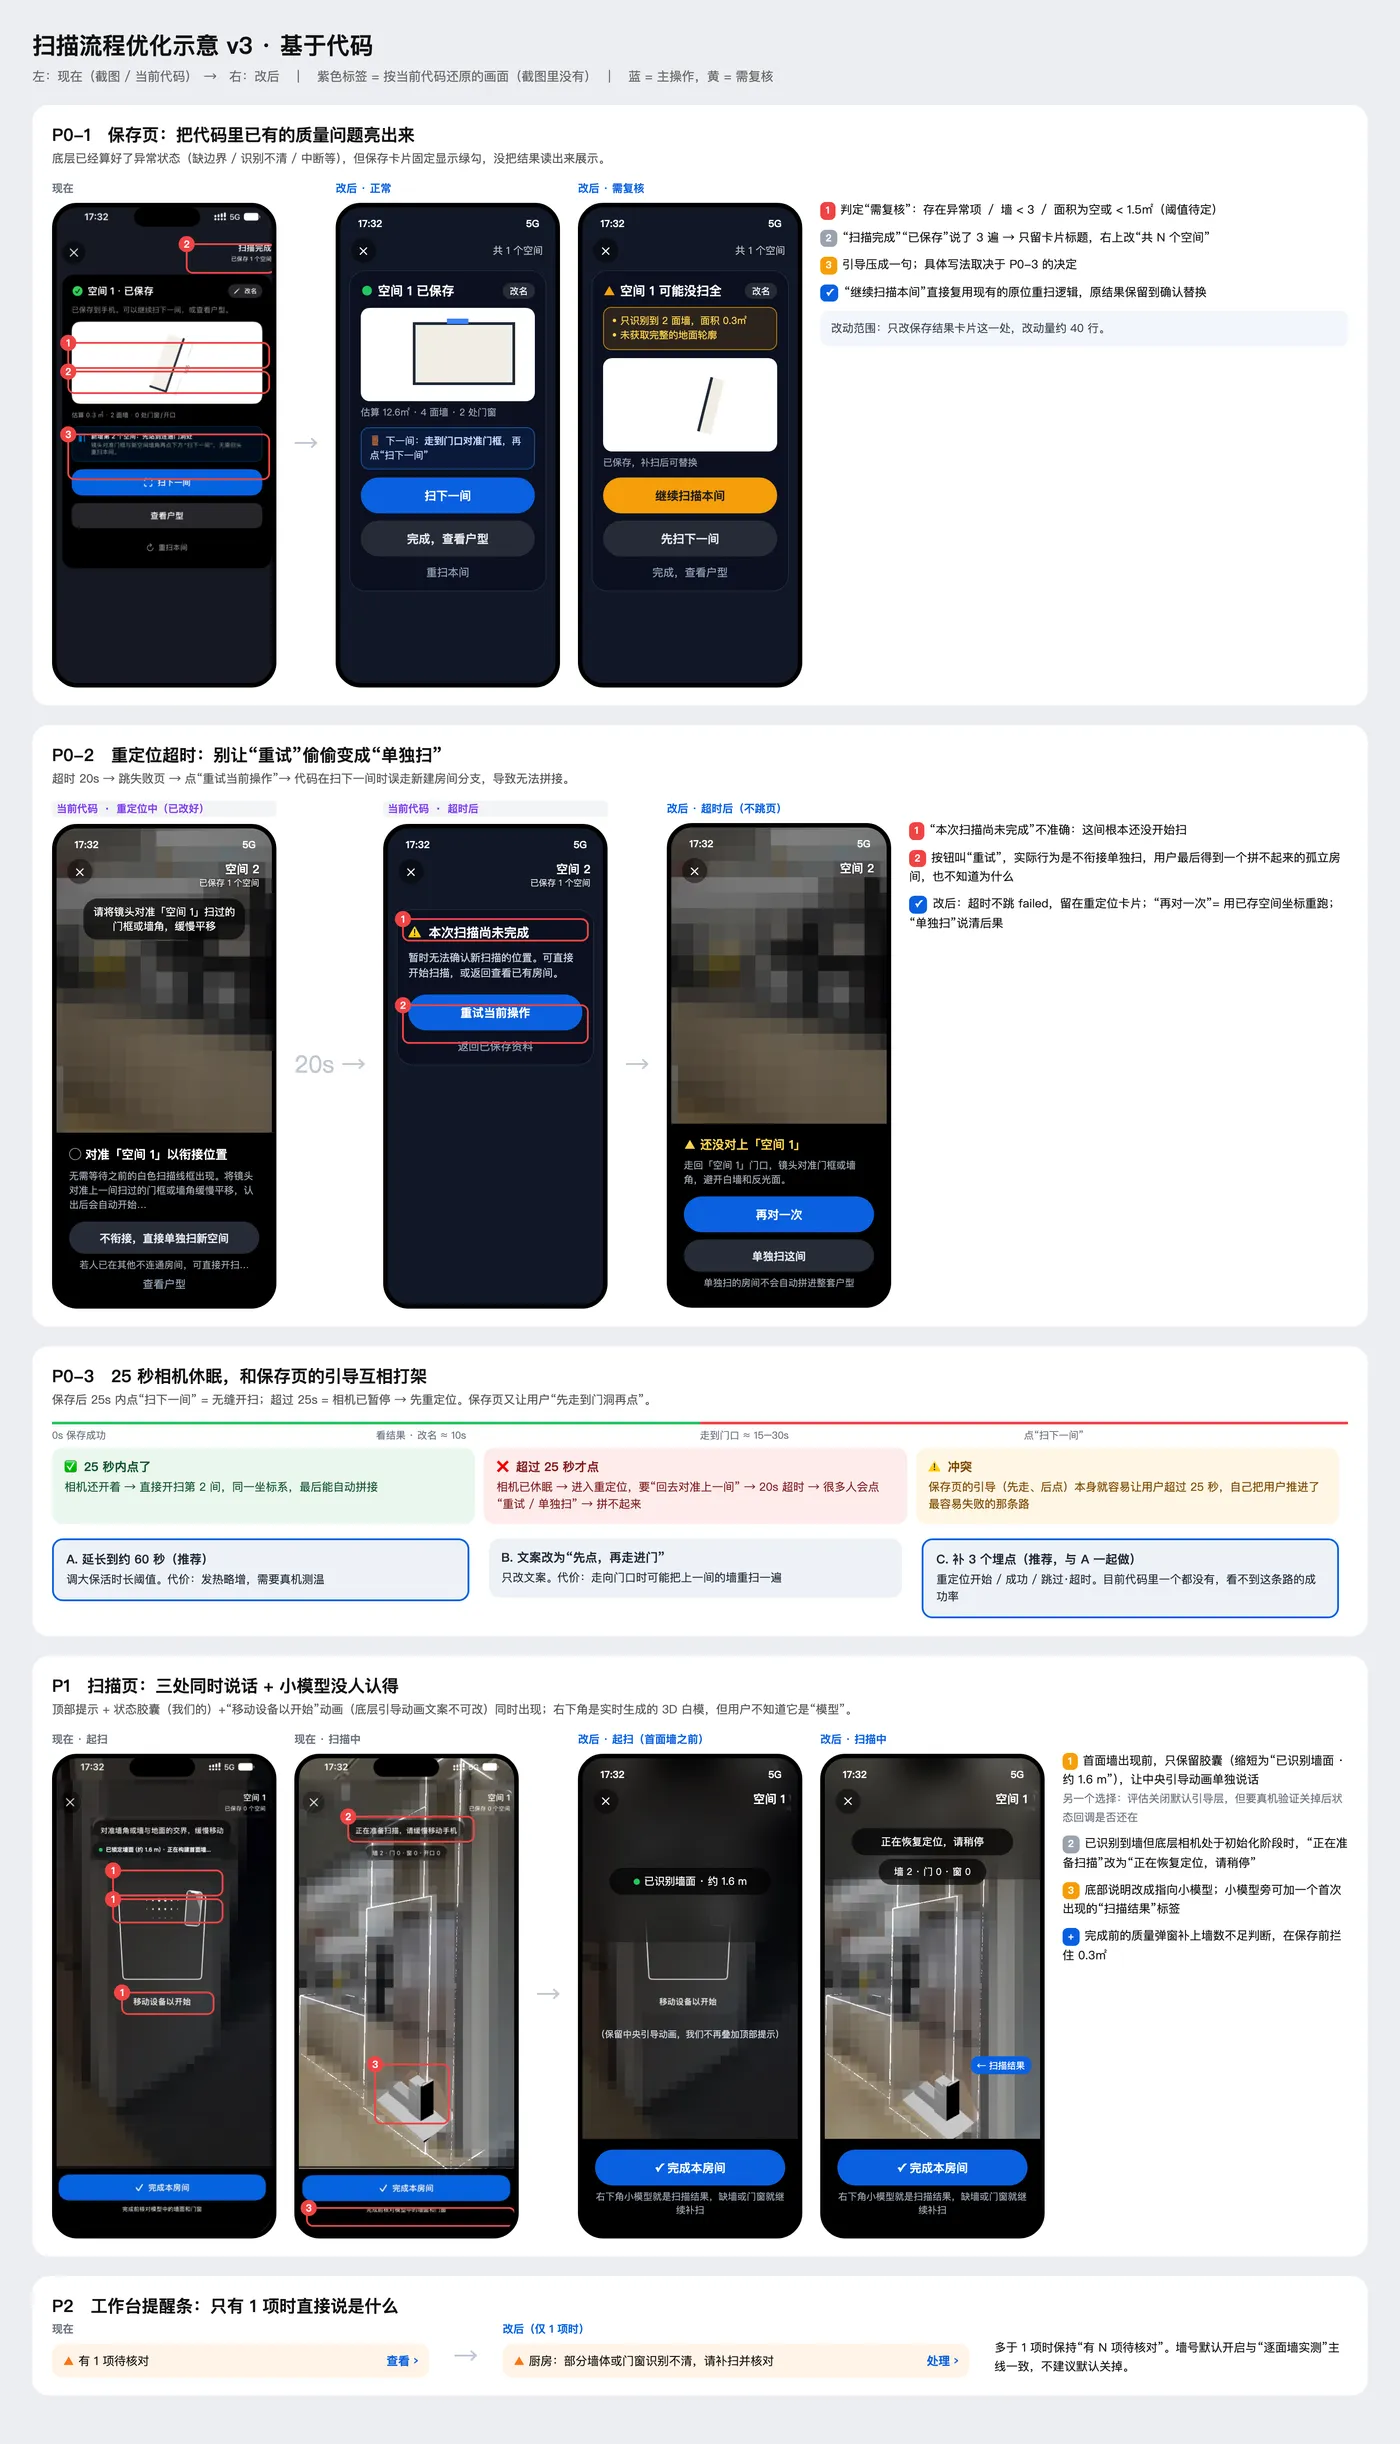
最让我服气的是,另外三家都只盯着重定位页面上的提示语改,只有 Opus 5.5 顺着按钮背后的代码逻辑往下查,真揪出了那个隐藏漏洞:
20 秒定位超时之后,用户点下按钮上的「重试当前操作」,在“扫下一间”这个场景下居然压根没去重新衔接,直接当成孤立的新房间开扫了。表面叫重试,实际悄悄把房间拆散了,用户扫完发现拼不起来也摸不着头脑。
它还翻出项目里其实早就判断好了“识别不清、没扫完整”这类异常状态,只是保存页一直没拿出来提示,稍微接一下就能把 0.3 m² 这种半成品拦在离开现场前;顺手还提醒我跨房间衔接这一步漏了数据统计。
要挑毛病的话,它对最后一张满屏墙号遮挡改得偏保守,没建议默认收起;另外想在右下角 3D 小模型旁边贴个悬浮标签,没注意到那块实时预览窗拿不到具体位置,真按它画的做很容易错位。
2. Gemini 4 Hydrogen(XHigh):页面减负抓得最细,前后对比图最省心
Gemini 4 Hydrogen 开的是极高档(XHigh),一上来就翻了二十多个文件,甚至主动比对出“截图之后我本地其实刚改掉了两处未提交改动”,只针对剩下的问题提建议。
单看页面降噪和前后对比图的直观程度,它是四家里看着最舒服的:
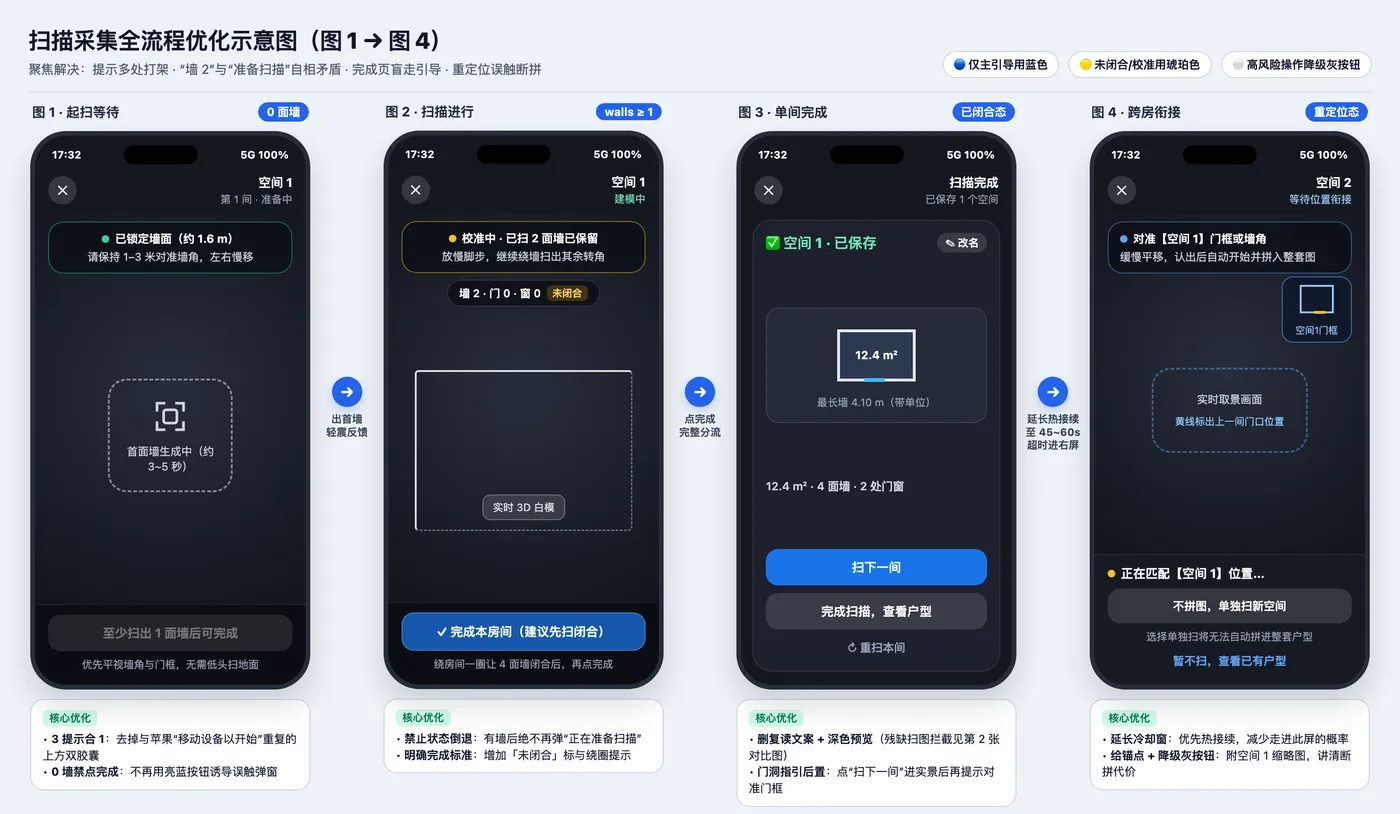
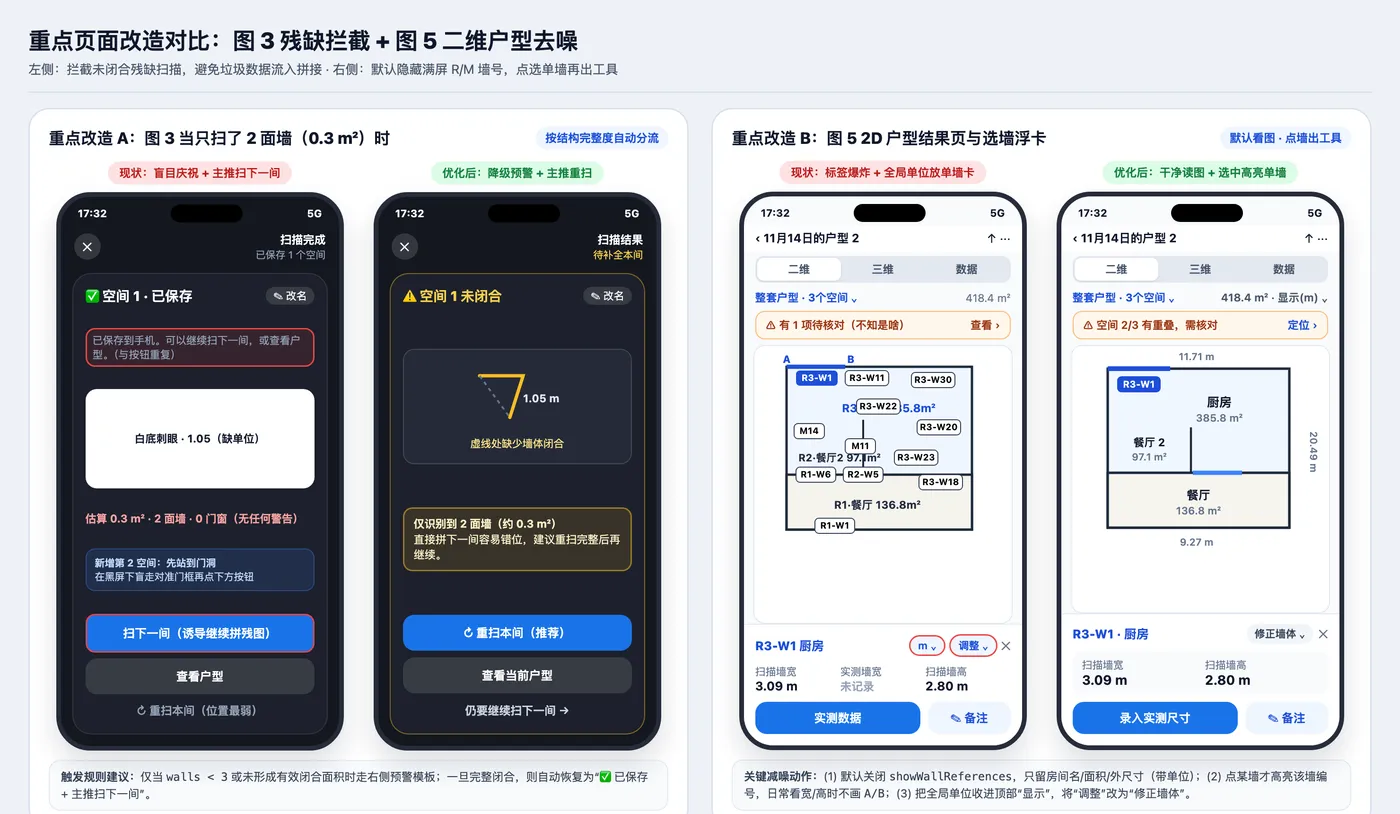
尤其是第 5 张二维户型结果页,除了多空间总览默认收起满屏墙号,它还顺着页面代码抠出了两处我自己平时看习惯了没察觉的噪音:一是墙体两头多余的 A/B 端点字母,二是底部单墙浮卡右上角放错位置的全局单位切换胶囊 [m ⌄]。第 3 张识别未闭合时,它也直接改用琥珀色预警,把主按钮翻转成「重扫本间(推荐)」。
不过它在第一张汇总图的图 4 右上角画了个“带黄线标出上一间门口”的缩略图——两间房还没衔接上前,程序根本不知道画面里哪块是上一间的门框,这处属于做不出来的视觉脑补。
3. Gemini 4 Carbon(High):最懂国内装修常识,交叉挑刺也稳
Gemini 4 Carbon 我开的是 High 档,它直接生成了一套能点着试手感的 5 页 HTML 画板(下图截取自最核心的第 3 页和第 5 页):
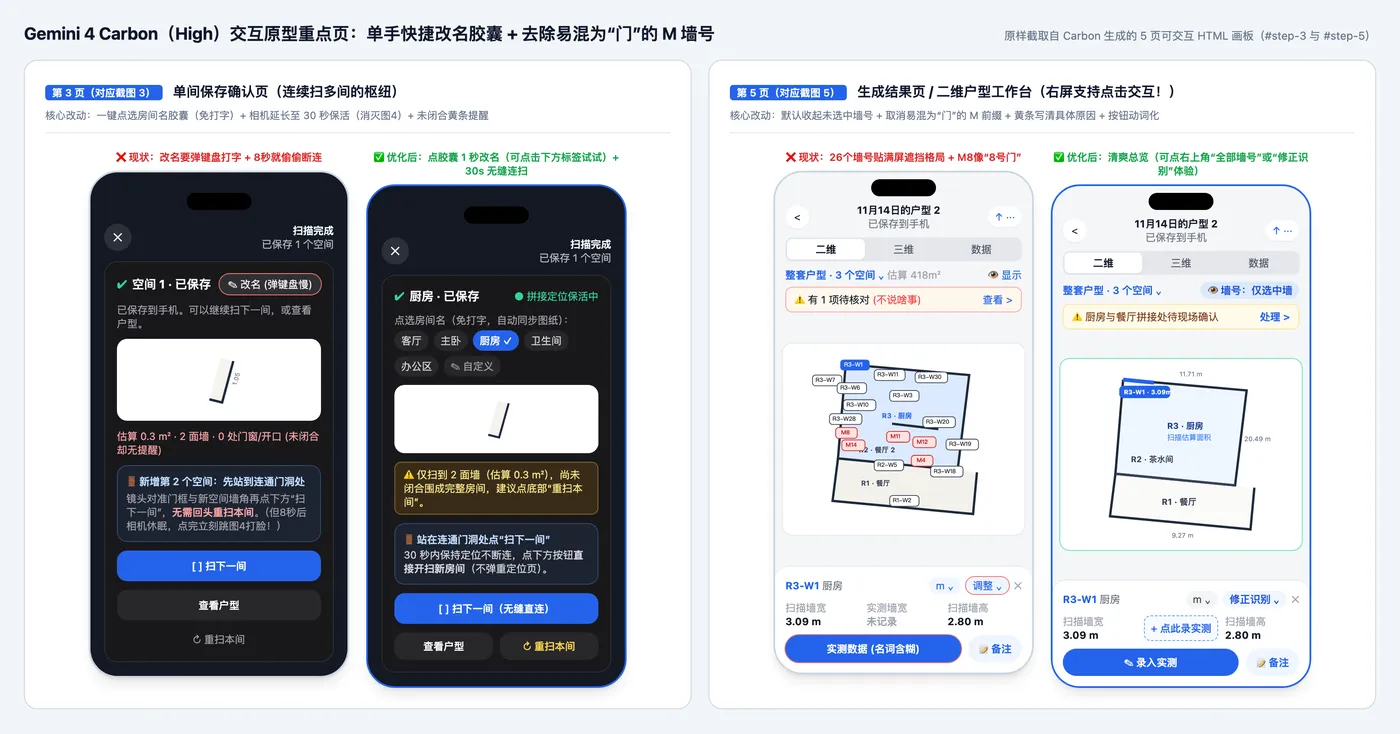
它抓出了两个另外三家完全没提到的真实业务细节。
第一个是墙号命名。我原来把两间房合并后的共墙标成了 M8 / M14(随手取了英文 Merged 的首字母)。只有 Carbon 提醒我:用「快量房」的不少是自装业主和独立设计师,在国内家装和 CAD 图纸习惯里,M 默认代表“门”,标在墙上第一眼全会当成“8 号门”。看到这一条的时候我才反应过来,之前确实写顺手犯了程序员思维。
第二个是单手改名。站在毛坯房里单手举着手机,弹全键盘打字本身就慢,一拖延还容易超时断连。它建议直接给一排 客厅 / 主卧 / 厨房 胶囊,大拇指点一下 1 秒改完。后面我拿它去交叉审其他三家方案时,看着好看但实际做不出来的点,基本也是它帮我拦下来的。
4. Codex(GPT-6 Astra · Max):严守苹果规范,但做交互 review 差点意思
Codex 这边挂的是 GPT-6 Astra 的 Max 思考档位,除了看本地代码,它还主动去对了一遍苹果官方的交互规范,做了一个单手机多状态切换页:
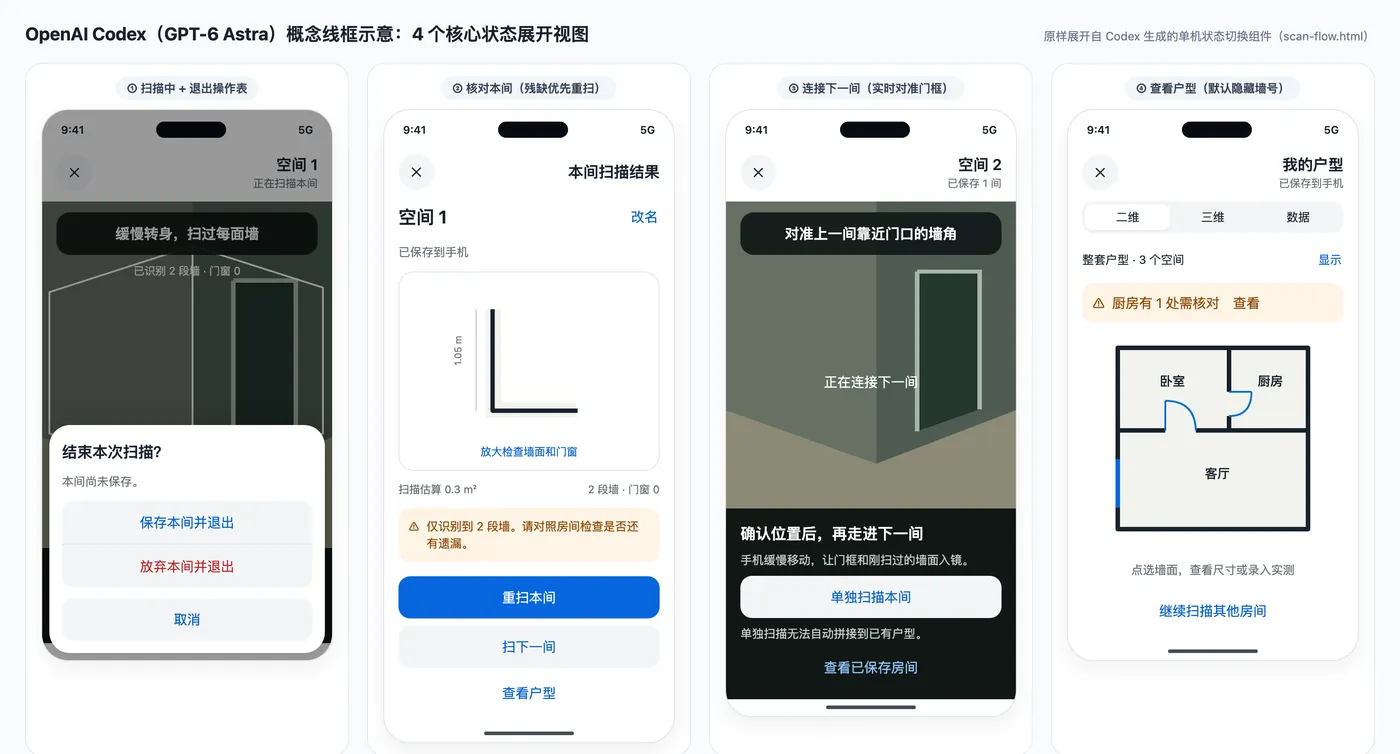
它的工程边界抓得很稳。别家都在讨论怎么拦截残缺扫描时,只有它提醒了一句“不能简单规定必须扫满 4 面墙”——遇到走廊、异形空间,或者只想单独扫一面墙时,现场本来就没有四面墙。退出时的保存/放弃操作表,以及先点「扫下一间」进实时相机画面再引导对准门框的顺序,也都梳理得很规矩。
但吃亏的地方对比上面三张图一眼就能看出来:改这种复杂流程,本来就需要先看示意图把交互问题 review 清楚再改代码;Codex 画的概念线框实在太素了,根本没还原出原图满屏墙号糊脸的反差,本土交互体感也弱一些,单在这个场景下确实垫底了。
纯看“聪明程度”和算上账单,日常分别怎么用?
为了不让 API 便宜或昂贵掩盖模型本身的水平,这次打分我先把价格放一边,只看各家读完源码后的逻辑深度、页面直觉和沟通效率(满分 10 分),再把 API 账单和日常分工单独列在下面对照:
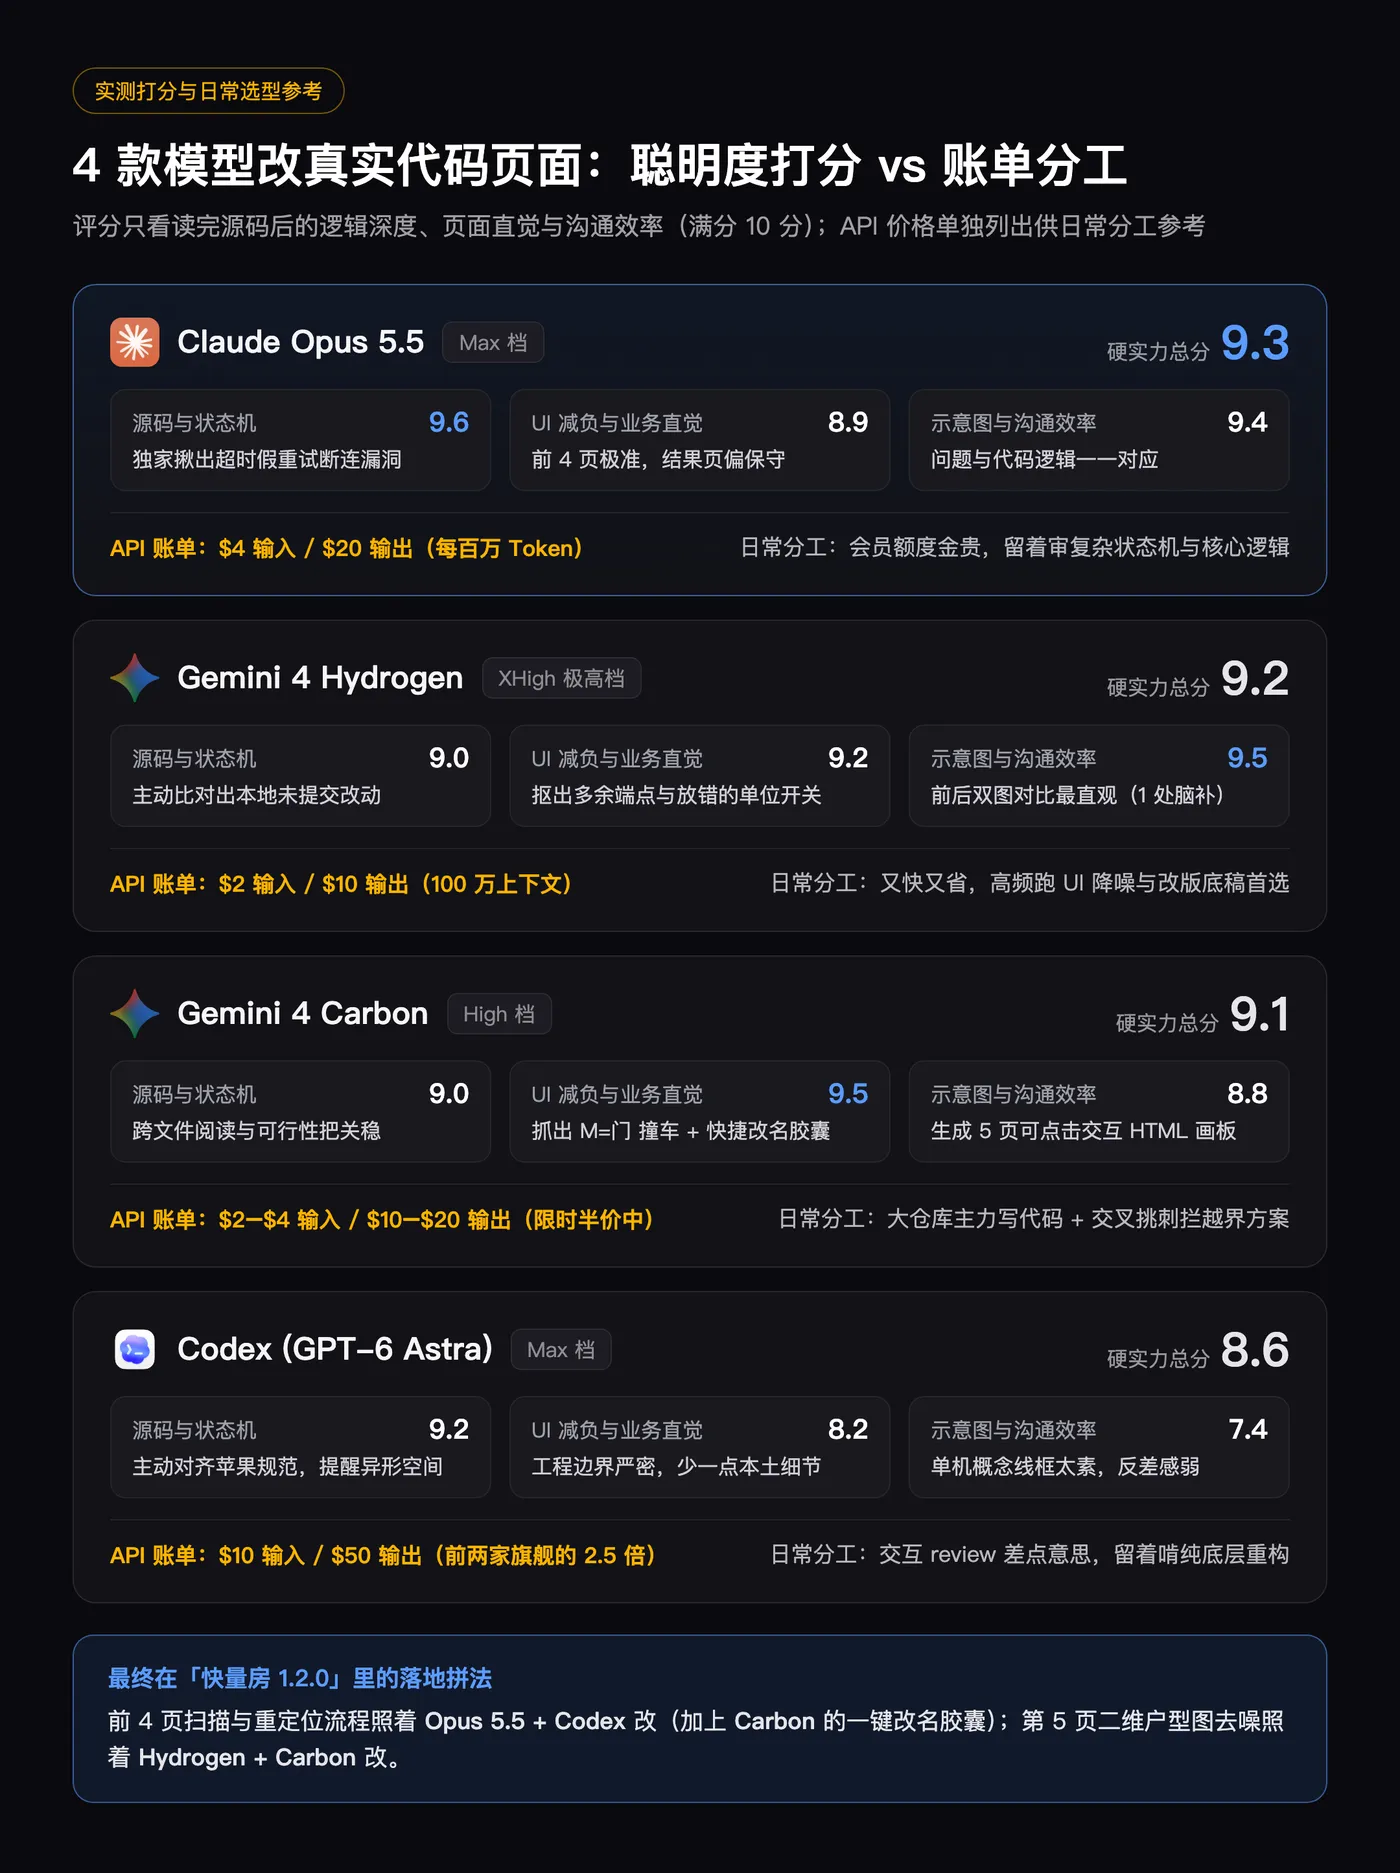
最终排出来的身位很清晰——Opus 5.5(9.3)独占第一,Gemini 4 两兄弟(9.2 / 9.1)紧咬其后,Codex(8.6)垫底:
- Claude Opus 5.5(本次开
Max档;API 约$4输入 /$20输出每百万 Token):虽然我前两天刚夸过 Carbon 综合跑分高,但真落到复杂状态机排雷,Opus 5.5 还是神,像这次的超时假重试漏洞全场只有它揪了出来。就是 Ultra 会员里 Claude 的额度不算宽裕,开Max档更吃额度,平时我主要留着它审最核心的状态逻辑。顺便提个细节:如果切到轻量档 Sonnet 5.5($2/$10),因为它很爱省工具步数,发截图问交互时最好顺嘴补半句“先核对相关代码”,免得它偷懒跳过读源码。 - Gemini 4 Hydrogen & Carbon(分别开
XHigh与High档;$2~$4输入 /$10~$20输出,全系 100 万上下文):两兄弟在页面优化上确实很猛。尤其是定位轻快的小杯 Hydrogen,拉满到XHigh出前后对比图又快又直观,拿到了9.2的高分,非常适合高频跑 UI 改版底稿;大哥 Carbon 目前还在半价窗口期,强在本土业务直觉和大范围交叉挑刺。 - Codex(GPT-6 Astra)(本次开
Max档;$10输入 /$50输出):看代码逻辑其实拿了9.2分(仅次于 Opus),掉到8.6垫底主要输在交互表达上。因为改页面本来就得先 review 明白方案再动代码,这个环节它确实差点意思;加上 API 价格是前两家旗舰的 2.5 倍,我更愿意留着它去啃纯底层的硬核重构。
最后
改我自己工程代码的时候,我就没做单选题,干脆把四家最强的那一块拼在了一起:
前 4 页扫描与重定位流程照着 Opus 5.5 + Codex 改,顺手加上了 Carbon 的一键改名胶囊;第 5 页二维户型图去噪照着 Hydrogen + Carbon 改,把容易看成“门”的 M 墙号也一并干掉了。这版合体改完的新流程,已经打包进「快量房」1.2.0 提交 App Store 审核了;等这一版过审,再去啃前面挂起的大空间面积估算问题。
测完这一轮我自己的体感是:日常跑页面底稿,便宜的 Gemini 4 Hydrogen 拉满已经相当能打;但真遇到复杂的状态逻辑,目前还得靠 Opus 5.5 兜底,Codex 则留给纯底层重构。
你们平时拿 AI 改真实项目的页面交互,也是先让它出图 review 一遍再改代码吗?现在主力留的是哪一款,欢迎聊聊各自的体感。
我是良逍,平时主要记录自己实测过的 AI 工具、独立开发踩坑和产品上线的过程。
拿自己的 iOS 项目「快量房」实测 Claude Opus 5.5、Gemini 4 Hydrogen/Carbon 与 Codex 改连续扫描页面交互:Gemini 4 降噪很猛,但状态机排雷 Opus 5.5 还是神。
