
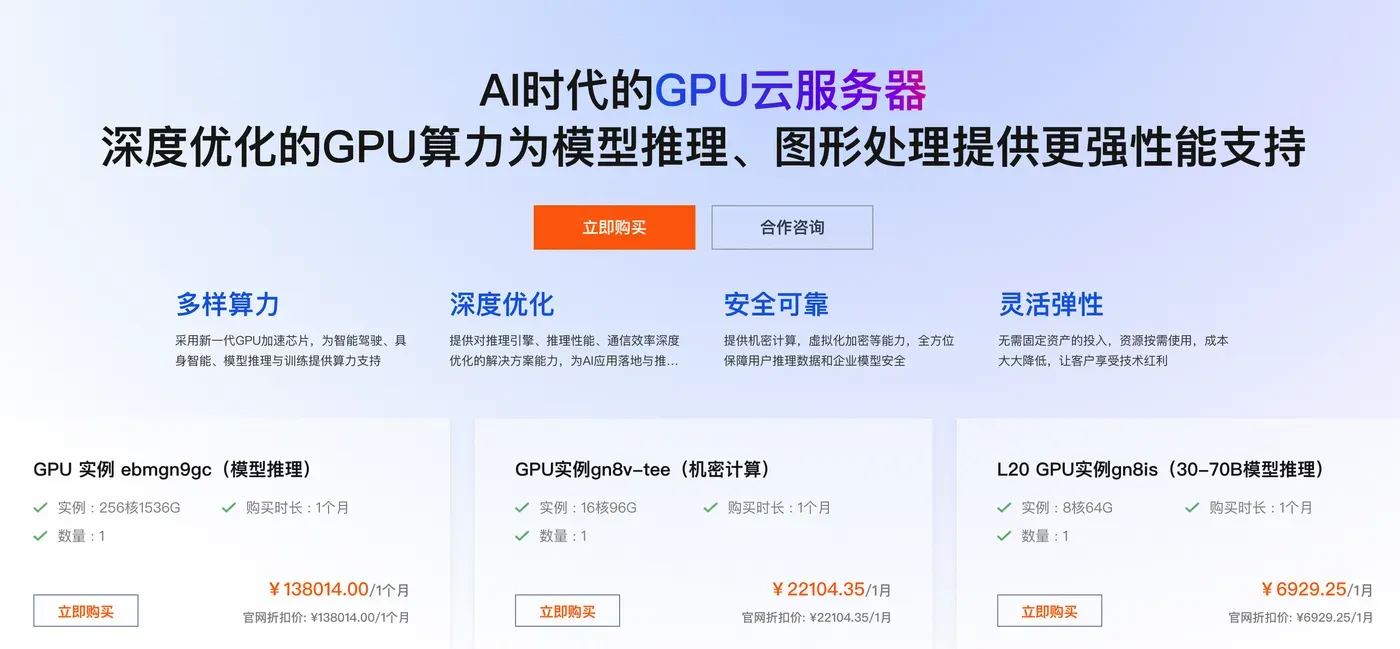
深度学习任务,如何选择阿里云服务器ECS实例规格族?深度学习任务选择ECS实例规格族,核心取决于任务是训练还是推理,以及模型规模对GPU显存和互联带宽的要求,详细查看阿里云GPU服务器官网:https://t.aliyun.com/U/tbBeAi 如下图:
一、GPU与CPU配比建议
根据ECS实例规格选型指导,深度学习场景的GPU与CPU配比推荐如下:
- 深度学习训练:GPU与CPU比例推荐为 1:8 到 1:12 之间。
- 通用深度学习:GPU与CPU比例推荐为 1:4 到 1:48 之间。
二、按训练规模选型
1. 大规模分布式训练(多机多卡)
- ebmgn7ex:GPU计算型弹性裸金属服务器,配备8张NVIDIA A100(80 GB显存),支持eRDMA网络互联,带宽达160 Gbit/s,适用于Transformer等高通信负载的大规模AI训练。
- sccgn7ex:GPU计算型超级计算集群,适用于超大规模机器学习集群训练。
⚠️ 重要警告:使用高通信负载的AI训练业务(如Transformer模型)时,务必启用NVLink进行GPU间数据通信,否则可能因PCIe链路大规模数据传输引起非预期故障,导致数据受损。
2. 中小规模训练(单机多卡/单卡)
- gn7e:配备NVIDIA A100(80 GB显存),支持1/2/4/8卡灵活配置,适用于中小规模AI训练、图像分类、无人驾驶、语音识别等深度学习算法训练。
- gn7:配备NVIDIA A100,适用于深度学习训练及高GPU负载的科学计算。
- ebmgn7e:GPU计算型弹性裸金属服务器,配备8张NVIDIA A100(80 GB显存),适用于各类深度学习训练开发业务。
三、选型注意事项
- 地域库存确认:不同地域可购买的GPU实例规格不同,建议通过ECS实例可购买地域页面确认目标规格在所选地域的库存情况。
- 性能验证与调整:完成选型后,建议根据一段时间的性能监控信息验证实例规格是否合适;若发现资源利用率过低或瓶颈,可通过升降配调整至更匹配的规格。
- 驱动版本:创建GPU实例时需关注驱动与CUDA版本的兼容性,不同GPU规格族支持的驱动版本不同。
- 成本考量:自建训练集群时,应以"刚好满足显存与吞吐要求"为准则选型,避免过度配置;具体单价请以ECS控制台与价格计算器实时报价为准。
更多关于阿里云服务器ECS选配指南及问题解答,请查看阿里云服务器ECS官网:https://t.aliyun.com/U/AZBUsA
