
历史轨迹查询的常见条件并不复杂:车辆标识、开始时间和结束时间。但查询范围扩大后,仅把全部点位一次性返回,往往会把数据库读取、接口传输和前端绘制的问题集中到同一个请求里。
设计时可以先确定数据语义,再分别处理查询、加载和显示。本文讨论定位点查询的通用方法,不假定必须使用某家云产品或某一种数据库。
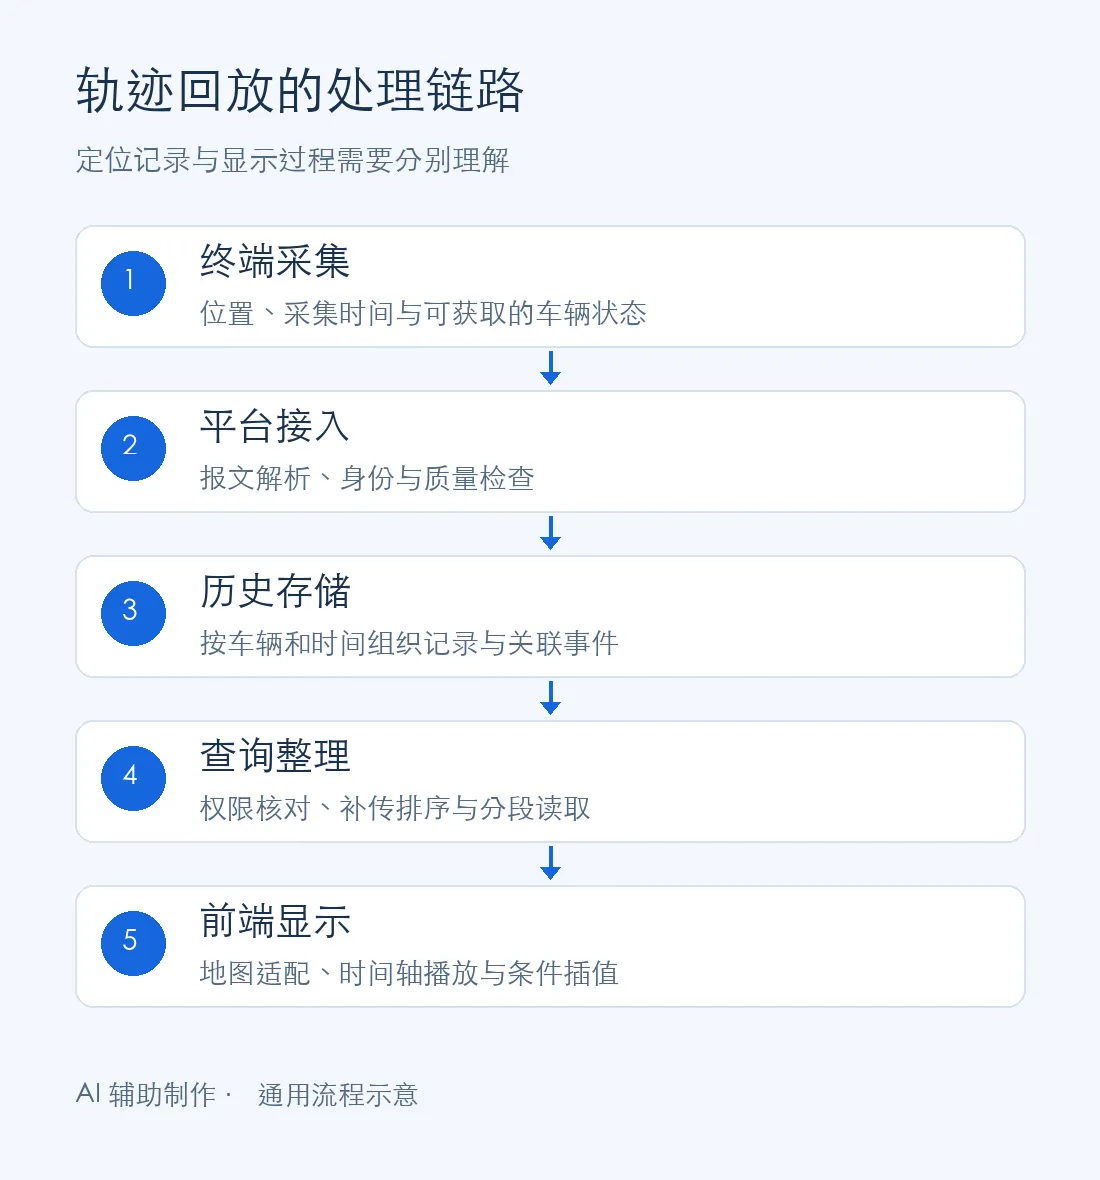
定位数据从采集到回放的处理流程示意。
先把时间范围和访问范围固定下来
查询必须先限定用户有权访问的车辆。在多租户业务中,租户范围也应进入权限过滤和数据访问设计,不能仅凭前端传来的车辆编号读取数据。
时间条件应明确使用定位时间还是接收时间。回放主要按照定位时间还原顺序,接收时间则帮助识别迟到或补传。二者混用,会让同一次行程被拆进不同查询区间。
区间边界也要一致。例如,连续分段使用左闭右开的范围,可以避免边界记录被重复统计。为了绘线额外读取的相邻点,不应被重复计入当前段统计。
索引应对应真实查询条件
在支持复合索引的关系数据库中,可以围绕租户、车辆和定位时间等实际过滤条件评估索引设计,再结合排序及内部记录标识处理同时间记录。索引顺序和有效性,需要用实际执行计划确认。
按时间分区有助于限定读取范围和管理历史数据,但并不意味着任意查询都会更快。跨长时间范围查询仍可能读取多个分区,分区数量、局部索引和维护成本也需要考虑。
时序数据库也是可选方案。选择应基于数据规模、写入方式、查询模式和维护条件,而不是因为“轨迹带时间”就排除其他数据库。
分段加载要保留稳定的顺序
如果按时间和内部标识形成稳定顺序,可以用二者组合设计游标,减少同时间记录翻页时的遗漏和重复。游标还应绑定车辆、过滤条件和授权范围,避免被拿去查询其他对象。
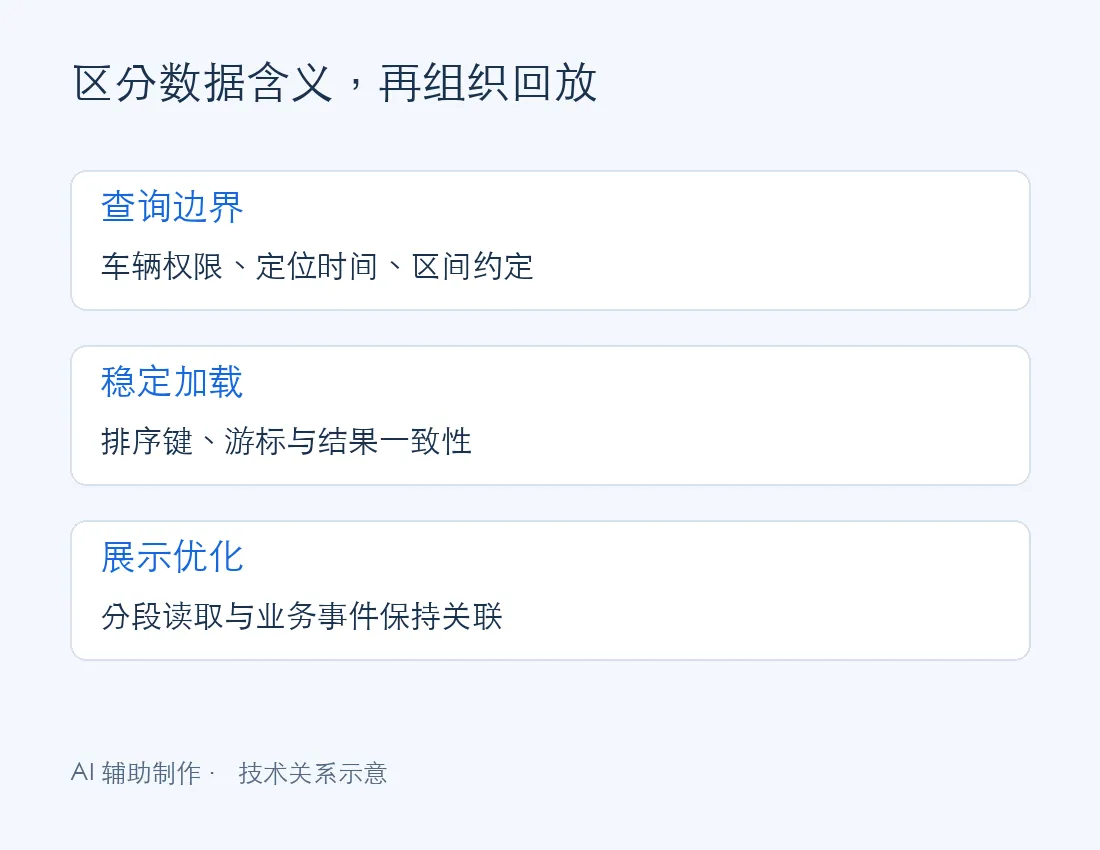
数据含义与处理关系示意。
采用游标不代表查询天然具有快照一致性。加载过程中如果补入一条更早采集的记录,它可能落在已经翻过的区间。
因此,要明确业务采用固定快照、结果版本,还是允许在刷新后查看更新结果。对于仍可能补传的近期区间,不宜暗示第一次加载已经是永久不变的完整历史。
原始记录与绘线数据分别组织
减少返回字段、按段请求和几何抽稀,是不同的优化方式。可以先减少不必要字段,再根据实际点量决定是否简化路线,而不是一开始就删除大量点位。
Douglas–Peucker 等算法按容差简化几何形状,业务上的停留、速度变化与报警仍需另外保护。用于回放的时间索引不应只依赖一条已经简化过的折线。折线简化说明
查询优化之后,核对业务是否仍然一致
除了观察执行计划、扫描记录量和响应体大小,还应比较不同分段大小下,点位覆盖、边界事件和统计结果是否一致。再核对同时间多记录、迟到补传、空区间和跨分区查询。
这些检查需要在实际数据和环境中完成,不能预设固定的性能收益。历史查询的目标,是在权限、时间和记录含义正确的前提下,控制每次读取与渲染的工作量。
