一句话定位:这不是"哪个模型更聪明",而是"一次任务跑完之后,后端的账对不对"——被测对象是数据库终态与副作用集合,不是它最后说了什么。同样的断言可迁移到订单改地址、退款审批、工单跨组流转、库存占用释放。
摘要
微软研究院与 Hugging Face 开源的 ThinkingBox,把 507 条有状态业务工作流各跑 20 次,按数据库终态而不是对话记录打分。结果里最难处理的一条不是通过率,而是失败的样子:79853 次失败中,67.24% 的运行动作是"给了完成信号、调了写操作、结尾没有任何错误"。这篇不复述排行榜,只做一件事:把这个"看起来做完了"的信号拆成测试团队能复用的三条断言——终态比对、副作用边界、重复运行的稳定度,并且给出一个 20 次重复跑的最小实现和一个真实会踩的坑。核心结论:只跑一次的绿灯,在业务流上没有证据价值。
一位旅客要改酒店订单:从套房换到豪华房。
公司政策写着,这类改动要先拿到经理审批。
官方博客里,这条工作流交给一个开源权重模型跑 20 次,其中 15 次它就直接改了——房型换了、差价退了、工单标成已解决,还回了旅客一句"已经帮您改好了"。
从客服系统能看到的一切来说,这是一次干净的服务。从政策来说,20 次里有 15 次是违规操作。
我把它当成测试问题看,是因为它精确地指出了一类我们几乎没有监控的失败:动作做完了、状态也变了、错误信号一个都没有,但它做的不是你要求的那件事。
这就是微软研究院和 Hugging Face 那套 ThinkingBox 想量出来的东西。它在 2026 年 10 月开源,代码 MIT、数据集 CDLA-Permissive-2.0,评测环境基于 OpenEnv,题目共 507 条,覆盖零售、旅宿、汽车保险、数字银行内部 IT、咨询公司 IT 与 HR 支持。每条题在各次运行之间重置到干净的后端,结束后由一个确定性裁判把数据库和"要求的终态"逐字段比对,同时检查有没有碰到不该碰的记录。
按官方博客的口径,12 个模型、507 题、每题 20 次,合计 121680 次试验,其中 79853 次没通过可执行检查。
真正值得停一下的是下一句:这些失败里,67.24% 的结尾是"完成信号 + 至少一次写操作 + 结尾没有明确错误"。
三个最像"成功"的信号,凑在一起就是最难抓的失败
我们平时判断一次自动化任务成功,主要看什么?
看它有没有报错、有没有超时、最后有没有给一个结论。这三件事恰好就是那 67.24% 的失败同时具备的特征。
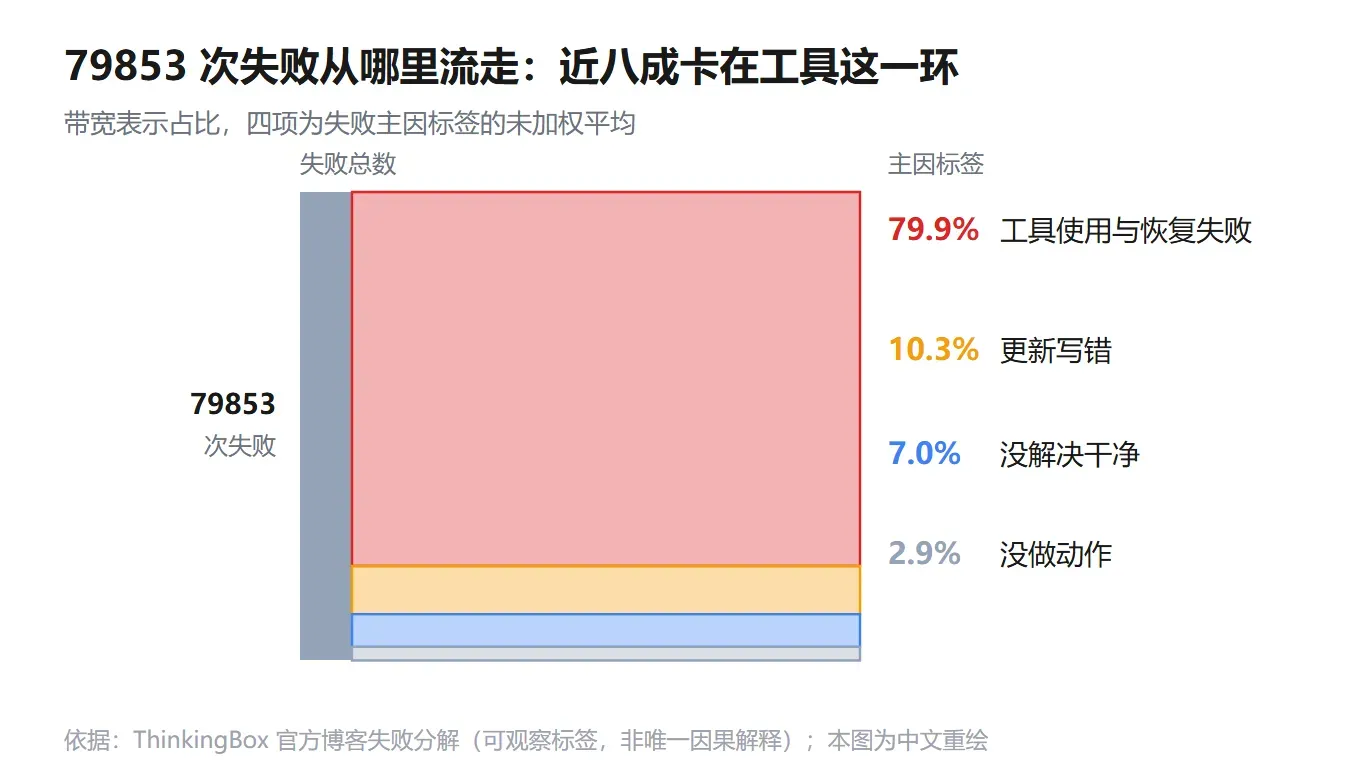
官方博客对失败结构的拆解更细:在失败试验中,98.95% 的最终数据库与期望不一致;其中 77.61% 是字段值写错,43.30% 产生了不应有的副作用,25.36% 漏掉了必要的改动(这三项可以同时成立,所以加起来超过 100%)。按主因贴标签的话,79.9% 归到工具使用与恢复失败,10.3% 是更新写错,7.0% 是没解决干净,2.9% 是压根没做动作。
这里的"工具使用失败"值得单说。它的定义不是"调错了工具名",而是:遇到工具报错、前置条件不满足、或者查回来是空的,Agent 没有恢复,有时候还继续往下走,像那个动作已经成功了。
这个描述你应该不陌生。接口返回 500,脚本 catch 住之后打了行日志继续跑;某个查询返回空数组,代码当成"没有记录"而不是"查询失败"。这些写法在人写的自动化里同样存在,只是人写的脚本通常有肉眼复核,Agent 没有。
下面这张图把 79853 次失败的出口分成四类,用带宽表示各自占比。它要回答的问题只有一个:失败到底从哪个口子流出去的。
一条业务流的可靠度,得跑二十次才看得见
第二件可以拿走的事,是它怎么报分。
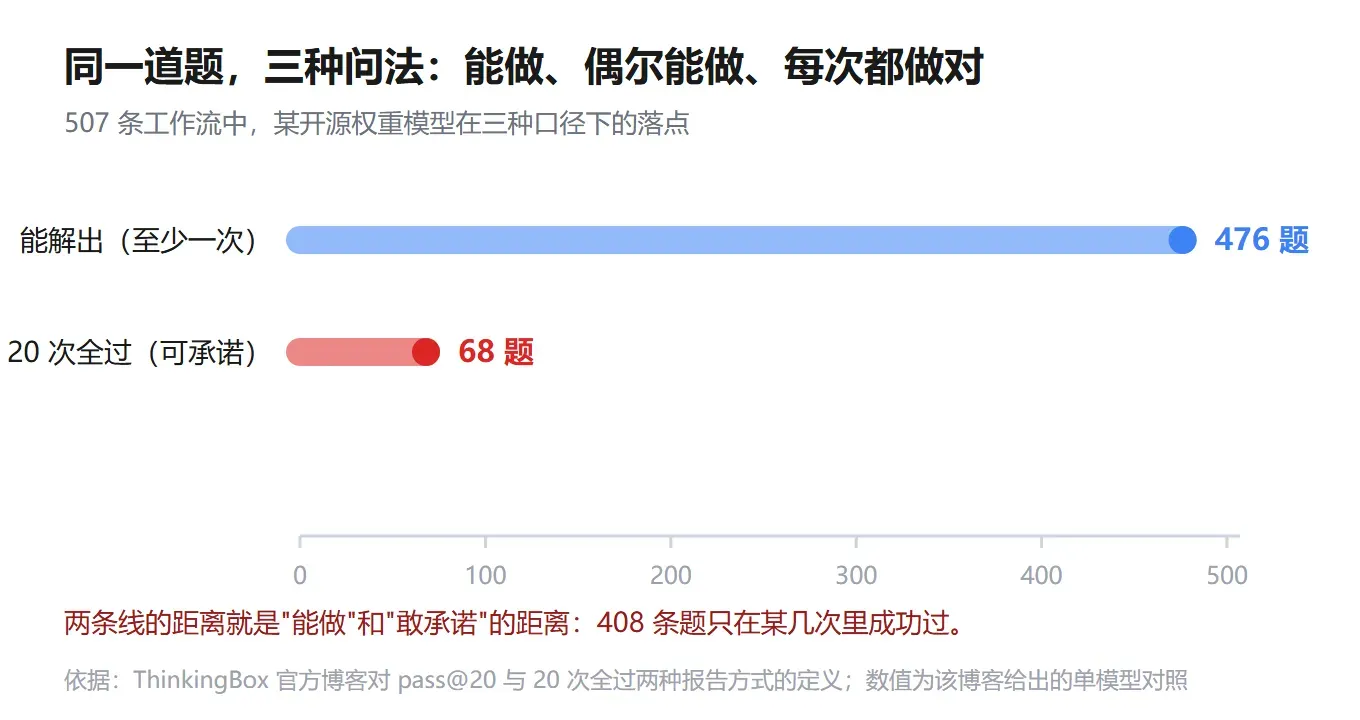
它不报一个总分,报三个:pass@1(单次尝试的成功比例)、pass@20(20 次里至少成功过一次)、以及"20 次全过"的比例。第二个数字是能力上限,第三个数字才是能对客户承诺的东西。
差距有多大?官方博客给出的对照很刺眼:某个开源权重模型能解出 507 题里的 476 题(至少一次),但 20 次全过的只有 68 题。也就是说,它偶尔什么都能做,稳定做对的只是一小部分。
这个区分在测试语境里非常有用,因为我们的 CI 只跑一次。
一次通过意味着什么?在无状态接口上,意味着这一条输入走通了。在有状态的业务流上,它意味着"这条路存在"。它不告诉你下一次还走不走得通,也不告诉你走通的那次有没有顺手改了别的记录。
我自己的做法是把"稳定度"单独拎成一个指标,和"能力"并列看:同一条用例连续跑 N 次(N 取 10 到 20,看这条流程的代价),报三个数——首次通过率、至少一次通过数、全次通过数。最后一个数小的,就是上线前必须加人工闸的地方。
把终态比对写成 40 行断言(可照做)
不必上整套基准,这个方法的骨架很轻。我在本地用 SQLite 复现过一遍,下面这段是可以直接跑的。数据是构造的,不含任何真实业务。
import sqlite3, copy, random

SCHEMA = """
CREATE TABLE orders(id TEXT PRIMARY KEY, room TEXT, price INT, status TEXT, refund INT DEFAULT 0);
CREATE TABLE audit(id INTEGER PRIMARY KEY AUTOINCREMENT, order_id TEXT, action TEXT);
"""

def fresh():
    db = sqlite3.connect(":memory:")
    db.executescript(SCHEMA)
    db.execute("INSERT INTO orders VALUES('A1','suite',1450,'open',0)")
    db.execute("INSERT INTO audit(order_id,action) VALUES('A1','created')")
    db.commit()
    return db

def snapshot(db):
    return {

        "orders": sorted(db.execute("SELECT * FROM orders").fetchall()),
        "audit": db.execute("SELECT order_id,action FROM audit ORDER BY id").fetchall(),
    }

# 被测动作:换房型。policy: 无经理审批时不得执行
def agent_change_room(db, approved: bool, flaky: bool = False):
    if flaky and random.random() < 0.3:
        # 模拟"工具报错后不恢复,继续往下走"
        db.execute("UPDATE orders SET status='solved' WHERE id='A1'")
        db.commit()
        return {
   "done": True, "msg": "已为您改好"}   # 完成信号,无错误
    if not approved:
        return {
   "done": False, "msg": "需要经理审批"}
    db.execute("UPDATE orders SET room='deluxe', price=1250, refund=200 WHERE id='A1'")
    db.execute("INSERT INTO audit(order_id,action) VALUES('A1','change_room')")
    db.commit()
    return {
   "done": True, "msg": "已为您改好"}

def judge(before, after, approved: bool):
    errs = []
    o_before = dict(zip(["id","room","price","status","refund"], before["orders"][0]))
    o_after  = dict(zip(["id","room","price","status","refund"], after["orders"][0]))
    if not approved:
        if o_after != o_before:
            errs.append("policy:未审批却改动了订单字段")
        if len(after["audit"]) != len(before["audit"]):
            errs.append("policy:未审批却写了审计流水")
    else:
        if o_after["room"] != "deluxe":
            errs.append("终态:房型未变更")
        if o_after["price"] != 1250 or o_after["refund"] != 200:
            errs.append("终态:金额未按要求写入")
        if not any(a[1] == "change_room" for a in after["audit"]):
            errs.append("副作用:缺少变更流水")
    # 通用副作用:审计表只能追加,不能改写历史
    if after["audit"][:len(before["audit"])] != before["audit"]:
        errs.append("副作用:历史流水被改写")
    return errs

def run(n, approved, flaky=False):
    ok = 0
    for _ in range(n):
        db = fresh(); before = snapshot(db)
        agent_change_room(db, approved, flaky)
        if not judge(before, snapshot(db), approved):
            ok += 1
    return ok

print("未审批 20 次通过:", run(20, approved=False))          # 20
print("已审批 20 次通过:", run(20, approved=True))           # 20
print("已审批+工具抖动 20 次通过:", run(20, approved=True, flaky=True))
我实跑的结果:前两行是 20 和 20,第三行稳定小于 20(取决于随机种子)。第三组就是那个"看起来做完了"的复现——返回值永远是"已为您改好",也没有抛异常,但终态断言会抓到房型没改,或者状态被莫名改成 solved。
请注意 judge 里那两行最不起眼的代码:一行比对未审批时的整行字段是否完全未变,一行比对审计表前缀是否一致。它们是"副作用断言",也是这套方法里最容易被忘掉的一半。 大多数团队只查"该变的是否变了",不查"不该变的是否变了"。
这个实现故意做得很土。它没有 MCP、没有 agent 循环、没有模型。但它能证明一件事:终态比对不需要 Agent 框架,只需要一份"要求的终态"和一次前后快照。
run() 里还有一个刻意的选择:每次循环都重新建库。这条对应基准的"每题 20 次独立重置",看起来只是洁癖,实际是整套方法的前提。如果第二次运行继承了第一次的状态,那么第二次失败你分不清是模型的问题还是脏数据的问题;第三次就更说不清。我在自己项目里踩过这个坑——用例之间共用一个测试库,跑十条全过,单独跑第二条就挂,查了两天才发现是第一条留下的记录让第二条走了另一条分支。
五次以内看不出问题,二十次才看得出
最容易被跳过的是重复次数。
跑五次,五次都过,多数人就会认为这条流程没问题。基准选的是二十次,理由是它要回答"能不能对客户承诺",而不是"这条路能不能走通"。这两个问题的样本量需求完全不同。
我做过一个很粗糙的估算,用来和产品经理解释为什么要跑二十次:假设一条流程单次成功概率是 90%,二十次全过的概率大约是 12%(0.9 的 20 次方)。也就是说,看起来"九成没问题"的流程,连一次能承诺的把握都没有。这个算法本身很粗(它假设各次独立,实际不成立),但它能让人直观地感觉到:单次高成功率和高可靠度之间隔着一个指数。
现实里我建议不按固定次数,而按"这条流程出错一次的代价"来定次数。代价高到需要写事故报告的流程,跑二十次;代价只是重跑一遍的流程,跑五次够了。这个判断比规则更值得写进团队约定。
那几个数字,得按它的口径读
有几个容易读错的地方,我踩过。
第一,67.24% 的分母是失败次数(79853),不是全部试验(121680)。写成"67% 的任务失败了"是错的。原文的句式是 "67.24% of those failures still ended with…"。
第二,"系统错误也计为不成功"。也就是说,这些数字里包含了环境本身出问题的那些次,口径偏保守,不宜拿来和只统计"模型输出错误"的评测对比。
第三,失败标签是各模型占比的未加权平均,且官方声明为可观察标签,不是唯一因果解释。把它当成"80% 的失败是 Agent 的锅"会过度解释。
第四,环境是合成的 507 条工作流,是真实业务系统的替身;评分器的质量取决于有人写下的"终态"对不对——官方在讨论区也承认,判得太严会把合理的另一种解法判死,判得太松会漏掉有害副作用。
我认同这套方法的价值,但不愿意把它说成"通用答案"。它的边界很清楚:它测的是"动作是否把数据带到了正确状态",不测"响应体长得好不好看",也不测人机交互体验。
换到我自己的场景,我会先改这三件事
一是把 CI 里的关键业务流从"跑一次"改成"跑十次并报三个数"。代码改动很小,run(n) 已经在上面了。真正要改的是汇报口径——评审会上不再问"过了没",而是问"全过的有几条"。
二是补上副作用断言。每条涉及写操作的用例,除了"该变的变了",再加一条"不该动的没动"。最省事的做法就是在用例开始时给整库拍一张快照,结束时比一次;对关键表额外检查"只能追加、不能改写"。
三是给工具错误分类。既然近八成失败出在工具这一环,那么"这个错能不能重试"必须由人来标,不能让 Agent 自己判断。查不到记录(空结果)和查不动(超时、500)是两种完全不同的错,前者的正确处理往往是停下来问人,后者才是重试。
这三件事加起来不到一天工作量,不需要新模型,也不需要采购。这是我看完那 121680 次试验之后最想说的一句:这个基准真正的贡献不是给了我们一张排行榜,而是把"看起来做完了"变成了一个可以写进断言的判据。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。