一句话定位:这不是"DeepSeek 的模型强不强",而是"拿它自己的运行环境给自己打分,这件事本身怎么验"——载体是一套插件化的客户端,对象是"换一个插件,旧结论还在不在"。同样的检查可迁移到 CI Runner 升级后的用例复现、SDK 大版本升级后的契约回归、报表口径调整后的口径对账。
摘要
DeepSeek 在 2026 年 8 月 13 日以 MIT 协议开源了智能体运行框架 DeepSeek Harness,设计原则是"一切皆插件":模型、工具、沙箱、会话、调度、界面全是可替换插件。它的 README 有一句全大写的提醒——会有破坏兼容性的变更;仓库里的 SAFETY.md 更直接:这是实验性的开发者预览软件,未经安全审计,不得视为安全或可用于生产;沙箱"不保证隔离"。本文讲这套设计给测试带来的三个具体问题,以及可以立刻做的最小验证。
README 里有一行全大写的字:THERE WILL BE COMPATIBILITY-BREAKING CHANGES。
这句话出现在 DeepSeek Harness(下称 dsh)的 Developer preview 一节,就在"运行前请先看安全说明"那行下面。一个开源项目把这两句话放在一起,其实已经说清了它的定位:能用,但别指望它稳。
dsh 在 2026 年 8 月 13 日以 MIT 协议开源,定位是"智能体运行框架"——模型是引擎,它负责让引擎在真实环境里调用工具、读写文件、跑命令。设计原则叫"一切皆插件",模型、工具、技能、会话、沙箱、存储、循环、调度、界面全都是可替换插件,连 Agent 循环本身都是普通包。
这个设计对测试的含义,比"又一个 Agent 客户端"要多得多。
它给自己写的那份 SAFETY.md
仓库里的 SAFETY.md 我逐句读了,措辞比常见的免责声明具体:
DeepSeek Harness is experimental developer-preview software. It has not undergone a security audit and must not be treated as secure or production-ready.
后面一段解释原因:这个项目可以执行模型生成的代码和命令、加载第三方插件、访问开放给它的网络、进程、凭据与文件;错误的模型输出、缺陷、配置错误、恶意输入或不可信插件都可能损坏主机、改删文件、泄露数据。
关于沙箱,措辞同样不留余地:
Sandboxing, approval prompts, and permission controls can reduce risk, but they do not guarantee isolation or prevent damage.
最后一句是"不要把 dsh 当作不可信工作负载的唯一安全控制"。
这份文档的价值不在于它承认了风险——几乎所有项目都会承认。它的价值在于把风险拆成了可核对的条目,并且给出了五条使用建议:最小权限、用一次性虚拟机或容器、备份可访问的文件、除非接受风险否则别放敏感凭据、允许运行前检查插件与命令。
这套写法可以直接抄进我们自己的工具评估模板。
第一个问题:拿它测,又拿它打分
dsh 的模型层是插件,适配层覆盖多家提供方,本地 OpenAI 兼容端点也是插件。这套设计让"同一套运行时跑不同模型"变得很轻。
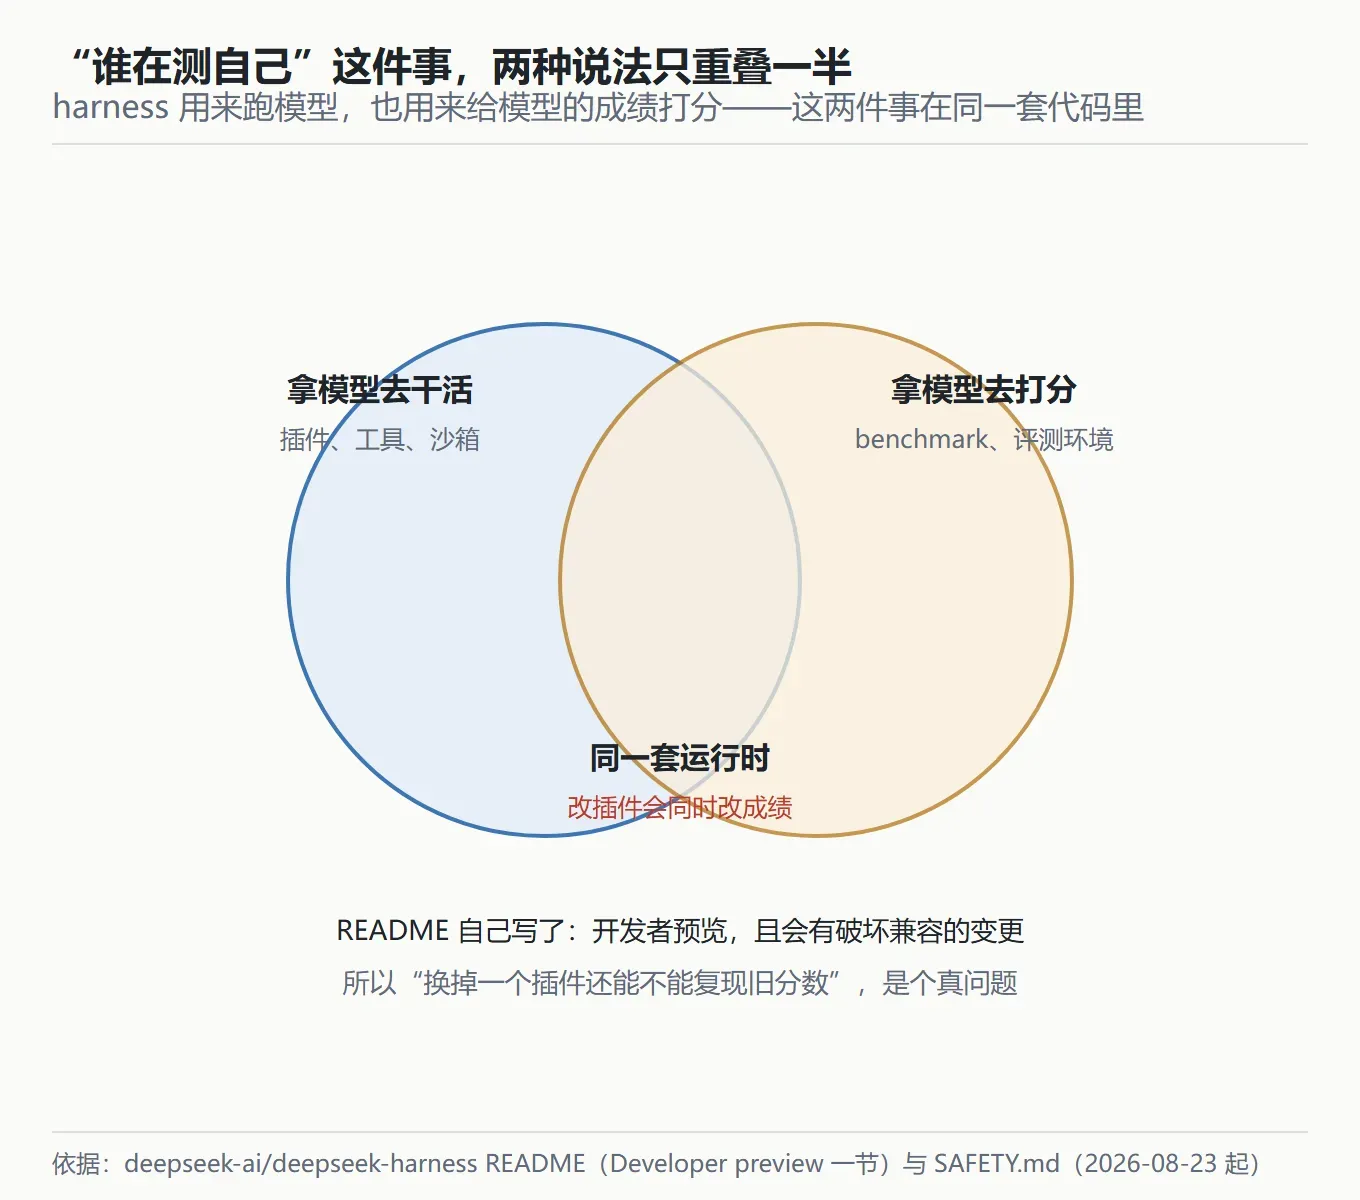
问题随之而来:如果你用它跑模型的 benchmark,而它同时又是你日常干活的客户端,那"打分环境"和"工作环境"是同一个。
这不是 dsh 独有的问题,但插件化把它放大了。一次插件升级、一次默认值调整、一次工具描述改写,都可能让模型的行为走向变化——你测出来的分数变化,可能是模型变了,也可能是壳变了。
系统评测领域有条老规矩:被测对象与测试载体要尽量分离。放到这里,最小做法是给评测单独一份 profile(配置组装),锁住版本、锁住插件清单,只换模型层。
第二个问题:兼容性变更会连带改掉断言
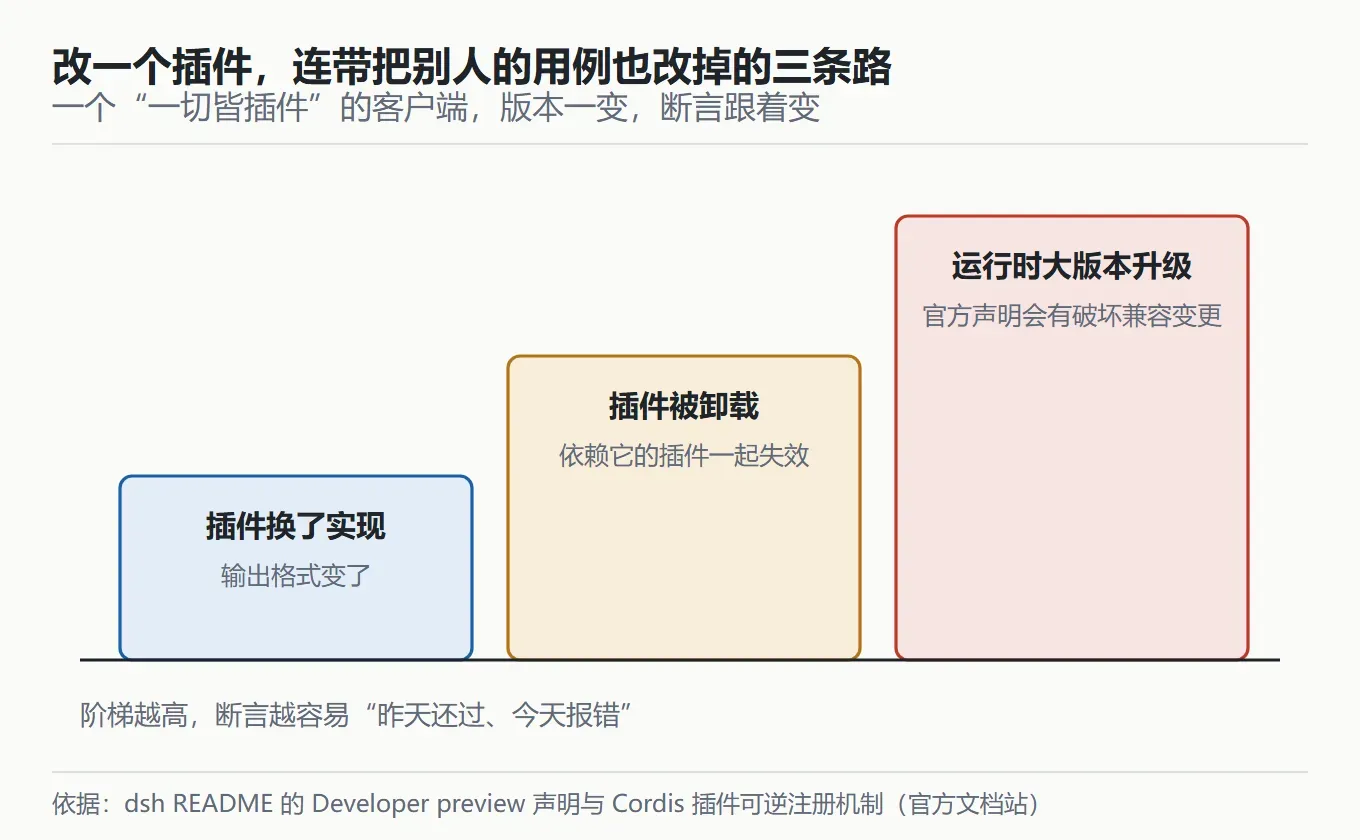
dsh 的插件机制建立在 Cordis 上,官方文档的说法是:每个注册都是运行时可逆的副作用,插件卸载时这些副作用会被撤销;上下文变化会依据组件声明的依赖触发激活与停用。
这个机制很漂亮,对测试的影响也很直接:一个插件的卸载,会连带另一个插件的依赖失效。如果你的用例断言了"某工具存在"或"某输出格式固定",一次插件调整就能让它变红——而这不是 bug,是设计。
所以断言要分层写:断言业务结果(订单状态对不对)比断言工具名与输出格式更耐久。这条原则在普通自动化里也成立,只是这里的变化频率更高。
README 那句全大写的提醒,其实是在提前告诉你:不要把断言挂在版本上。想锁住,就锁版本号,并且接受它锁住的是"当时的行为"而不是"当时的结果"。
第三个问题:沙箱是插件,所以它也能被换掉
本节不另配图:要说的只有"沙箱实现可替换"这一层,用文字交代更快,画成图会重复图一已经表达过的相交关系。
上面那句是 SAFETY.md 里最硬的一句的反面:沙箱、审批提示、权限控制"可以降低风险,但不保证隔离"。
放在插件架构里读,这句话有两层含义。一是沙箱的实现本身是一个插件,可以替换,也可以配置得更宽;二是即便限制被执行,也保护不了"项目被允许访问的那些资源"——这是权限设计的固有限制,不是实现缺陷。
对测试的直接含义:你要测的不是"沙箱开没开",而是"开了之后它能碰到什么"。这两件事在检查表上经常被合并成一条,实际差别很大。
可行的做法是给沙箱做一份"可达清单":网络(能不能出网、能出到哪)、文件(能读哪些目录、能写哪些)、凭据(环境变量里有什么)、进程(能不能起子进程)。四栏,每栏写实测结果,而不是写配置意图。
可以立刻做的三件最小验证
第一,版本钉死。把运行时版本、插件清单、模型 id 全部钉在评测配置里,独立于日常使用的那份配置。这一条能挡掉大部分"分数抖动其实是壳变了"。
第二,可达清单。按上面四栏做一次实测,得出"这个环境里它能碰到什么",而不是"我们以为它碰不到什么"。
第三,断言分层。把现有用例分成两层:业务结果层(必须稳定)与交互细节层(允许随插件变化)。第二层的失败要能自动归到"环境变化"而不是"缺陷"。
三个问题之外,还有一处容易被忽略的采样偏差
dsh 的会话是可追溯的:官方文档说,模型看到的内容都会写进一份只追加的会话日志——系统提示、思维链、工具调用与结果、子 Agent 派发、每一次上下文注入,都能在轨迹视图里按来源查看。
对测试来说这是好事:可追溯意味着可复盘。但它也带来一种错觉——日志里有记录,不等于记录是全的。
它的抽样粒度是"会话",不是"任务"。一次任务如果被拆成三个会话,失败发生在第二个会话的边界上,日志会完整记录三份,但没有任何一处记录"这三份本该一起交付"。
所以用这类工具跑评测时,要给评测集定义交付单元:一次任务对应几个会话、以哪个会话的结束为判定点、会话之间允许有没有人工干预。这三条不写清楚,复现会变得很难——你会发现同一份配置跑两次,结果不一致,却没处查。
与"自建壳"的对比
团队里常见的问题是:要不要自己写一个 Agent 壳。dsh 这类项目的存在,给出了第三种答案——用现成的壳,但把关键层替换成自己实现的插件。
这个方案的吸引力在于成本:省掉了一整套工具调用、会话管理、权限控制的轮子。风险也清楚:壳的内核演进不受你控制,而且官方明写了会有破坏兼容的变更。
我倾向于这样取舍:壳用现成的,评测基线全部自建。基线一旦自建,壳升级带来的漂移就能被自己的用例捕捉到,而不是等到业务侧发现行为变了。
我保留的一点疑问
dsh 的定位是"Agent 时代的操作系统",插件市场正在筹备。这个方向能不能成,我不做判断——从测试角度,我只关心一件事:当几乎所有能力都变成第三方插件时,"可信基线"由谁来定。
SAFETY.md 给了五条使用建议,其中一条是"允许运行前检查插件、配置和拟执行命令"。这句话在单机使用时可执行,在团队流水线里几乎不可执行——没有人会逐条读每个插件。
所以团队落地时,真正的门槛不是技术,而是这套检查的组织方式:谁维护白名单、谁负责升级、出了问题怎么回滚。这三件事没有官方答案,得自己写。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。