
150+直供模型怎么选:qwen、wan、glm、deepseek,按任务选才不浪费额度
一、前言
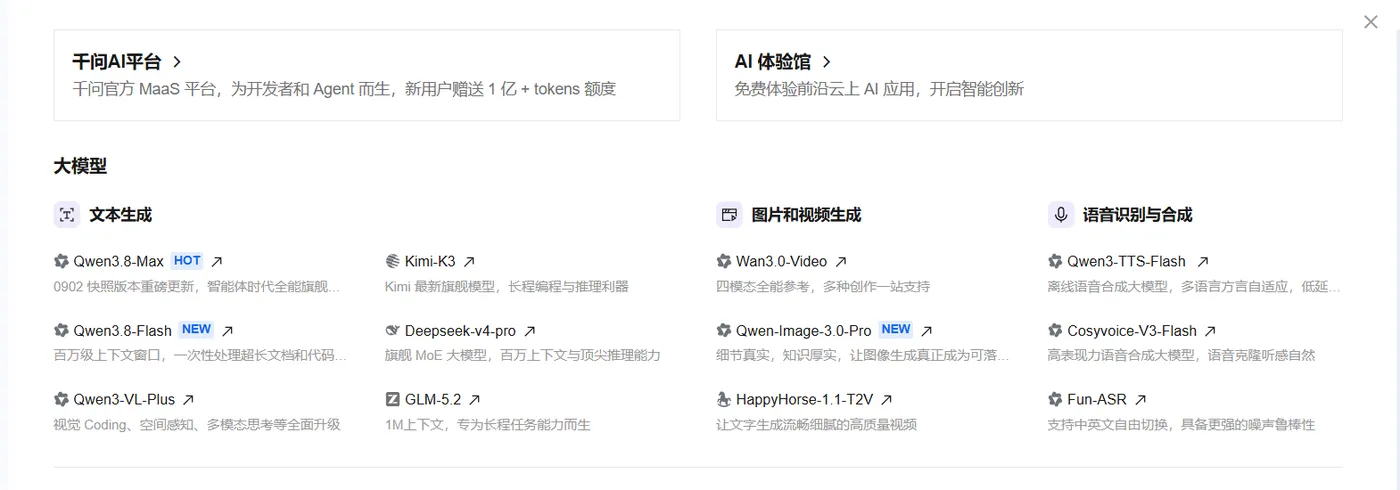
打开百炼模型广场,150 多个模型一字排开,很多开发者的第一反应是懵的:文本模型十几个,图像视频又是一堆,到底该用哪个?选错模型的代价是双倍的——效果不达标,还得重跑一遍烧掉额度。本文按任务类型把双11期间常被提及的几大模型家族(qwen、wan、glm、deepseek)拆开讲清楚,帮你建立一条"先看任务、再选模型"的决策链。
二、按任务选模型:一张决策表
文本对话与 Agent 工具调用 → qwen 系列。 通义千问是阿里自研主力,混合推理支持快思考/慢思考切换,工具调用(function calling)能力成熟。做智能客服、Agent 应用、RAG 问答,qwen 系列是默认起点,生态资料也最全。
数学、代码、复杂推理 → deepseek 系列。 DeepSeek 以推理见长,在数学、代码场景表现出色。写代码辅助、数据分析脚本、需要"慢思考"的深度推理任务,切到 deepseek 试试,往往比通用模型更稳。
视频生成 → wan(万相)系列。 文生视频、图生视频任务认准万相,支持多分辨率与多时长档位。注意视频生成的 token 消耗远高于文本,测试阶段先用低档位跑通再上高清。
长文本与中文创作 → glm 系列。 GLM 在长文本理解与中文写作上口碑不错,报告生成、文案创作、长文档摘要类任务可以作为 qwen 的补充选项。
其他垂直模型:happyhorse 等应用向模型各有侧重,具体清单可在模型广场按分类筛选。
三、三个实操建议
- 同一任务至少对比两个模型:写一个固定的测试提示词,分别跑 qwen 和 deepseek,对比输出质量与 token 消耗,十分钟就能得出适合自己业务的结论。
- 关注模型版本号:同名模型有不同版本(如 qwen 的 Plus/Max、deepseek 的不同尺寸),版本间能力和价格差异明显,调用时明确指定版本。
- 用免费额度做选型:百炼新用户 100 万免费 tokens,正好用来跑选型测试,不用花一分钱。
四、成本视角:怎么组合最省
双11期间 Token Plan 套餐覆盖 qwen、wan、happyhorse、glm、deepseek 等 150+ 阿里直供模型,套餐额度在不同模型间通享。合理的省钱组合是:主力日常任务用性价比高的通用模型,关键任务才调用推理更强的模型。同一个 Agent 里完全可以混搭:默认走 qwen-plus 处理对话,遇到复杂推理再路由到 deepseek,成本能压下去一截。
五、常见问题
Q:模型可以随时换吗?
A:可以。百炼的 API 接口统一,切换模型通常只需要改模型名称参数,业务代码不动。
Q:哪个模型最强?
A:没有"最强",只有"最适合"。榜单成绩和实际业务效果经常不一致,用自己的测试集说话。
Q:视频模型一次生成消耗多少?
A:按视频时长和分辨率计费,具体消耗可在模型详情页和调用日志中查看,建议先用最低档试跑。
六、总结
150+ 模型看着吓人,但决策链其实很短:看任务类型 → 圈定家族 → 跑对比测试 → 定主力模型。文本对话选 qwen,深度推理选 deepseek,视频生成选 wan,长文创作看 glm。免费额度就是用来做这件事的,别等到付费后才发现选错了主力。
活动直达地址:阿里云千问AI双11主会场|百炼模型服务平台
打开链接后登录阿里云账号,在模型广场按任务分类筛选模型,免费额度与套餐价格以页面实时展示为准。
