摘要:很多团队以为实时 BI 就是在仪表板上打开自动刷新。但真正决定数据是否“实时”的,是业务系统到 BI 页面之间的整条链路。本文把实时 BI 拆成数据产生、采集、传输、存储、查询和页面刷新六个环节,分析每一环对时效的影响,并整理定时刷新、增量同步、事件触发、流式数据和页面自动刷新五种更新方式的适用场景,最后说明 Wyn 在这条链路中承担的角色。
很多人对实时 BI 的理解,是打开仪表板后勾选一个“自动刷新”。
但试过的人都知道,页面确实在转圈刷新,数字却纹丝不动。原因很简单:页面刷新只是整条链路的最末端,如果前面的数据还没有更新,后面刷得再勤,看到的也只是同一批旧数据。
实时 BI 从来不是某一个开关,而是一条从业务系统一直延伸到用户屏幕的完整链路。这篇把它拆开看。
一、实时 BI 的完整链路是什么?
一条完整的数据链路,大致是这个顺序:
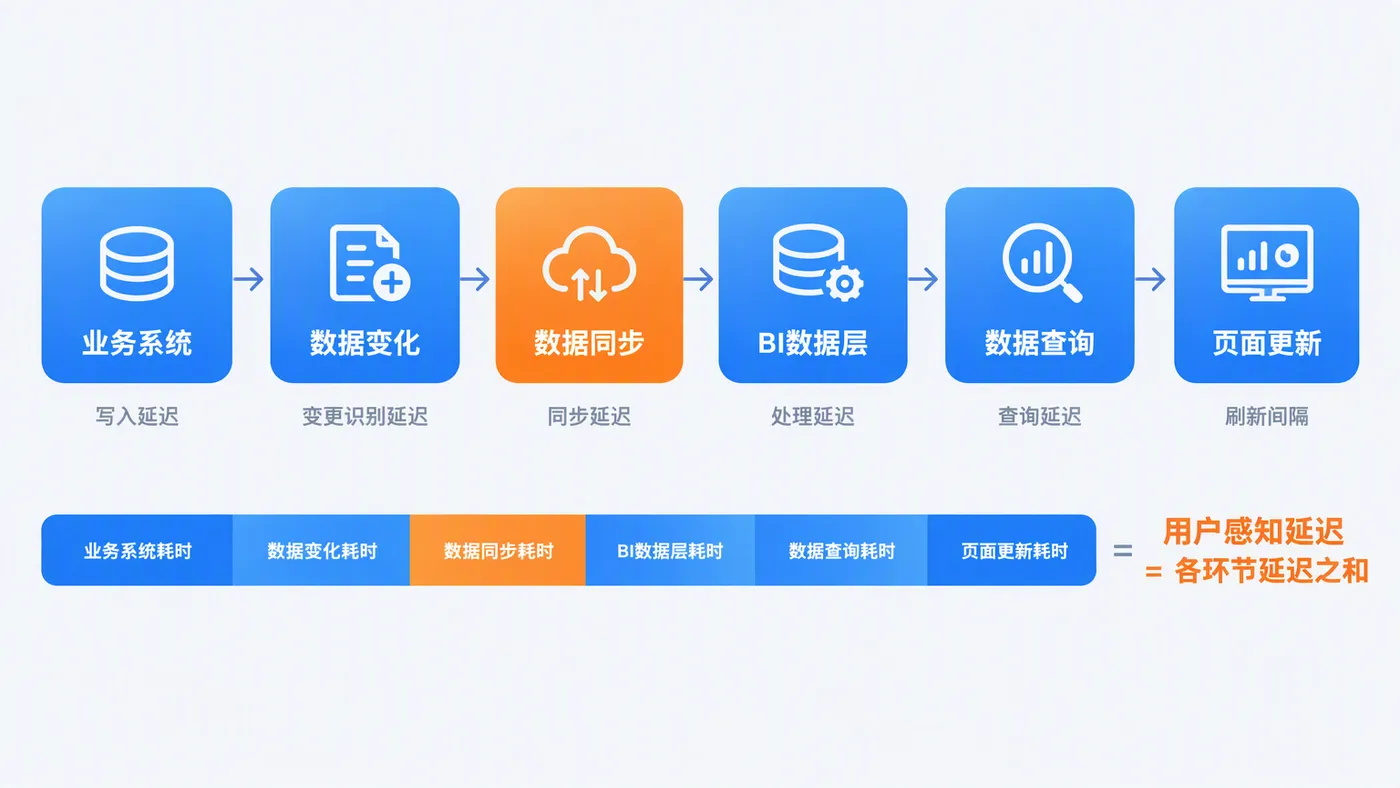
业务系统 → 数据变化 → 数据同步 → BI 数据层 → 查询 → 页面更新
业务系统产生新数据,数据同步把变化带到 BI 能访问的数据层,BI 再通过查询把结果组织成报表或仪表板,最后由页面呈现给用户。
这条链路上,任何一环慢下来,用户最终看到的数据就会慢。业务系统半小时才写入一次,后面的链路再快也没用;数据同步任务一小时跑一次,页面每秒刷新也读不到新数据。
所以判断一套 BI 是否“实时”,不能只看页面,而要顺着链路从后往前问:这个数字是什么时候产生、什么时候被同步、什么时候进入数据层、什么时候被查询出来的?
二、实时 BI 中有哪些关键环节?
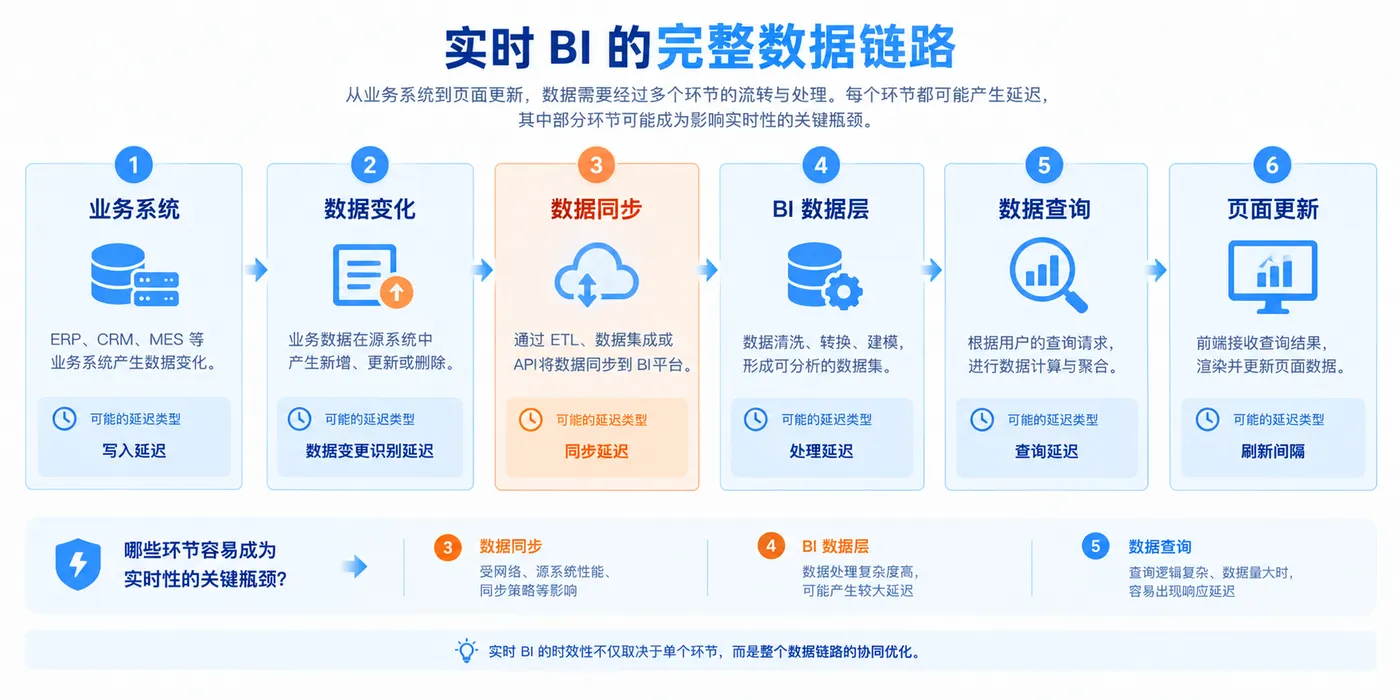
把链路进一步拆开,可以分成六个关键环节,每个环节都在决定数据的时效。
数据产生。 业务系统什么时候写下这条数据,是实时性的起点。如果订单在系统里是批量入账,或者设备数据本来就是每分钟上报一次,那么再快的 BI 也只能等到数据出现。
数据采集。 数据是全量拉取,还是只取新增和变更部分?采集方式直接决定了每次同步要处理多大数据量,也决定了同步任务要跑多久。
数据传输。 数据从业务系统进入分析链路,中间可能经过接口、消息队列或同步任务。这一段最容易出现积压,尤其在业务高峰期。
数据存储。 BI 查询的数据究竟来自业务库、分析库、缓存层,还是已经整理好的数据集,会直接影响查询速度和系统稳定性。
数据查询。 查询性能、并发压力、聚合复杂度,决定了用户点开页面后要等多久才能看到结果。
页面刷新。 这是用户唯一直接感知的一环,但也是最容易背锅的一环。页面刷新只负责取回数据,不负责让数据变新。
三、每一环对实时性的影响是什么?
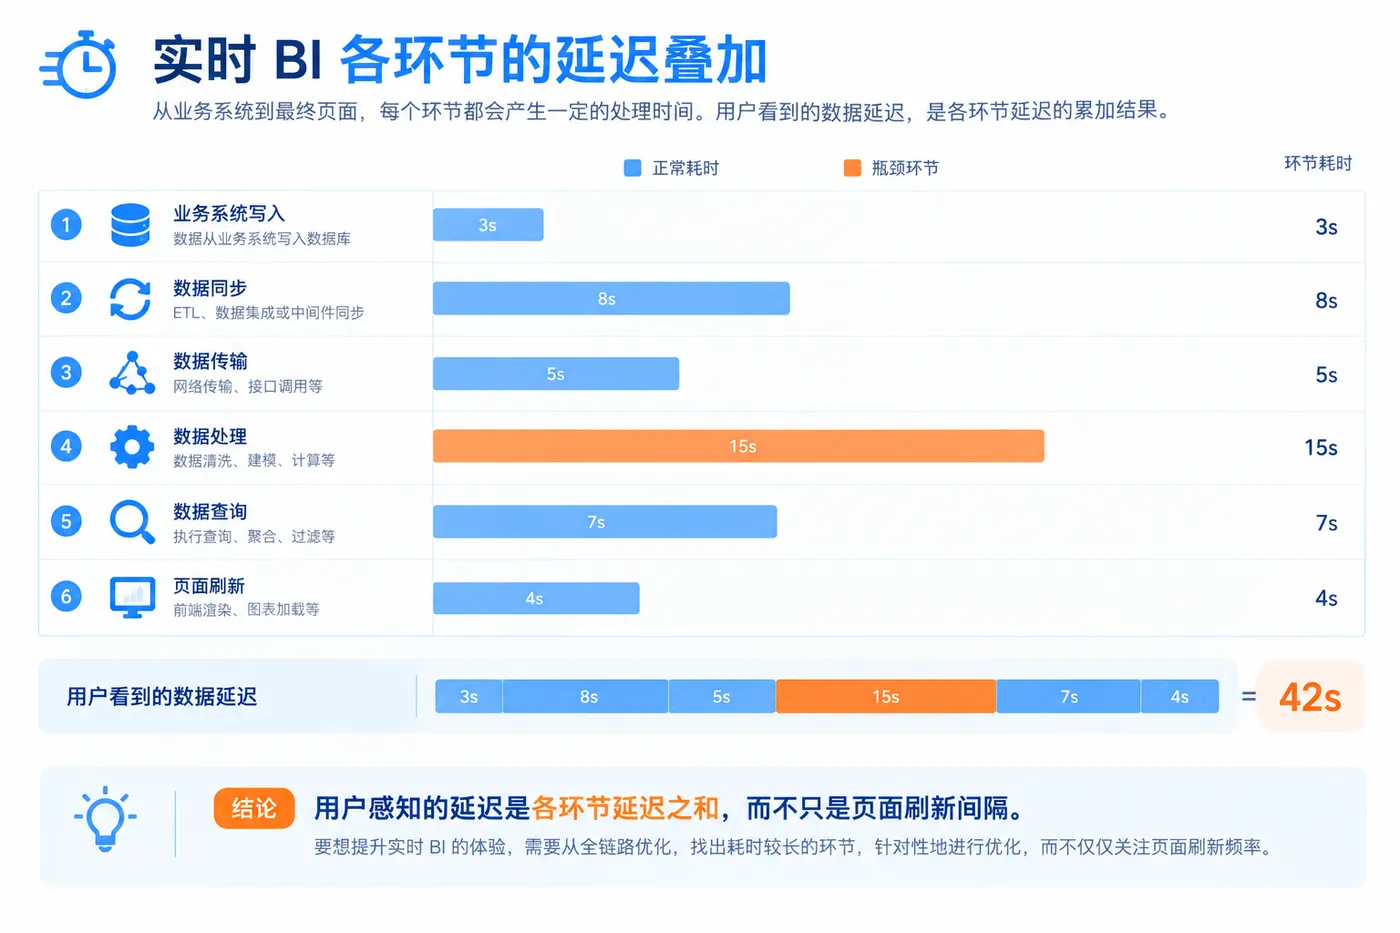
真正需要建立的认知是:用户看到的数据延迟,是各环节延迟叠加的结果,而不是某一环单独决定的。
- 业务系统写入慢,用户看到的就永远是滞后的数据;
- 采集和同步只跑全量、频率又低,数据进入 BI 的时间就会明显落后;
- 传输环节出现积压,数据可能卡在队列里迟迟不到;
- 数据层如果直接压在业务库上,查询会变慢,甚至影响业务系统本身;
- 页面刷新间隔再短,也只能在已有数据的基础上重复查询。
这里有一个经常被忽略的事实:大多数“实时 BI 不实时”的问题,并不出在 BI 页面,而是出在链路的前半段。 页面刷新频率是最容易被调整的参数,也是最不容易解决问题的那一个。
反过来说,如果前面的环节已经做到位,页面刷新的调整空间其实很小——数据层一旦更新,下一次刷新自然就能拿到新结果。
四、常见的实时更新方式
理解了链路,再看具体的更新方式就清楚了。它们其实作用在链路的不同位置。
| 更新方式 | 作用位置 | 适用场景 | 主要代价 |
|---|---|---|---|
| 定时刷新 | 数据同步 + 页面 | 小时级、分钟级分析 | 频率越高,系统压力越大 |
| 增量同步 | 数据同步 | 数据量大、只需要变化部分 | 需要可靠的增量标识 |
| 事件触发 | 数据同步 | 关键状态变化时及时同步 | 逻辑复杂,依赖业务事件 |
| 流式数据 | 数据产生到存储 | 数据持续产生、时效要求高 | 链路和运维成本高 |
| 页面自动刷新 | 页面 | 展示最新查询结果 | 不解决数据本身的滞后 |
定时刷新实现最简单,适合大多数小时级和分钟级场景,代价是刷新频率越高,同步和查询压力越大。
增量同步只处理新增和变更的数据,是数据量较大时的常规选择,前提是能找到可靠的增量标识,比如更新时间或自增主键。
事件触发在关键业务动作发生时立刻同步,适合订单状态、库存变动这类不能等的场景,但对业务事件的依赖更强。
流式数据面向数据持续产生、时效要求高的场景,能把数据产生到存储这一段压缩得更短,代价是整条链路的搭建和运维成本明显上升。
页面自动刷新作用在最后一环,它能让用户看到最新的查询结果,但如果数据层没有更新,刷新只是重复读取同一批数据。
选择哪一种,取决于延迟到底卡在哪一环,而不是哪种听起来更先进。
五、实时 BI 设计时需要注意什么?
把链路和更新方式都想清楚之后,落地时还有几个容易踩坑的地方。
数据一致性。 刷新频率高不等于数据可信。多表关联、多系统同步、增量更新过程中,如果口径和时序没有处理好,用户可能看到互相矛盾的指标。刷新越快,暴露问题的频率也越高。
刷新频率。 频率应该匹配业务决策节奏。经营分析页面的用户不会每分钟做一次决策,把所有页面都设成高频刷新,只会放大系统负担。
查询压力。 高频刷新会直接转化为高频查询,尤其是大屏和管理驾驶舱这类多人同时访问的场景。刷新频率看似是一个页面参数,实际上会传导到整个查询链路。
数据延迟提示。 建议在页面上明确展示数据更新时间。用户知道当前看到的是几点几分的数据,比默认数据是实时的更让人放心,也能避免误判。
失败重试。 同步失败、接口超时、查询异常都要有重试和告警机制。实时链路一旦没有可观测的重试策略,故障往往是在用户发现数据不对时才暴露出来。
六、Wyn 实时分析场景如何设计?
把前面的链路逻辑落到具体工具上,Wyn商业智能 的位置比较清楚:它主要负责数据接入、分析展示,以及发现问题后的监控和预警,而不是把所有业务数据都变成秒级实时。
在数据接入和分析准备层面,不同更新频率的数据需要不同的组织方式。经营分析类数据更关注完整性和口径统一,可以按周期更新;运营跟踪类数据更关注状态变化,需要更短的更新周期。数据准备策略和业务场景匹配,比单纯提高刷新频率更有效。
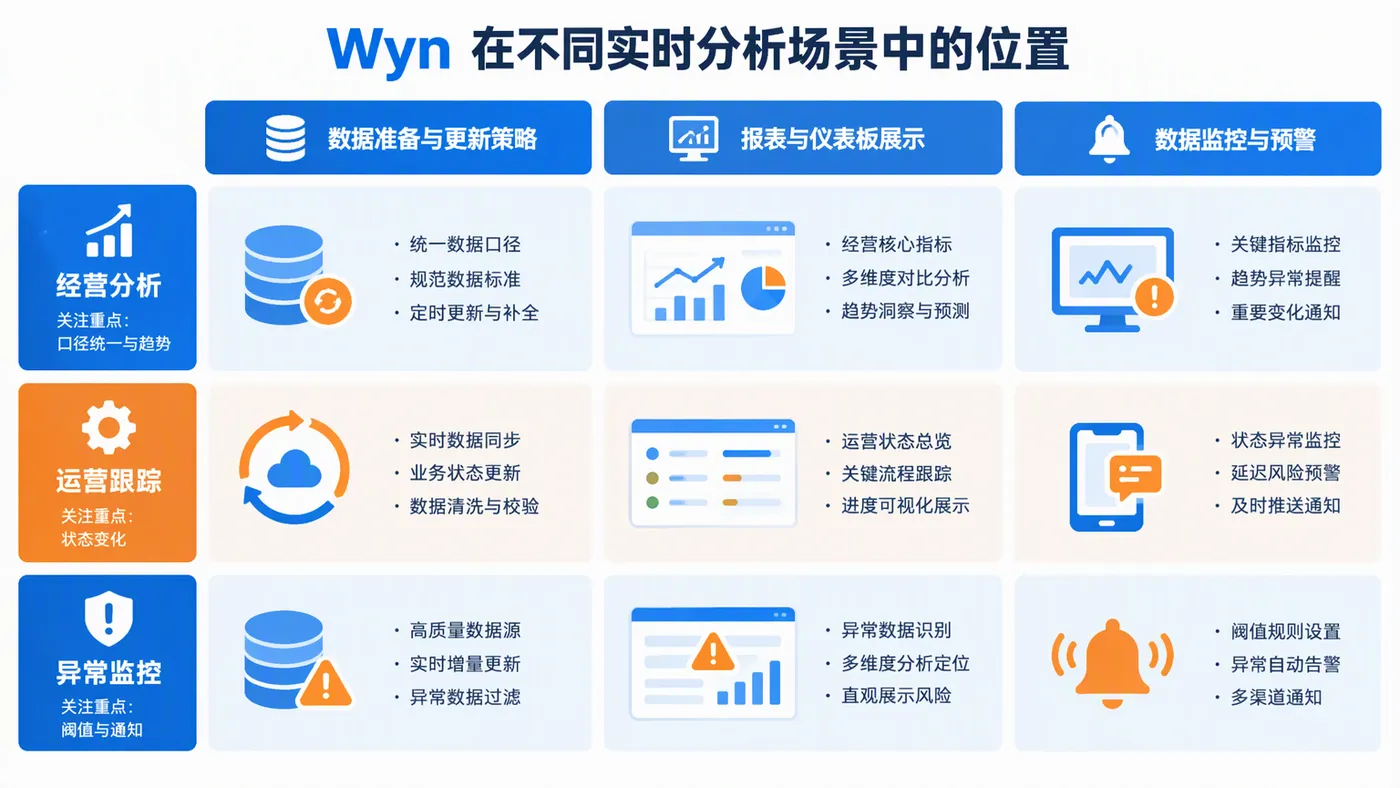
在报表和仪表板层面,不同业务可以设计不同的展示方式。财务和经营分析页面重点展示趋势、对比和汇总;库存、订单和生产类仪表板更关注当前状态和变化趋势。页面上的数据更新时间提示,能让用户清楚判断当前数据的时效。
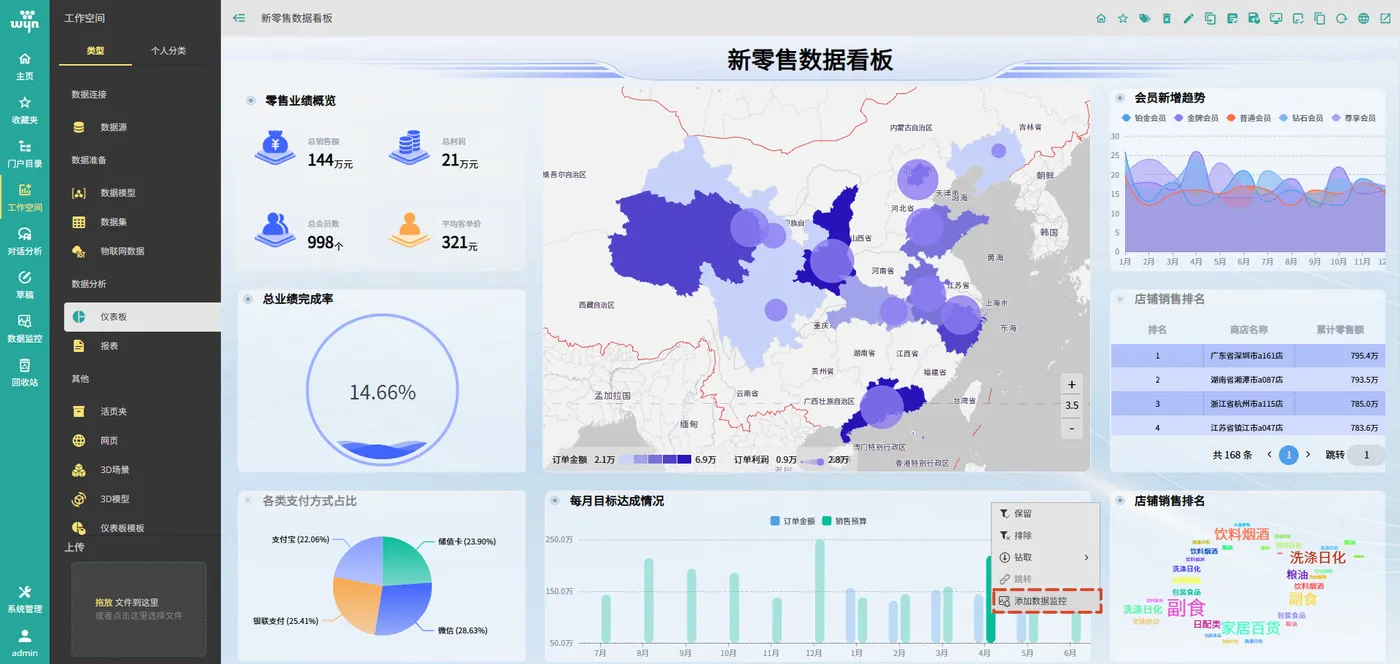
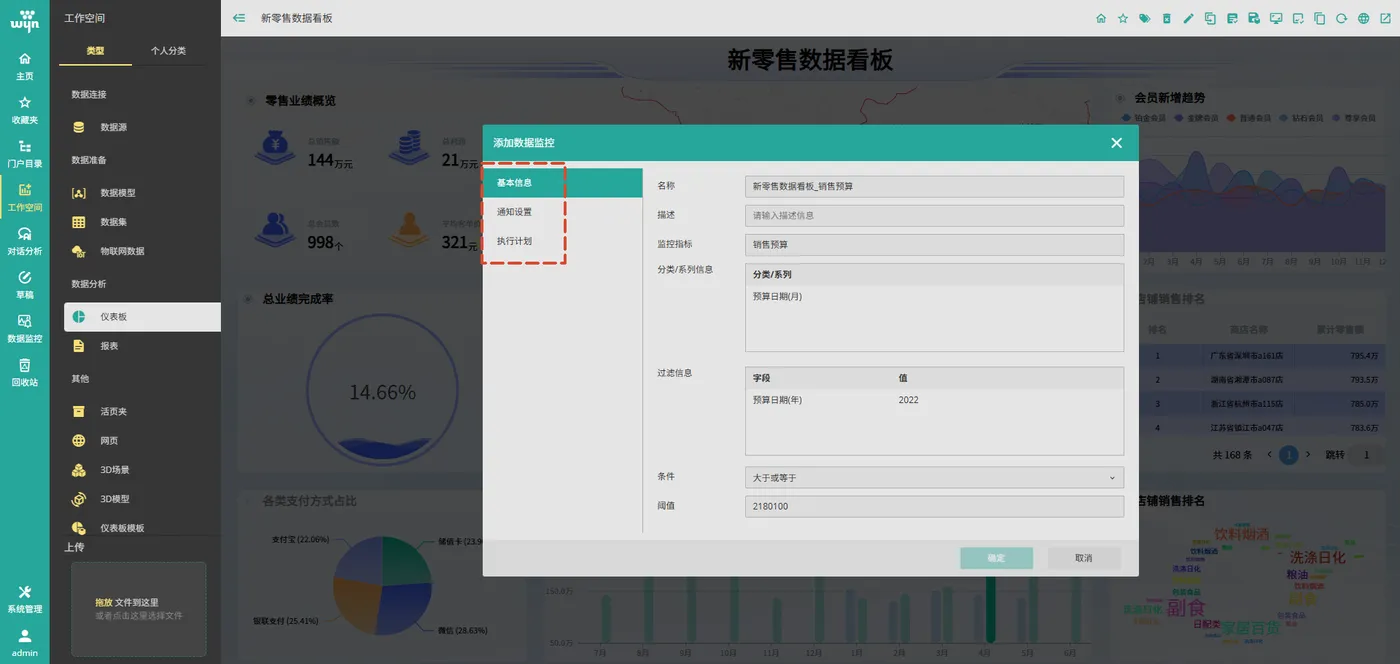
对于需要持续关注的指标,可以结合 Wyn 的数据监控能力,配置执行计划、指标阈值和预警通知。当监控指标达到设定条件时,系统会围绕异常发现和提醒进行处理,把 BI 从“用户主动打开页面查数据”,延伸到“系统主动发现问题并通知相关人员”。这条路径解决的不是秒级刷新,而是让关键指标的变化不至于被忽略。
结语:实时 BI 是一条链路,不是一个开关
回头看,实时 BI 的实现并不神秘,它只是把一条链路从头到尾梳理清楚:数据在哪里产生,怎么进入分析系统,怎么被查询出来,最后怎么呈现给用户。
真正需要判断的是延迟卡在哪一环。卡在业务系统,就去改采集方式;卡在同步,就考虑增量或事件触发;卡在查询,就去优化数据层和查询策略;只有前面的环节都到位了,页面刷新才真正有意义。
下次再有人问“BI 能不能实时”,不妨先反问一句:你希望看到的这个数字,从产生到显示,最多能接受多长时间的延迟?
关键词:实时 BI / 数据链路 / 增量同步 / 数据刷新 / 数据监控 / 仪表板 / Wyn BI