
同一个模型,接进不同的 Agent,做事能力可能差出一截。
《State of AI Report 2026》引用的一组编码实验里,模型权重保持不变,仅调整外围执行环境,GLM-5.1 的任务成绩就从 52.5% 变成了 65.5%。
提高了 13 个百分点。准备给 Agent 换模型之前,这组结果值得仔细看看。
模型之外,还有一整套工作条件
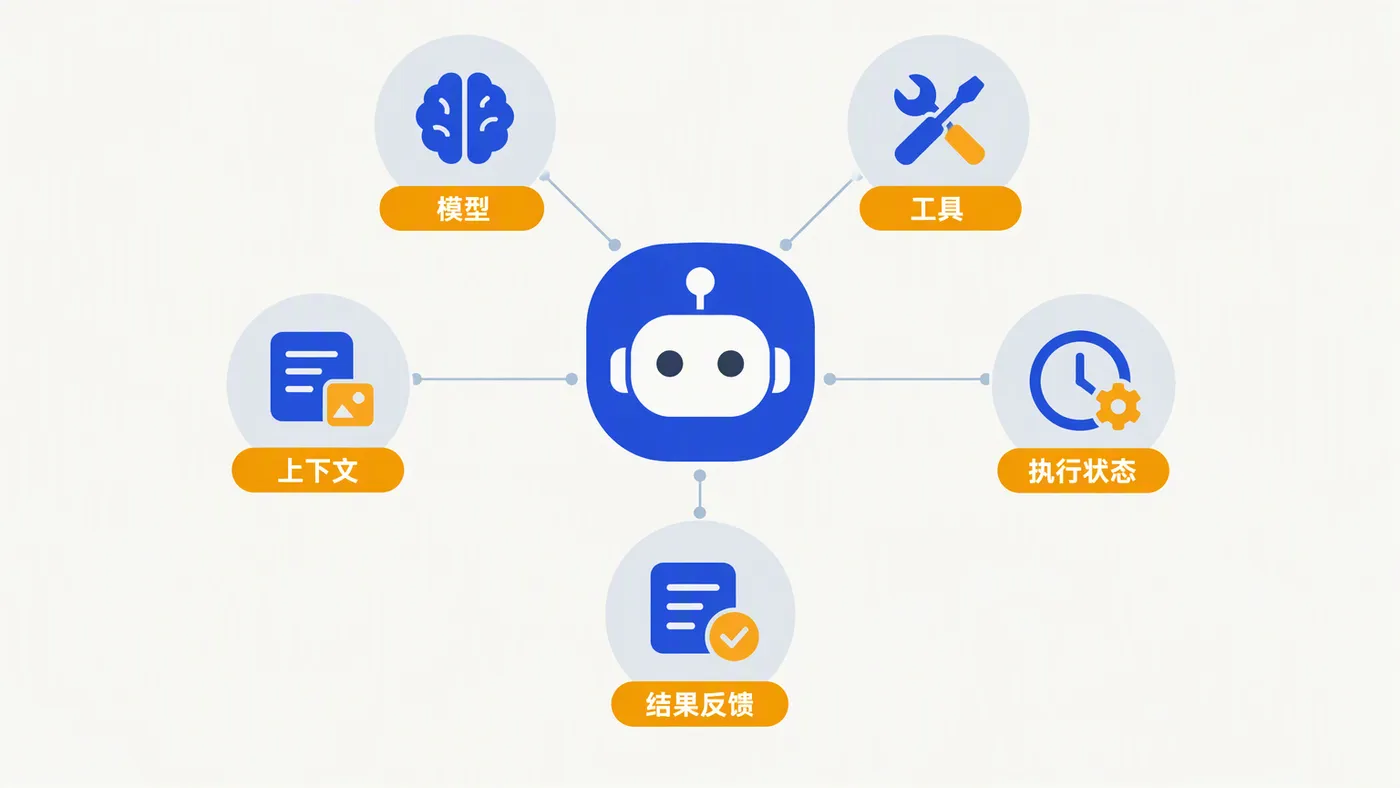
报告把这部分称为 harness。可以把它理解为围绕模型搭建的执行环境:模型能调用什么工具,能看到哪些上下文,任务走到哪里,执行失败后怎样继续。
聊天框里的问题往往止于一次回答。真正交给 Agent 的工作可能要持续很久:检查代码库,定位问题,修改文件,运行测试,再根据错误提示调整。中间任何一个环节断了,前面说得再像那么回事,任务也交不出去。
说白了,模型需要拿到能干活的条件。
假设要修复一个订单系统的计算错误。模型只有一段报错截图,就得猜代码结构;允许读项目文件后,它才有机会追到计算逻辑;再给它测试环境,它可以检查改动是否破坏其他功能。这里每多一项条件,改变的都是它能够执行和验证的动作。
当然,工具越多,结果未必越好。过时的接口说明、互相矛盾的规则、不加筛选的历史记录,都可能让模型走偏。上下文要有来源,也要有取舍。
13 个百分点,应该怎样理解
报告第 7 页介绍的受控测试,用 3 个模型搭配 3 种 harness,在 100 个 SWE-bench Verified 任务上比较表现。其中,GLM-5.1 从 minimal harness 的 52.5% 提升到 full harness 的 65.5%。
有意思的是,模型没换,结果变了。
这说明,比较 Agent 时需要交代外围执行条件。如果两个产品给模型提供的工具、上下文和反馈机制不同,仅把模型名字写在一张表里,解释不了最终差距。选型测试也需要尽量固定条件,或者明确列出哪些条件被调整了。
但这项实验的边界同样清楚。它针对指定的编码任务集,不能被改写成“所有企业接入 harness 都能提升 13 个百分点”,更不能折算成业务效率或成本收益。完整 harness 中哪些设计贡献了多少,还需要结合原始实验设置分析;企业自己的订单审核、合同检查与知识检索,也得用各自的任务重新测。
其实,这给企业提供了一个更具体的排查方向:结果不好时,先沿着执行记录看一遍,模型是不是根本没拿到必要信息。
如果它查错了版本,就补版本标识;如果测试没跑起来,就查环境;如果修改后没有验证步骤,就补成功判定。换模型仍然可能有用,只是这些问题也需要被看见。
任务分流,也会影响成绩
同一套执行方法不一定适合每项工作。
报告第 8 页介绍了另一类研究:先针对不同开发任务形成专业化 harness,再为新问题选择分支。在固定 Gemini 3 Flash 的数学测试中,路由后的成绩为 62%,Meta-Harness 基线为 46%;但两个分支潜在的合计覆盖率为 67%。
路由仍然丢掉了一部分可解任务。
这个差距很有启发。拥有不同工具与执行方法之后,还要判断当前任务适合哪一套。分错了,后面的能力就用不上。
放到企业场景,可以先做一层朴素的任务分类。查制度的请求走检索,批量核对数据的请求走计算与校验,需要改变业务状态的请求进入有权限控制的操作流程。这里是根据研究作出的工程建议,具体分法仍要用实际任务验证。
问题来了:任务描述含糊时,该交给谁?
可以让系统追问,也可以转交人工。未经确认就选一个能写入数据的分支,后续再补救通常更麻烦。路由设计里应当留出“无法判断”的出口。
长材料需要能查、能拆、能回溯
还有一种常见的卡点:资料都给了,Agent 却漏掉关键内容。
报告第 9 页介绍 Recursive Language Models 的思路。长输入保存在代码工作区里,模型按需要检查和切分材料,把部分内容交给后续模型调用处理,再组合中间结果。递归调用时,模型权重保持固定。
这为长文档任务提供了一种组织方法。不过,报告也提醒,效果依赖可复用的分解策略,递归调用并不总是更便宜。把材料拆开之后,如果遗漏跨章节约束,最终回答依然可能出错。
假设 Agent 需要检查一份有多个附件的采购材料,正文写着交付日期,补充协议修改了验收条件,附件又规定了例外情形。拆分时必须保留文件关系,让最终结论能回到具体条款。只拿到各段摘要,可能连规则冲突发生在哪里都找不到。
说实话,“读过全部文件”很难成为验收标准。更实用的检查是:结论指向哪份文件、哪个版本、哪条依据;找不到依据时,是否明确标记了待确认。
把失败留下来,才有下一轮改进
任务做错一次,人工改好后就结束,这类修正很难积累。
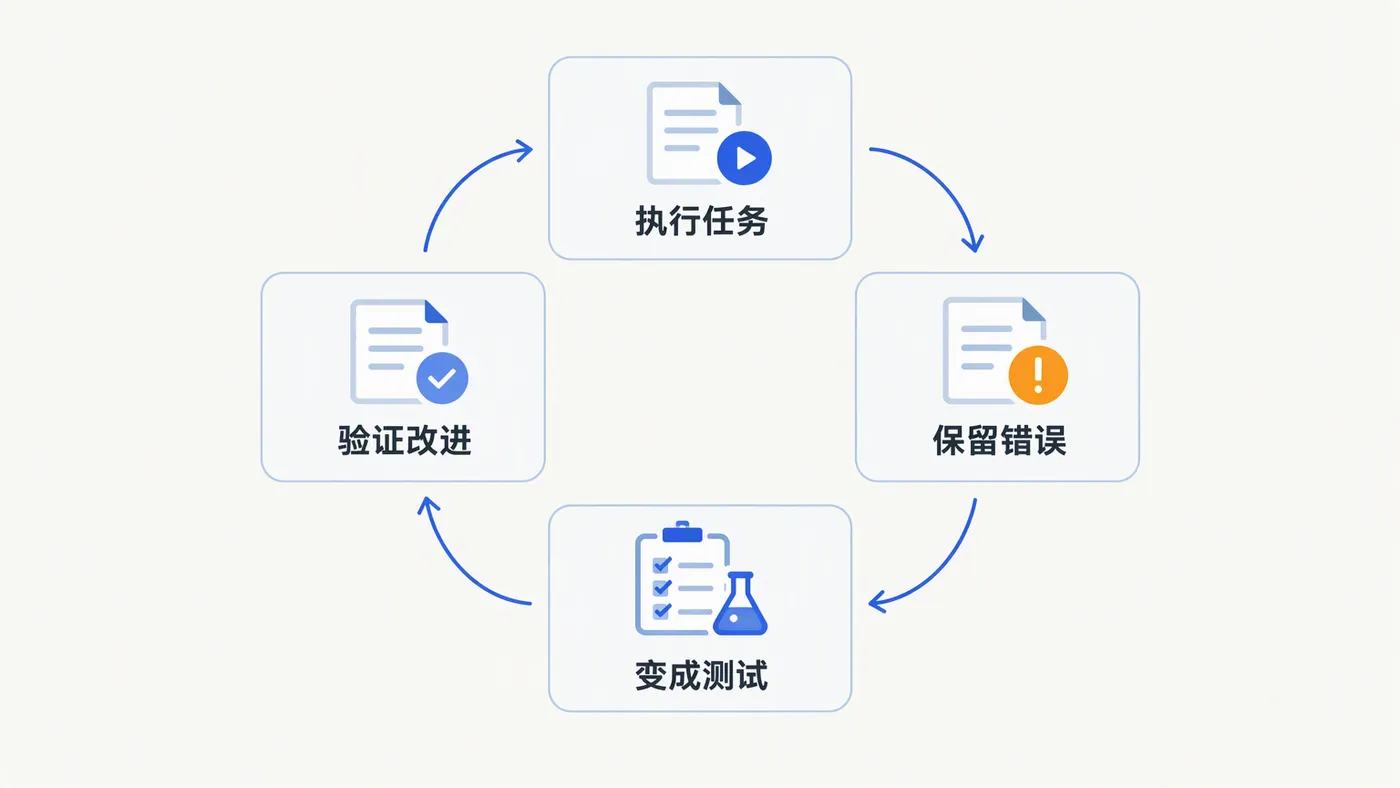
报告第 114 页给出的生产反馈路径更具体:记录真实任务与工具调用,保留修正、重试及执行轨迹,把失败任务改成可重复运行的测试,再验证上下文、工具、路由或模型的调整。
假设一次订单校验漏掉了作废记录,修复后就应把这份输入保留为测试样本,写清楚哪些记录必须排除、结果应当怎样。下次升级模型或改工具接口时,再跑一遍;如果同类错误重新出现,团队能在交付前看到它。
这事儿需要业务人员参与。测试脚本可以判断字段有没有填、金额能否对上,却未必知道某种审批状态能不能放行。成功条件要由懂业务的人给出来,开发人员再把可以自动检查的部分落到程序里。
对于重复任务,Skills 可以封装可复用指令和代码,memory 可以保留后续任务需要的信息。报告第 10 页讨论的正是这类积累。不过,过期规则也可能被重复调用,所以沉淀内容需要标明适用范围、版本和更新责任人。
企业准备试用 Agent 时,可以先挑一个输入相对稳定、结果便于核查的任务,保留一组正常样本和失败样本。每次改动都比较完成情况,同时记录耗时与人工复核工作量。这样才能知道改进有没有发生,以及代价落在哪里。
让 Agent 接进已有业务流程
当任务涉及业务系统,落地还要处理数据入口、操作权限和状态变更。Agent 生成的建议可以先进入待审核区,确认后再由业务系统执行写入;执行记录应保留操作者、输入版本和处理结果,方便追踪。
像活字格这样的 AI 驱动型企业级低代码开发平台,可以用于搭建承接这类任务的业务应用。具体的 Agent 调用、权限规则、审核节点与异常处理,需要按项目设计和验证。选型时,把这些工作条件列进验收清单,才能看清平台与实施团队各自承担什么。
先把一项任务稳定交付,再扩展到相邻流程。每次出现失败,都能复现、定位并检验修复效果,这样的 Agent 才有持续改进的依据。
来源与口径:本文依据 Nathan Benaich / Air Street Capital《State of AI Report 2026》(2026 年 10 月 8 日),报告页码 7、8、9、10、114,对应 PDF 物理页 8、9、10、11、115。实验数字为报告转述;文中的订单、采购和系统接入示例均为说明性假设,不代表客户案例或收益承诺。

