摘要:一次演示中,AI 问数可能只需一句话就生成图表;到了真实业务现场,用户却会继续追问“这个数是怎么算的”。要判断智能问数能否交付,不能只看演示效果,而要准备固定问题集、冻结样例数据、建立人工基准,并验证歧义、权限和失败处理。本文给出一套可复核的验收方法,并以 Wyn 试点说明如何根据实际测试界定适用范围。
演示时一句话就能出图,业务拿到真实问题后却仍会追问:这个数到底怎么算出来的?如果没有固定题集和人工基准,漂亮答案很难变成可交付的结果。
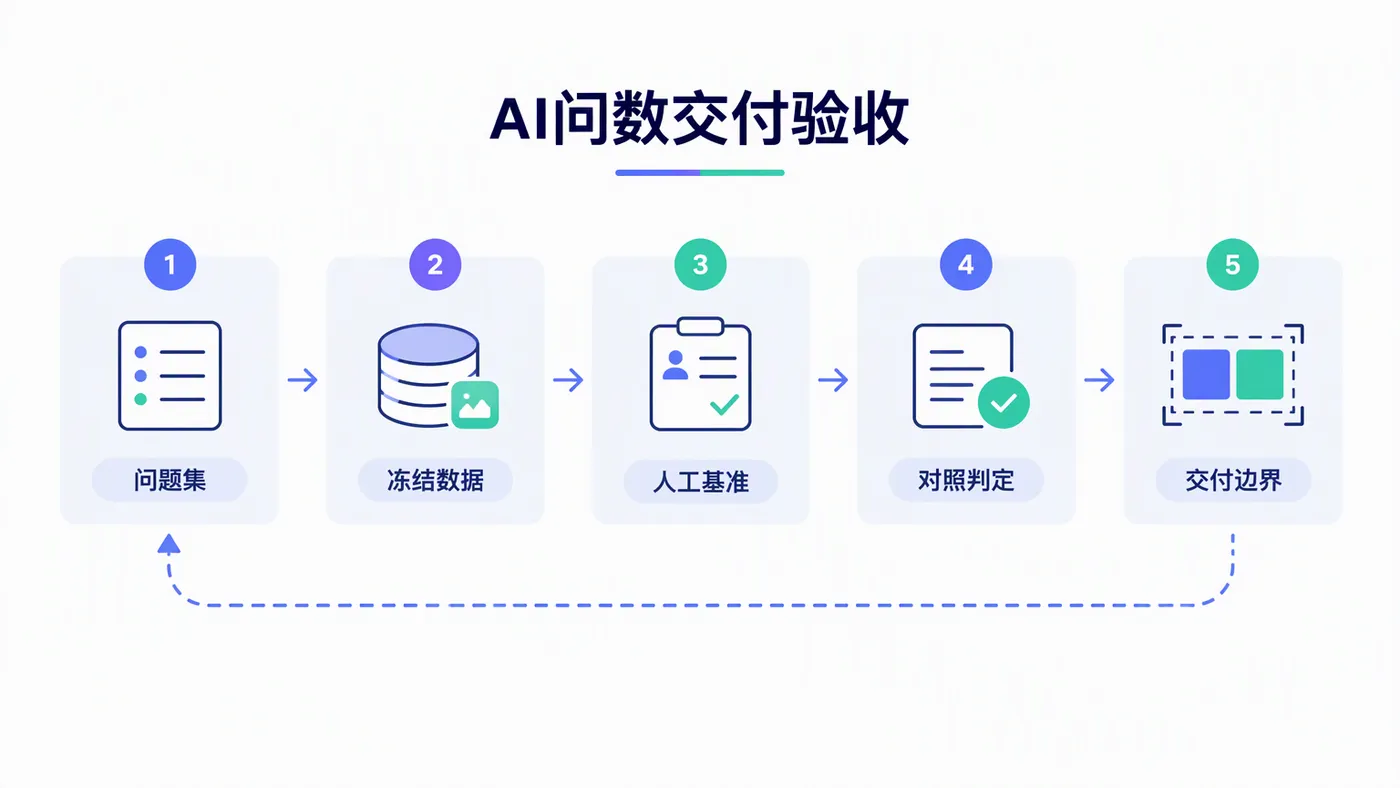
所以,智能问数能不能交付,关键不是它能不能“听懂一句话”,而是能不能在同一套业务问题上,持续给出符合口径、可复核、边界清楚的结果。
一、先定义“答对”:把业务问题写成验收对象
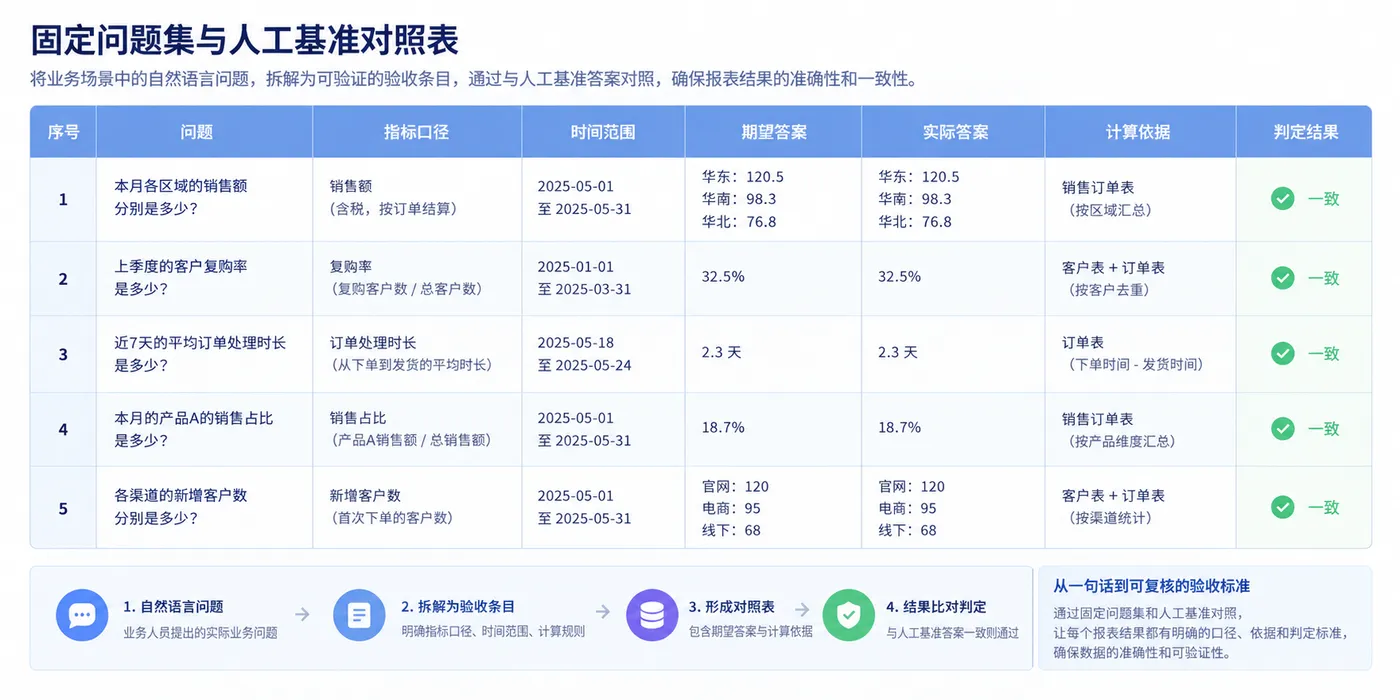
验收不能从随手输入几句自然语言开始,而要先把业务问题写成可以判定对错的题目。销售额、退款金额、客户数都可以作为测试主题,但每道题至少要说明四件事:指标是什么、时间范围是什么、统计对象是谁、期望输出是什么。
例如,“看一下本月销售额”仍不够明确。销售额是否扣除退款?本月按自然月还是最近 30 天?按订单日期还是回款日期?统计范围包含已取消订单吗?这些口径不写清楚,系统给出任何一个数字,都可能看起来合理,却无法判断是否正确。
可以把问题改写成验收条目:
| 项目 | 示例内容 |
|---|---|
| 问题 | 统计 2026 年 9 月已完成订单的销售额,按销售区域汇总 |
| 指标定义 | 销售额按已完成订单金额汇总,不扣除退款 |
| 时间范围 | 2026-09-01 至 2026-09-30,按订单完成日期 |
| 统计对象 | 已完成订单;排除取消订单 |
| 期望输出 | 区域、销售额;按销售额降序 |
| 判定方式 | 数值与人工基准一致,区域范围和排序符合要求 |
“答对”不应只意味着生成了图表。指标口径、筛选条件、分组维度和结果数值都要符合预期;如果题目本身存在歧义,合理的表现也可能是先澄清,而不是猜一个答案交差。
二、冻结样例数据,做出人工基准答案
问题定义清楚后,下一步是固定测试数据。测试期间如果业务数据还在变化,昨天算出的答案和今天算出的答案可能不同,系统表现与数据变化就会混在一起,验收结论自然也不可靠。
为此,需要冻结一份样例数据快照,并由业务人员和数据人员共同确认人工基准。每道题至少保留:基准结果、计算依据、必要的筛选与分组过程,以及允许误差。涉及金额、比例或近似计算时,应提前约定精度;涉及计数类指标时,应明确去重规则和统计粒度。
人工基准不一定要做成复杂的自动化测试系统。可以从一张表开始,记录题目版本、数据快照标识、基准查询或工作底稿、预期结果、实际结果和判定人。关键是别人拿到这些材料后,能按同一口径重算,而不是只能相信某个人的截图。
题目定义、样例数据或基准答案发生变化时,应同步更新版本并保留原因,不要为了让系统答案“变正确”而临时修改口径。
三、给同一问题加入歧义和追问
真实用户不会总是像测试用例一样把条件说完整。“看最近销售情况”“找出大客户”“比较本月同比”都是常见说法,但“最近”可能指最近 7 天、30 天或一个自然月;“大客户”可能按销售额、合同金额或客户等级定义;“同比”也需要确认比较周期和日期口径。
因此,题集不能只有表达清楚的标准题,还要加入带歧义的测试题。观察系统遇到缺失条件时,实际采取了什么行为:主动追问、明确展示采用的假设、给出需要用户确认的条件,还是直接生成了一个没有说明口径的答案?
追问本身可以是合理结果。验收时应把“是否识别到歧义、是否问对关键条件、用户补充后能否按确认口径回答”分开记录。是否通过,应以指定版本的实际行为和业务约定为准;没有立即生成图表,也不等于测试失败。
例如,可以把同一主题设计成两道题:
- 明确题:“统计 2026 年 9 月已完成订单的销售额,按区域汇总。”
- 歧义题:“看一下最近各区域的销售情况。”
第一题检查口径执行能力,第二题检查系统如何处理未定义的时间范围和“销售情况”这一宽泛指标。二者不能混为一个准确率。
四、把权限与不可回答情形放进题集
能算出正确数字,不代表可以对所有人展示。验收时应使用不同测试角色,检查同一问题在不同权限下的实际结果。重点不是只确认账号能否登录,而是验证用户不应看到的数据是否确实不可见,并把测试角色、权限配置和观测结果一并留档。
题集中还应包含系统不应直接作答的情况:数据集中没有所需字段、指标口径尚未定义、问题超出当前数据范围、样例没有匹配记录,或用户提出无法验证的推断。记录系统是拒答、提示缺少条件、返回空结果,还是生成了看似确定的答案。
这些场景尤其重要,因为错误答案往往比明确失败更难发现。一个空结果或澄清提示能提醒用户补充信息;一个带着精确数字、却没有依据的回答,可能直接进入业务决策。
权限题和不可回答题应单独统计,不能被简单成功题稀释。出现越权披露时,这组测试不能通过,即使总体正确率较高,也不能抵消权限风险。
五、将正确性、可解释性与稳定性分开记录
一张成功截图不能代表系统整体表现,建议分开记录三类质量:
- 正确性: 指标、时间范围、筛选、分组和数值是否符合人工基准;
- 可解释性: 是否能看出采用了什么口径、筛选条件和数据范围;
- 稳定性: 同一问题在相同数据、相同配置下重复运行,结果是否一致。
判分规则应预先约定:字段是否必须完全匹配、数值误差范围、追问和拒答如何判定、权限失败是否一票否决。统计准确率时,说明纳入题目、分母、运行次数及失败计数方式。
失败原因也要分类:问题理解偏差、指标口径错误、筛选遗漏、数据缺失、权限异常、结果不稳定、无依据作答或无法回答。一个有用的结论,不是“整体准确率 90%”,而是哪些问题可稳定回答、哪些需要补充定义、哪些必须转人工。
六、在 Wyn 中用同一套问题验证实际表现
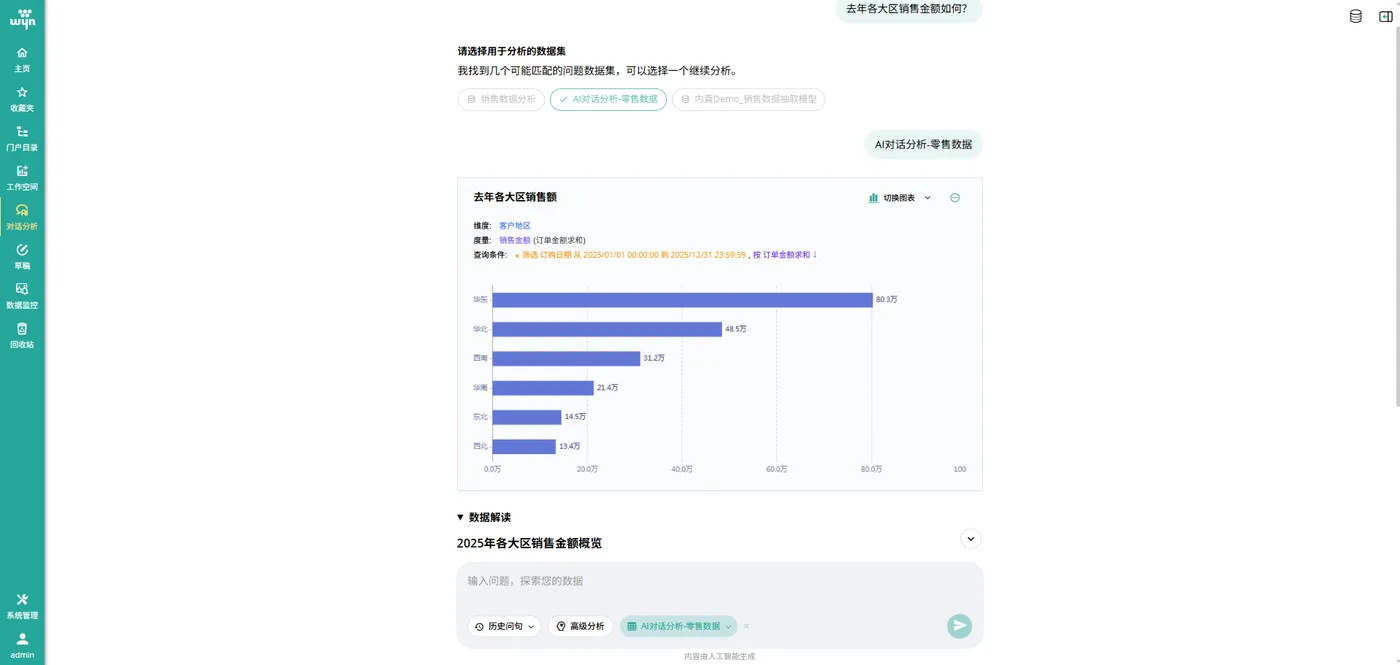
在 Wyn商业智能 中开展智能问数试点时,先固定测试环境,并记录产品版本、许可、启用模块、模型配置、数据集或数据模型,以及测试账号和权限设置。这样不同批次的测试结果才有比较基础。
不要只挑容易成功的问题。至少选一条口径明确的标准题和一条有歧义的问题,观察系统在当前环境中的实际表现:如果它提出追问,就记录追问内容和补充条件后的结果;如果它直接回答,就核对采用的口径;如果无法处理,就记录原因和人工接手方式。
智能问数的语义解释、歧义处理、权限表现和结果说明方式,都应通过具体问题逐项验证。产品介绍可以帮助确定试点方向,最终是否适用于某个业务场景,仍要看实际配置下的测试结果。
实测至少保留两类材料:一条成功案例,展示问题、口径、实际结果与人工基准;一条需要澄清、拒答或人工处理的案例,展示系统边界和后续流程。截图应隐藏真实客户信息,并保留题目与测试前提。
七、把试点结论写成可交付范围
完成测试后,不必用“能交付”或“不能交付”一刀切。更有用的做法,是按问题类型划出三类范围:
| 交付分类 | 判定思路 | 后续处理 |
|---|---|---|
| 可直接开放 | 固定口径下结果稳定、基准一致,权限测试通过 | 纳入标准问题集,持续抽测 |
| 限定口径开放 | 补充时间、指标或统计对象后可正确回答 | 在入口提示范围,要求用户补充必要条件 |
| 必须人工处理 | 定义缺失、数据不覆盖、结果不稳定或风险不可接受 | 明确拒答或转交分析师,不让未经核验的答案进入决策 |
交付物应包括问题集版本、冻结数据快照、人工基准及计算依据、测试账号与配置说明、运行记录、判分规则、失败分类和适用范围,便于复核及后续版本重测。
智能问数是否值得交付,最终要看它能否在明确边界内稳定承担一部分真实问题,而不是能否在舞台上回答一句漂亮的演示问题。与其问“它会不会回答”,不如准备一套业务每天都在问的问题,看看哪些可以放心交给系统,哪些仍需要人来把关。
关键词:AI问数 / 智能问数 / BI验收 / 问题集 / 人工基准 / 权限测试 / Wyn BI