先说结论,Makefile 我敢让 AI 写个七八成,链接脚本我只敢让它写个开头,剩下的必须自己抠。
这不是拍脑袋,是最近两个项目里实打实试出来的。一个是在 imx6ull 上给一个采集板子加新驱动,另一个是给一块国产 Cortex-M 的板子从零搭裸机工程。两个场景我都把 AI 拉进来干活,结果差别挺大,今天把过程摊开讲讲,顺便把我用的提示词贴出来,你可以直接抄。
一、先说我到底让 AI 干了什么
1.1 两个场景的差异
场景一,老工程。Makefile 是前人留下的,几百行,交叉编译、多目录、条件编译混在一起。我要往里加一个新的 sensor 驱动目录,得改 Makefile。
场景二,裸机工程,从零开始。我要一个能编译、能链接、能生成 bin 和 hex 的 Makefile,外加一个匹配这颗芯片内存布局的链接脚本。
这两个场景的区别很关键,一个是「在已有约束里改」,一个是「从零定约束」。AI 在前者表现明显更好,后者就开始飘了。
为什么会有这种差异,想清楚这一点对后面怎么用 AI 很重要。已有约束意味着上下文是完整的,AI 只需要在给定的变量名、目录结构、编译选项里做局部推理,它犯错的空间被压缩了。从零定约束则相反,AI 要自己「发明」一套约束,它会默认套用训练语料里最常见的模板,而这个模板未必匹配你手上这颗芯片。约束越少,AI 的自由度越高,跑偏的概率也越高。这个规律不止适用于 Makefile 和链接脚本,所有「让 AI 从零生成工程骨架」的任务都成立。
1.2 为什么这个区分重要
如果你把这两个场景混为一谈,很容易得出「AI 写构建系统不靠谱」或者「AI 写构建系统真香」这种一刀切的结论。实际情况是分层的,改得动的地方大胆用,定不下来的地方自己上。后面几节就是按这个思路展开的。
二、Makefile 怎么让 AI 写
我用的工具是 Claude,也试过 ChatGPT,结论差不多,这里不比较谁强,只说用法。
2.1 第一步,把约束喂清楚
别上来就让它写。先把约束喂清楚。我的提示词大概长这样。
我在做一个嵌入式C工程,需要你帮我写Makefile。
约束如下:
- 交叉编译器:arm-linux-gnueabihf-gcc
- 源文件在 src/ 下,分 src/driver、src/app 两个子目录
- 头文件在 include/
- 输出目录 build/,中间文件.o也要放进去
- 目标文件名 sensor_app
- 编译选项:-Wall -O2 -std=c99
- 需要生成 .bin,用 arm-linux-gnueabihf-objcopy
请给出完整Makefile,并逐段解释每个变量的作用。
这一步出来的东西,说实话,能用。变量定义、wildcard 收集源文件、patsubst 换后缀、vpath 找头文件,套路是对的。我基本改了两处就跑了,一处是它把 -I 路径写成了绝对路径,得换成相对;一处是 .bin 的规则它漏了依赖顺序,第一次 make 会报找不到 elf。
为什么绝对路径是个问题,值得说透。绝对路径在你的机器上能编,换一台机器、换一个 CI 环境就断,而且断的时候报错信息往往是「找不到头文件」,排查方向容易跑偏到源码上。Makefile 里凡是涉及工程内路径的,一律用相对于 Makefile 所在目录的路径,配合 $(CURDIR) 或者 $(dir $(lastword $(MAKEFILE_LIST))) 定位,这是硬规矩。
依赖顺序那处更典型。.bin 由 .elf 经 objcopy 生成,.elf 又由 .o 链接生成,这条链在 Makefile 里必须显式写清依赖。AI 漏掉依赖时,make -j 并发编译下第一次构建经常失败,第二次就好了,这种「第二次能过」的 bug 最阴,因为它会让人误以为是环境抖动。
2.2 第二步,让它做增量修改
加驱动目录的时候我这么说。
在上面的Makefile基础上,新增一个目录 src/driver/sensor,
里面的.c文件也要参与编译,其他规则不变,只告诉我需要改哪几行。
这个用法很舒服。它不会把整个文件重写一遍,只给你 diff 级别的改动,我核对起来快。记住一点,让 AI 改,别让它重写。重写容易把它上一版对的东西又改错。
增量修改为什么更可靠,从信息论角度看很清楚。重写意味着 AI 要重新生成几百行,每一行都是一次新的采样,出错概率随行数线性累积。增量修改只生成几行 diff,出错面被限制在这几行里,你核对的工作量也同步缩小。工程越大,这个差别越明显。几百行的 Makefile 重写一次,你要逐行比对,跟手写一遍的工夫差不多,AI 省的时间全还回去了。
2.3 翻车的地方
翻车的地方也有。有一次我让它加一个「根据宏定义切换两颗不同芯片」的条件编译,它给我写了个 ifeq 嵌套,逻辑上没错,但变量展开的时机搞错了,导致 CFLAGS 在递归 make 里丢了一段。这个坑我自己盯了半天才看出来。所以涉及 make 的变量展开、递归调用、$(shell ...) 这类,AI 给的代码必须逐行读,不能信。
变量展开时机这个问题值得单独展开。make 里有立即展开(:=)和延迟展开(=)两种赋值,还有 override、export 对作用域的影响。递归 make 时子 make 拿到的是环境变量,父 make 里用 = 定义的变量如果没 export,子 make 根本看不到。AI 生成的代码经常把 = 和 := 混用,单层 make 下看不出问题,一旦进了递归就丢变量。这类错误的现象是「顶层编过了,子目录里的编译选项不对」,报错信息又指向别处,排查成本很高。
下面这段是修正后的写法示例,把条件编译和导出都写明确,可以直接跑。
# 顶层 Makefile 片段,演示条件编译与变量导出的正确姿势
CHIP ?= imx6ull

# 用 := 立即展开,避免递归 make 时重复求值
ifeq ($(CHIP),imx6ull)
    CROSS_COMPILE := arm-linux-gnueabihf-
    CHIP_DEFS     := -DCHIP_IMX6ULL
else ifeq ($(CHIP),stm32f4)
    CROSS_COMPILE := arm-none-eabi-
    CHIP_DEFS     := -DCHIP_STM32F4
else
    $(error 未知的 CHIP 取值 $(CHIP),请指定 imx6ull 或 stm32f4)
endif

CC      := $(CROSS_COMPILE)gcc
CFLAGS  := -Wall -O2 -std=c99 $(CHIP_DEFS)
LDFLAGS := -T link.lds -nostartfiles

# 关键一步,把子 make 需要的变量显式导出
export CC CFLAGS LDFLAGS

SUBDIRS := src/driver src/app

.PHONY: all $(SUBDIRS) clean

all: $(SUBDIRS)

$(SUBDIRS):
    $(MAKE) -C $@

clean:
    for d in $(SUBDIRS); do $(MAKE) -C $$d clean; done
这段里 $(error ...) 那行是刻意加的,AI 生成的版本通常没有这种兜底,CHIP 拼错时它会静默走 else 分支,编出来的固件跑在错误的芯片上。加一行显式报错,把「编过了但不对」变成「编不过」,是构建脚本里性价比最高的防御手段之一。
三、链接脚本,这里我开始谨慎了
3.1 骨架能出,细节得补
链接脚本我一开始也想偷懒,直接让它生成。提示词是这样的。
帮我写一个GNU ld链接脚本,目标芯片是Cortex-M4,
Flash起始0x08000000,大小512K;
RAM起始0x20000000,大小128K;
需要定义 .isr_vector、.text、.data、.bss 段,
.data要从Flash加载到RAM运行,
提供 _estack、_sidata、_sdata、_ebss 符号。
出来的脚本,结构是对的,段名、AT> 加载地址、>RAM AT>FLASH 这些写法都在。但问题出在细节。
第一,.isr_vector 它放的位置对,但没保证是文件里第一个段,实际链接时向量表可能不在 0x08000000,板子一上电就跑飞。这个必须自己加 KEEP 和排序约束。
第二,栈顶 _estack 它直接写成 0x20000000 + 128K,看着没问题,但如果后面 RAM 要划一块给别的用途,这个值就得跟着改,它不会替你考虑。
第三,对齐。.data 的加载地址它没做 4 字节对齐,个别情况下 objcopy 出来的 bin 会有坑。
所以我的实际做法是,让 AI 出骨架,自己补三样东西,向量表位置、栈顶符号、段对齐。骨架省了我查语法的时间,这三样省不了。
3.2 用真实数字算一遍
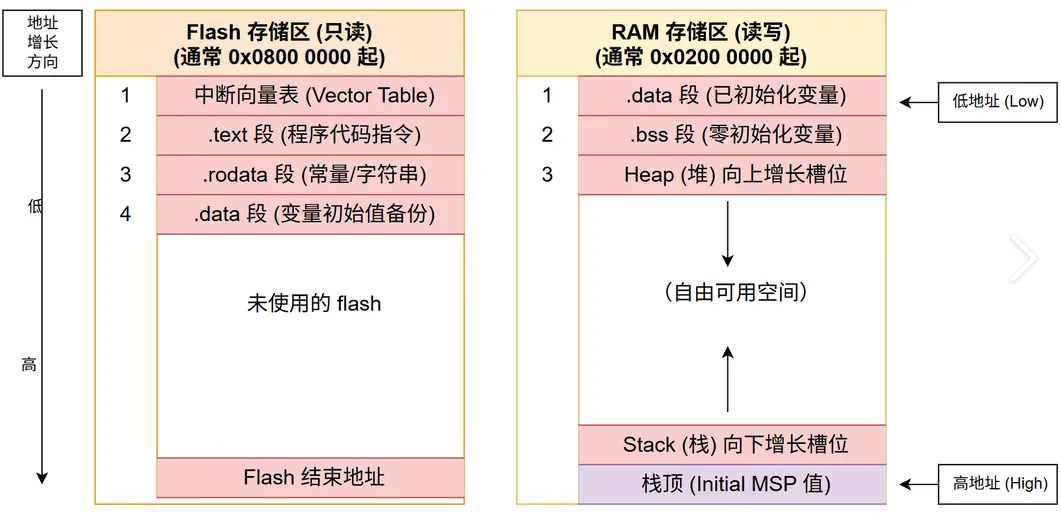
把上面那组参数代入算一遍,能看清几个符号到底指什么。
Flash 起始 0x08000000,大小 512K,结束地址是 0x08000000 + 0x80000 = 0x08080000。RAM 起始 0x20000000,大小 128K,结束地址是 0x20000000 + 0x20000 = 0x20020000。栈顶 _estack 就取 RAM 结束地址 0x20020000。
.data 段在 Flash 里的加载地址(LMA)从 .text 结束处接着排,假设 .text 结束在 0x0800A000,那 _sidata 就是 0x0800A000 向上对齐到 4 字节边界。.data 在 RAM 里的运行地址(VMA)从 0x20000000 开始,_sdata 就是 0x20000000,_ebss 在 .data 和 .bss 之后。启动文件里的拷贝循环,就是把 [_sidata, _sidata + (_edata - _sdata)) 拷到 [_sdata, _edata),再把 [_bss_start, _ebss) 清零。
这几个数字的意义在于,只要有一个符号算错,现象就是「程序进了 main 但全局变量初值全是 0」或者「一进中断就 HardFault」。这类问题用调试器单步能看出来,但不知道往哪看的话,很容易怀疑到编译器或者芯片上。
3.3 一段可运行的补丁代码
下面这段 C 代码是启动文件里配套上面符号的拷贝逻辑,可以直接放进 Reset_Handler,注释标了每个符号对应的段。
/* startup.c 片段,配合链接脚本里的 _sidata/_sdata/_edata/_sbss/_ebss 符号使用 */
#include <stdint.h>

/* 这些符号由链接脚本提供,声明成外部符号,取地址即为边界 */
extern uint32_t _sidata;   /* .data 在 Flash 中的加载起始地址 (LMA) */
extern uint32_t _sdata;    /* .data 在 RAM 中的运行起始地址 (VMA) */
extern uint32_t _edata;    /* .data 在 RAM 中的运行结束地址 */
extern uint32_t _sbss;     /* .bss 起始地址 */
extern uint32_t _ebss;     /* .bss 结束地址 */
extern uint32_t _estack;   /* 栈顶,通常等于 RAM 结束地址 */

extern int main(void);
extern void SystemInit(void);

void Reset_Handler(void)
{

    uint32_t *src = &_sidata;
    uint32_t *dst = &_sdata;

    /* 1. 把 .data 从 Flash 拷贝到 RAM,初值不为 0 的全局变量靠这一步 */
    while (dst < &_edata) {

        *dst++ = *src++;
    }

    /* 2. 清零 .bss,未初始化或初值为 0 的全局变量靠这一步 */
    dst = &_sbss;
    while (dst < &_ebss) {

        *dst++ = 0;
    }

    /* 3. 时钟、外设等芯片相关初始化,一般由厂商库提供 */
    SystemInit();

    /* 4. 进 main,正常不返回 */
    (void)main();
    for (;;) {

        /* main 返回说明有 bug,停在这里方便调试器捕获 */
    }
}

/* 向量表,放在 .isr_vector 段,链接脚本必须用 KEEP 保证它不被回收 */
__attribute__((section(".isr_vector"), used))
void (* const g_vectors[])(void) = {

    (void (*)(void))&_estack,   /* 初始栈顶,硬件上电后第一个加载的值 */
    Reset_Handler,              /* 复位向量 */
    /* 其余异常和中断向量按芯片手册顺序补齐 */
};
这段代码里有两个地方是 AI 生成版本经常漏的。一个是 __attribute__((section(".isr_vector"), used)) 里的 used,防止编译器认为这个数组没被引用而优化掉。另一个是 g_vectors 必须声明成 const,否则它会被放进 .data 而不是 Flash 里的只读区,链接脚本里 .isr_vector 段的放置就失去意义。这两点不看手册很难想到,但错了就是上电跑飞。
四、常见误区
4.1 误区一,AI 生成的 Makefile 能编过就等于对
错误认知是把「make 成功」当作验收标准。正确做法是编过之后还要看三样,编译选项是否真的传到了每个子目录、.bin 和 .hex 的大小是否和预期量级一致、make clean 之后重新构建是否仍然成功。第一项对应变量导出问题,第二项能抓出段被误链接,第三项能抓出隐式依赖缺失。三项都过,才算这个 Makefile 及格。
4.2 误区二,链接脚本让 AI 从零生成能省事
错误认知是既然语法是标准的,AI 生成的和手写的等价。正确做法是把它当成草稿,向量表位置、栈顶符号、段对齐这三处必须逐行核对,并且和启动文件里的符号名一一对上。链接脚本和启动文件是一对耦合件,任何一方改了符号名,另一方必须同步改,AI 不会替你维护这个耦合关系。
4.3 误区三,让 AI 边写边解释就等于学会了
错误认知是把 AI 的逐段解释当作学习材料。正确做法是拿它的解释当索引,回到 GNU make 手册和 ld 手册里找对应章节读原文。AI 的解释在常见用法上基本对,在边界条件上经常含糊,而嵌入式构建出问题恰恰都出在边界条件上。学的时候用它指路,验证的时候以手册为准。
五、参数对照表
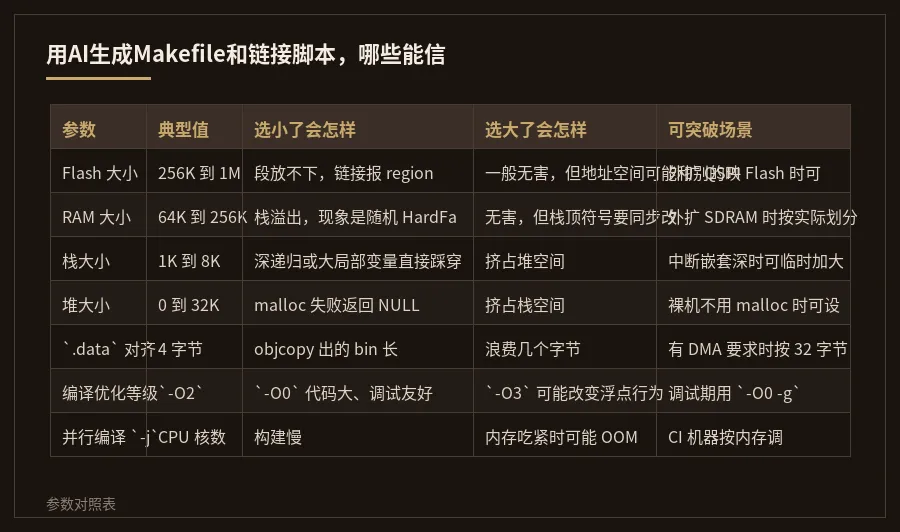
下面这张表把本文涉及的主要参数和典型取值列出来,方便对照自己工程里的设置。
| 参数 | 典型值 | 选小了会怎样 | 选大了会怎样 | 可突破场景 |
|---|---|---|---|---|
| Flash 大小 | 256K 到 1M | 段放不下,链接报 region overflow | 一般无害,但地址空间可能和别的映射冲突 | 外扩 QSPI Flash 时可超过片内 |
| RAM 大小 | 64K 到 256K | 栈溢出,现象是随机 HardFault | 无害,但栈顶符号要同步改 | 外扩 SDRAM 时按实际划分 |
| 栈大小 | 1K 到 8K | 深递归或大局部变量直接踩穿 | 挤占堆空间 | 中断嵌套深时可临时加大 |
| 堆大小 | 0 到 32K | malloc 失败返回 NULL | 挤占栈空间 | 裸机不用 malloc 时可设 0 |
.data 对齐 |
4 字节 | objcopy 出的 bin 长度异常 | 浪费几个字节 | 有 DMA 要求时按 32 字节对齐 |
| 编译优化等级 | -O2 |
-O0 代码大、调试友好 |
-O3 可能改变浮点行为 |
调试期用 -O0 -g |
并行编译 -j |
CPU 核数 | 构建慢 | 内存吃紧时可能 OOM | CI 机器按内存调 |
六、排查清单
构建出问题时,按下面几条顺序过一遍,能覆盖大部分现象。
- [ ]
make -n看实际执行的命令行,确认-I路径和-D宏都传到位了 - [ ]
make clean && make完整重建一次,排除增量构建的隐式依赖问题 - [ ] 用
$(info $(CFLAGS))在子目录 Makefile 里打印变量,确认递归 make 没丢变量 - [ ]
arm-none-eabi-objdump -h看各段地址,确认.isr_vector在 Flash 起始处 - [ ] 对比
.data的 LMA 和 VMA,确认启动文件里的拷贝源地址和链接脚本一致 - [ ]
arm-none-eabi-size看 text/data/bss 三段大小,和预期量级对一遍 - [ ] 上电后用调试器读 0x08000000 头两个字,确认是栈顶值和复位向量
七、选型对照与使用边界
7.1 哪些能信,哪些别信
用下来我大概划了条线。
能信的,Makefile 的模板结构、变量命名、常见的模式规则、.PHONY 这类规范写法、链接脚本的段定义骨架、AT> 这种语法。这些是「查手册能查到、但查起来烦」的东西,AI 帮你省时间,值。
别全信的,make 的变量展开时机、递归 make、条件编译的组合逻辑;链接脚本里的内存布局细节、对齐、符号地址计算、启动文件和脚本的配合。这些错一个,现象往往是「编译过了、跑起来不对」,排查成本比手写还高。
还有一类我基本不让它碰,和具体芯片手册强相关的地址、寄存器、启动流程。这些它给的数值可能是从别的芯片抄来的,看着像模像样,实际是错的。手册还是得自己翻。
7.2 什么情况下别用它
说几个我踩过或者想明白的场景。
一是你本身不熟 Makefile 和链接脚本的时候,别拿 AI 的输出去「学」。它会给你一个看起来对的答案,但你看不出哪里错了,最后是带着错误认知往下走。这种时候先看手册和官方例程。
二是老工程里语法很「野」的,比如大量自定义函数、include 嵌套、非标准的目录结构,AI 容易按通用套路给你改,改完编译过了但行为变了。这种我宁可自己动手。
三是时间紧、又要一次成功的场合。AI 省的是打字时间,不省核对时间,急着上线的时候,核对成本反而更突出。
最后说句实在的,这两个东西,AI 现在的位置是「帮你把八成的体力活干了,剩两成脑力活还得自己上」。Makefile 那八成比较实,链接脚本那八成有点虚。你要是刚开始用,建议先从改 Makefile 试起,跑通了再往链接脚本上靠,别一上来就让它从零生成整个裸机工程,容易给自己挖坑。