摘要:模型一开始是一堆随机数,预测全靠猜。它凭什么越猜越准?答案是一个五步闭环:猜 → 打分 → 归因 → 改 → 再来。但真正值得警惕的是最后一环:训练分数一路下降,模型可能已经学废了。这篇文章把"学习"这件事,从技术讲到管理。
一、"知道自己错了",其实一点用都没有
先讲个场景。
模型预测一份外卖要 21 分钟,实际送了 25 分钟。
错了。然后呢?
一个正在学 AI 的人在这里卡住了,他问的问题特别好:模型怎么知道错在哪儿?更重要的是,它怎么知道该改什么?
"知道自己错了"这件事,本身毫无价值。
你考试得了 60 分,知道自己考砸了——然后呢?如果不分析是哪类题错了、错在哪个步骤、下次该往哪个方向调整,那"知道自己错了"就只是一句情绪。
模型也一样。它需要的不是"错了"这个判断,而是一个数学上可执行的改进方案。
这就是"训练"要解决的问题。而解决它的办法,是一套朴素到令人意外的闭环。
二、开工前先分卷子:练习题、模拟考、期末考
在讲训练之前,得先说一件最容易被忽略、也最容易被做错的事:数据要分成三份。
|
数据集
|
干什么用
|
类比
|
| --- | --- | --- |
|
训练集
|
学参数
|
平时的练习册
|
|
验证集
|
调参数、看进度
|
模拟考
|
|
测试集
|
最终评估
|
期末考
|
这三者必须严格分开。尤其是期末考那份卷子,平时一次都不能看。
为什么?因为如果你用期末考的题当练习题,考出来的高分毫无意义——你只是把答案背下来了。
这个道理特别朴素,但现实中踩坑的极多:拿同一批数据既调参又验收,最后报告一个漂亮的数字,上线就翻车。
数据准备还有几步:清洗(去掉错误数据)、转成数字、必要时归一化(把不同量纲拉到可比范围)。我们前面讲过"5 公里 × 2 = 5000 米 × 0.002",归一化就是为了避免这类量纲陷阱。
三、起点:一堆随机数
训练开始前,模型所有的权重和偏置,都是小的随机数。
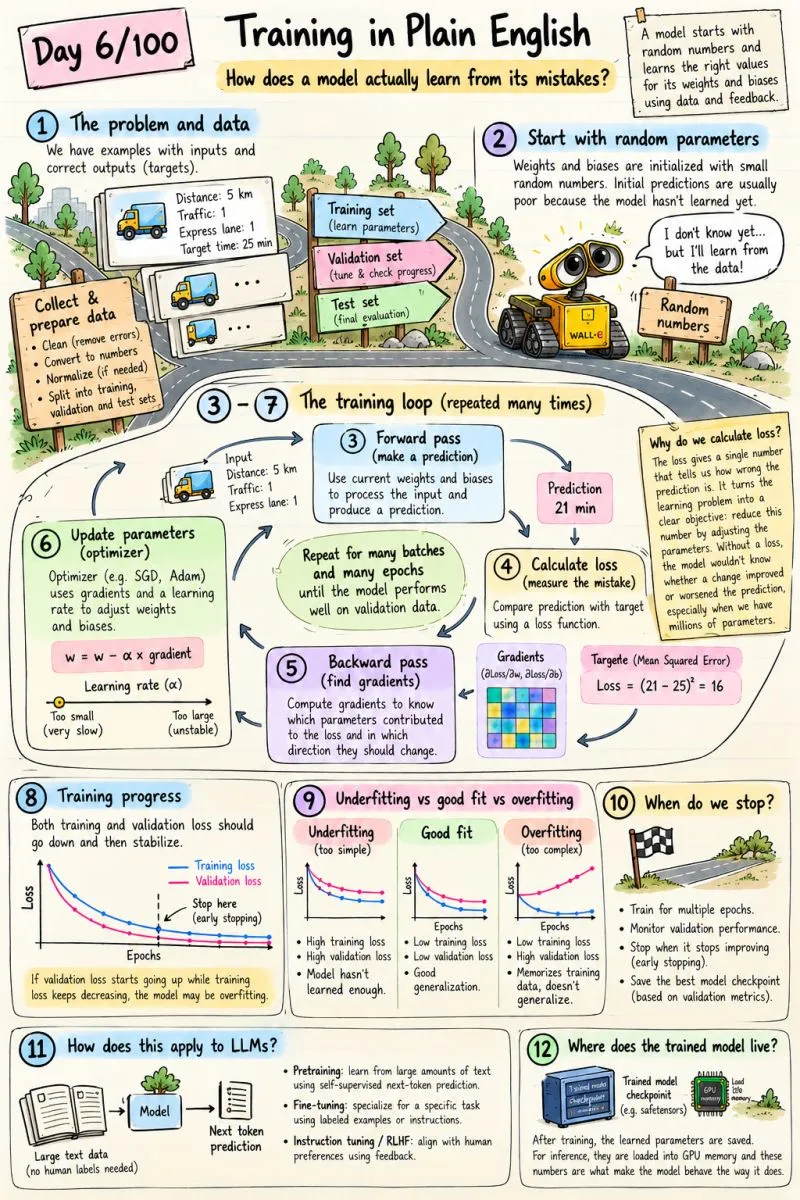
这时候它做的预测,基本等于瞎猜。图里那个小机器人说得挺可爱:"我还不知道……但我会从数据里学!"
所以一个重要的认知是:架构本身不携带任何知识。 同样的架构,装上随机数,预测出来的配送时间可能是 −13 分钟(负数,荒谬);装上训练好的参数,才能给出 23 分钟这种有用的答案。
我们在上一篇讲过这句话——架构是容器,权重是内容。训练,就是往容器里装内容的过程。
四、五步闭环:AI 的"错题本"
训练的核心,是一个不断重复的五步循环。
第一步:前向传播(先猜一个) 用当前的权重和偏置,把输入算一遍,得到一个预测。
距离 5 公里、拥堵 1、快速通道 1 → 预测 21 分钟
第二步:算损失(打分) 把预测和真实答案比一比,用一个函数算出"错了多少"。
图里用的是均方误差(MSE):
Loss = (21 − 25)² = 16
为什么非要算这个数?因为它把"错了"这个模糊的感觉,变成了一个可以最小化的单一数字。有了这个数字,学习才有了明确的目标:想办法把它降下去。
这一步看着简单,其实是整个 AI 的枢纽。没有损失函数,"学习"就无从谈起——你不能优化一个你无法度量的东西。
第三步:反向传播(归因) 算出每个参数对这次错误的"贡献":∂Loss/∂w、∂Loss/∂b。
这一步回答的是:谁该背锅?背多少?往哪个方向改能减轻?
从损失出发,一层层往回倒推,用微积分的链式法则,把责任分配到每一个参数头上。这就是反向传播。
第四步:更新参数(改) 优化器拿着梯度,按学习率调整参数:
w = w − α × 梯度
减号很关键:梯度指向"损失上升最快"的方向,我们要往反方向走。
那个 α 就是学习率,相当于油门:
太小 → 挪得极慢,可能几百年也到不了,还可能卡在半路的小坑里
太大 → 一步跨过头,来回震荡,极端情况直接发散(损失变成 NaN,训练崩了)
参考量级:用 Adam 类优化器做 NLP 任务,常见在 1e-4 到 1e-3;SGD 做视觉任务常在 1e-2 到 1e-1。具体取决于模型、数据和优化器,没有万能值。
第五步:重复 对一批又一批数据、一遍又一遍地重复上面四步,直到模型在验证集上的表现不再变好。
就这样。整个"学习",就是这五步跑几百万次。
(至于优化器具体怎么选——SGD、Momentum、Adam、AdamW 各自的脾气和适用场景,我们前面专门写过一篇"下山策略",这里不重复。)
五、三个必须搞懂的词:batch、epoch、learning rate
Batch(批):一次拿多少道题,改一次参数。
不看完全部数据再改(太慢),也不看一道就改(太抖),而是取一小批——常见的 16、32、64、128、256。批越大,梯度估计越稳、GPU 利用率越高,但显存吃得多,而且有研究认为过大反而可能损害泛化。工程上还有条经验:批大小放大 k 倍,学习率通常也要相应放大。
Epoch(轮):把整个训练集完整过一遍,叫一个 epoch。
一般任务要跑十几到上百个 epoch;而微调大模型,往往只有 1 到 3 轮。
顺带一个细节:每个 epoch 开始前,数据要重新打乱。否则如果数据是按类别排好序的(先全是 A 类,再全是 B 类),模型会学到"顺序"这种伪规律,而不是真正的规律。
学习率(α):每次参数改多少,就是那个油门。
而且现代训练几乎不会让它从头到尾固定不变,而是用调度策略:
Warmup(预热):开头几百到上万步,从接近 0 慢慢升到目标值。这对 Transformer 尤其关键——起步时梯度统计不可靠,一上来就猛踩容易出事。
Cosine 衰减:预热之后,按余弦曲线平滑降到很小的值。前期大步快跑,后期小步精修。
这套"先慢、再快、最后慢"的节奏,本质是对"不确定性"的管理:刚开始你不了解地形,别猛冲;快到终点了,别再大步跨。
六、最关键的一节:loss 一路下降,模型可能已经学废了
终于到本篇最想讲的地方。
图里画了三条曲线,标出了三种状态:
|
状态
|
训练损失
|
验证损失
|
含义
|
| --- | --- | --- | --- |
|
欠拟合
|
高
|
高
|
根本没学会,容量不够或练得不够
|
|
良好拟合
|
低
|
低
|
学到了可泛化的规律
|
|
过拟合
|
低
|
高
|
死记硬背,换个新题就不会
|
看第三行:训练损失很低,验证损失很高。
这就是最危险的情形——你在练习册上拿了满分,一上考场就废。
典型的过程是这样的:训练损失一路下降,验证损失也跟着降,降到某个最低点之后,开始掉头向上,而训练损失还在继续降。
这条验证损失的曲线,形状像一个 U。
U 的底部,就是泛化最好的那个点。 底部右边的所有训练,都是在让模型变得更擅长"做旧题"、更不擅长"做新题"。
两条曲线之间的差距,叫泛化差距(generalization gap)。差距越大、越还在扩大,就说明模型越在拟合训练集特有的噪音,而不是普遍规律。
一个让人后背发凉的实验
关于"训练 loss 低到底说明什么",有个实验值得所有人知道。
Zhang 等人在 2017 年(这篇拿了 ICLR 最佳论文)做了一件事:把图像数据集的标签全部换成随机乱码,然后拿标准深度网络去训练。
结果:网络依然能把训练误差降到 0。也就是说,它能把一堆毫无意义的随机标签,完美地"背"下来。
这个实验的含义极其尖锐:
"训练损失降到零"这件事,完全可以是"死记硬背"的证据,而不是"学会了"的证据。
研究者还发现,把正则化(dropout、权重衰减、数据增强)全部去掉,模型在真实数据上的测试表现也没怎么变差——也就是说,显式正则化既不是网络能泛化的必要条件,也不是充分条件。
所以:只要没有一份模型从没见过的数据在旁边盯着,你根本无法区分"学会了"和"背下来了"。
这大概是对"分数高=学得好"这个直觉,最彻底的一次打脸。
七、知道什么时候停:最便宜的一顿免费午餐
既然 U 型底部才是最好的,那答案就很简单:在底部停下来。
这就是早停(early stopping):盯着验证集表现,一旦不再变好就停,哪怕训练损失还在降。
工程上有两个小设计:
耐心值(patience):连续多少轮没有改善才算真的停(常见 3–10 轮,中小模型 3–6 居多)。因为验证曲线本身会抖动,不能一看到反弹就慌。
保存最佳 checkpoint:你最终部署的,是验证表现最好的那一次,不是最后那一次。 这一点很多人搞错。
Hinton 有句被广泛引用的评价,早停是一顿"美丽的免费午餐"——几乎不花成本,效果却常常抵得上显式的正则化惩罚。数学上,在线性模型里,早停等价于一种 L2 正则化;直观理解是:少走几步,参数就离初始值更近,也就更"简单"。
一个反直觉的补充
但有个重要例外,值得单独说:
大模型的预训练,通常不做早停。
因为预训练是在一个事先定好的 token 预算上跑的,海量数据,模型基本每个 token 只看一遍。既然没"重复刷题",那条 U 型曲线就不会出现——训练损失和验证损失一起单调下降,直到算力用尽。
在这种情形下,最好的 checkpoint,往往就是最后一个。
而微调恰恰相反:数据量小、Epoch 少、极易过拟合,早停在这里最能发挥作用(常见 1–3 轮,每几百步评估一次,保存最佳)。
同一个技术,在两种场景下的结论完全相反。这说明了一件事:任何方法论都有它的适用边界,脱离场景谈"最佳实践",都是耍流氓。
八、放到大模型上:这五步闭环变成了什么?
图里最后给了个衔接。大模型的训练,本质上还是那个五步闭环,只是"答案"不需要人给:
预训练:用海量文本做"预测下一个 token"。标签就是文本本身,不需要人工标注——这是一切规模化的前提。
微调(Fine-tuning):用标注样本或指令数据,让模型专精某个任务。
指令微调 / RLHF:用人类反馈对齐偏好,让模型不仅"会答",还"答得像人想要的"。
训练结束后,学到的参数被存成 checkpoint(比如 safetensors 格式),推理时再加载进 GPU 显存。
所以你每一次和 AI 对话,背后都是这一整套流程的最终产物——一堆被反复打磨过的数字,躺在显卡里,等着被乘一遍。
九、讲给不做算法的人:四条可以立刻用上的
第一,"知道错了"没有价值,"知道怎么改"才有。
损失函数干的事,是把"这次不太好"这种模糊感受,变成一个可以度量、可以归因、可以最小化的数字。很多团队的复盘之所以无效,就是因为停在了"这次做砸了",而没人能回答:砸在哪个环节、该往哪个方向调、调多少。
先定义清楚你的"损失",再谈改进。 一个不可度量的目标,是不可优化的。
第二,练习题、模拟考、期末考,必须分开。
用期末考的卷子当练习题,考出满分也说明不了任何问题。企业里最常见的自欺,就是拿同一批数据既调参又验收,然后对外报告一个漂亮数字。
一定要留一份从没参与过任何决策的数据,在最后做一次真正的验收。
第三,指标一路向好,可能只是在拟合噪音。
Zhang 2017 那个实验值得每个看报表的人记住:一个足够复杂的系统,可以把完全随机的东西也"背"到满分。
所以当你看到某个指标持续改善时,多问一句:这是在新数据上改善,还是在同一批数据上精修? 前者叫学习,后者叫背答案。
第四,知道什么时候停,是一种稀缺能力。
早停被称作"免费的午餐",因为它几乎不花额外成本,却能避免最典型的浪费——在噪音上继续精修。
很多项目不是做得不够,是做得太久。当验证信号已经不再改善,继续投入的每一分资源,都在让系统更适应过去,而不是更能应对未来。
十、结语
回到开头那个场景:模型预测 21 分钟,实际 25 分钟。
现在你知道接下来会发生什么了——
它会把"错了 4 分钟"变成一个数字(16),把责任分配到每一个参数头上,然后按学习率往反方向挪一小步。这个过程重复几百万次,它就学会了。
但真正值得记住的,是这个闭环之外的那句话:
训练损失下降,不等于学得好。只有在新题上依然有效,才叫学到了。
这话放在技术里成立,放在人身上,也一样成立。
一个人是不是真的掌握了什么,不看他把旧题做得多熟,看他遇到没见过的问题时,还能不能用得上。
"学习"这件事的终点,从来不是把已知的东西重复到满分,而是——对未知依然有效。
互动话题:你有没有过这种经历——反复练习某套题、某份材料,分数越来越高,但真到实战时却发现用不上?后来你是怎么意识到"我其实只是在背"的?欢迎评论区聊聊。
免责说明:本文核心框架整理自社交平台「100 Days of AI Inference」系列 Day 6/100 公开信息图《Training in Plain English》(图内仅标注系列名,未署个人作者,故不臆造出处)。图中示例与流程(配送预测 21 分钟 vs 目标 25 分钟、Loss = (21−25)² = 16、梯度 ∂Loss/∂w 与 ∂Loss/∂b、更新式 w = w − α×梯度、早停标记、欠拟合/良好拟合/过拟合三态、预训练→微调→指令微调/RLHF、checkpoint 加载进 GPU)均以原图为准。补充的工程细节与学术结论经多源交叉核实:batch 常见取值 16–256 及与学习率的缩放经验;epoch 为完整遍历训练集,一般任务十余至上百轮、大模型微调常 1–3 轮,且每轮需打乱数据;学习率典型量级(Adam 类做 NLP 常见 1e-4–1e-3,SGD 做视觉常见 1e-2–1e-1,视模型而定)与 warmup + cosine 衰减调度;过拟合的 U 型验证曲线与泛化差距、早停的 patience 常见 3–10 轮及"部署最佳 checkpoint 而非最后一个";早停被学界广泛引述为"免费的午餐"(Hinton);Zhang et al. (2017, ICLR 最佳论文) 证明深度网络可将随机标签拟合至零训练误差,且显式正则化对解释泛化既非必要也非充分;LLM 预训练因单 epoch 固定 token 预算通常不做早停,而微调场景早停价值最大——此二者的分野已在文中明确标注适用边界。本文与本项目第 31 篇(优化器选型)、第 34 篇(模型与参数)、第 37 篇(权重与偏置、知识分布式存储)相互呼应。本文为技术科普与思维类比,不构成训练配置或投资决策建议。