
摘要:模型初始化是每个 LangChain 应用的第一行代码,也是最容易写歪的地方——Key 硬编码、temperature 全程默认 0.7、timeout 从不设置、换模型就要动业务代码。本文围绕 v1.0 的统一入口
init_chat_model,讲清三种初始化方式的取舍、八类标准参数的工程含义(重点拆解 temperature 的分区指南和 timeout/max_retries 的生产必要性)、厂商特有参数的透传机制,以及 invoke/stream/batch 三种调用方式分别对应什么场景。最后给出一份生产级初始化模板。关键词:LangChain、模型初始化、init_chat_model、temperature、ChatDeepSeek、大模型应用开发、DeepSeek、AI 工程化
一、为什么模型初始化值得单独一篇文章
官方文档有句话:Models are the reasoning engine of agents——模型是 Agent 的推理引擎,你选的模型直接决定应用的可靠性上限。
但决定上限的不只是"选哪个模型",还有怎么初始化它。看两个真实场景:
- 场景 A:Demo 里
temperature用默认值,效果不错。上线后做数据抽取,同一份合同每次抽出不一样的字段——因为默认温度对抽取任务太高了; - 场景 B:没设
timeout,模型服务抖动一次,Web 请求挂起 5 分钟,上游线程池被拖垮。
这两个事故的根源都在初始化的那几行代码。初始化参数不是配置细节,是生产行为的定义。
二、统一入口:init_chat_model 的三种写法
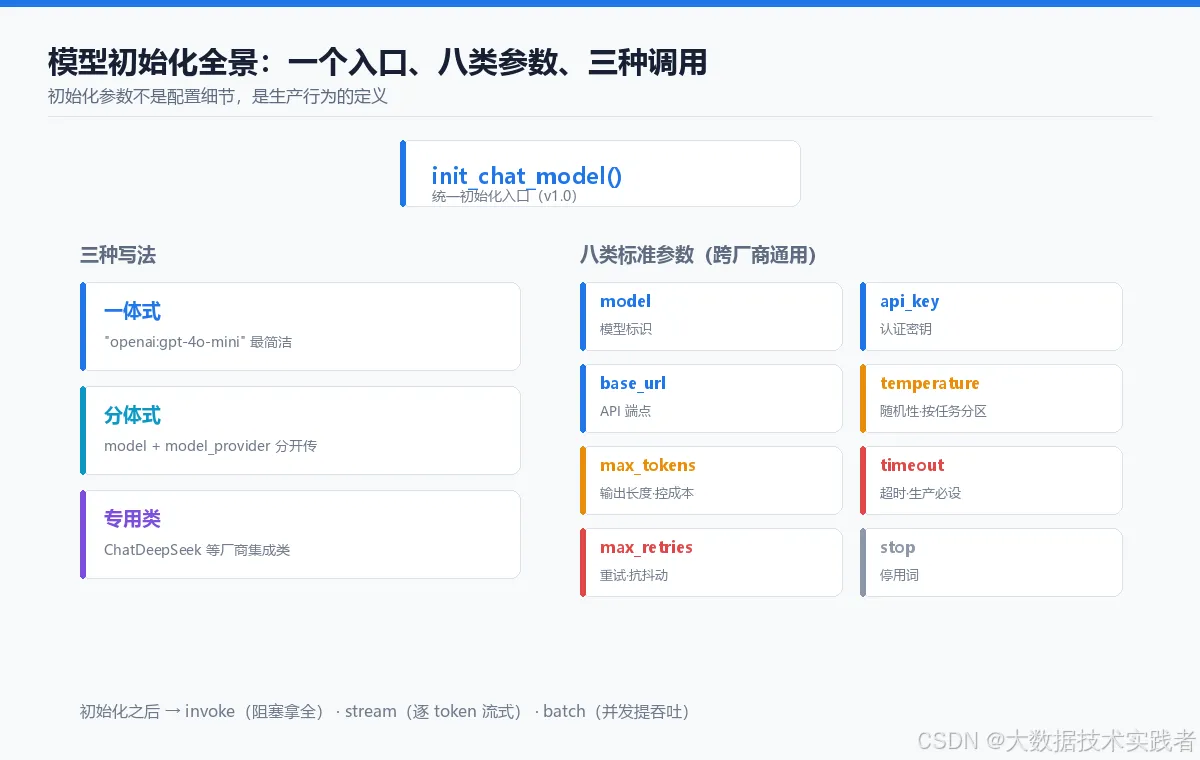
v1.0 之后,初始化聊天模型的标准入口是 init_chat_model,三种写法:
from langchain.chat_models import init_chat_model

# 写法一:分体式 —— 模型名与厂商分开指定
model = init_chat_model(
    model="gpt-4o-mini",
    model_provider="openai",
)

# 写法二:一体式 —— "厂商:模型名"(推荐)
model = init_chat_model("openai:gpt-4o-mini")

# 写法三:厂商专用类 —— 需要安装对应集成包
from langchain_deepseek import ChatDeepSeek
deepseek_llm = ChatDeepSeek(
    api_key=DEEPSEEK_API_KEY,
    api_base=DEEPSEEK_BASE_URL,
    model="deepseek-chat",
)
怎么选:
| 写法 | 适用情况 |
|---|---|
一体式 openai:gpt-4o-mini |
大多数情况,最简洁 |
分体式 + model_provider |
接 OpenAI 兼容协议的第三方服务(如通义千问) |
厂商专用类 ChatDeepSeek |
已明确锁定该厂商、需要其特有配置时 |
写法二有个细节值得注意:model_provider="openai" 不代表你在调 OpenAI 官方——它表示该服务使用 OpenAI 兼容协议。国内外大量平台都提供兼容模式,这就是"统一模型接口"特点的底层支撑。
另一个生产建议:避免使用浮动别名。像 claude-sonnet-4-5 这类别名可能被厂商静默升级指向新版本,你的应用行为会意外变化。生产环境固定到具体版本号。
三、八类标准参数:每个都是工程决策
init_chat_model 的标准参数对所有厂商通用。逐个看它们在工程上意味着什么:
| 参数 | 作用 | 不设置的后果 |
|---|---|---|
model |
模型标识符 | —— |
api_key |
认证密钥 | 自动读环境变量(推荐显式传入) |
base_url |
API 端点 | 用厂商默认地址 |
temperature |
输出随机性 | 默认值不一定适合你的任务 |
max_tokens |
最大输出长度 | 成本不可控 |
timeout |
请求超时(秒) | 请求无限挂起,拖垮上游 |
max_retries |
失败重试次数 | 网络抖动直接报错给用户 |
stop |
停用词列表 | 生成不受控截断 |
后四个是 Demo 最常漏、生产最致命的。重点展开两个:
temperature:不是"创意旋钮",是任务参数
温度范围 0~2,但正确的理解方式是按任务分区,而不是按喜好调节:
| 区间 | 行为 | 适用任务 |
|---|---|---|
| 0 ~ 0.3 | 输出确定、几乎每次一致 | 数据抽取、分类、代码生成、翻译 |
| 0.4 ~ 0.7 | 适度多样、自然但不跑题 | 日常对话、内容总结 |
| 0.8 ~ 1.2 | 明显多样化 | 创意写作、头脑风暴 |
| 1.3 ~ 2.0 | 非常随机、易出意外 | 探索性生成(少用) |
一个实用原则:给程序的输出用低温,给人的输出用中温。结构化提取场景,temperature=0 不是保守,是正确。
timeout + max_retries:生产环境的底线配置
model = init_chat_model(
    "deepseek:deepseek-chat",
    timeout=30,        # 30 秒无响应即失败
    max_retries=3,     # 自动重试 3 次,应对瞬时抖动
)
Web 服务里不设 timeout,等于给上下游埋了一颗雷——模型服务抖动时,你的线程池会堆积挂起请求。这两个参数是 Demo 与生产的分界线之一。
四、厂商特有参数:model_kwargs 透传
标准参数之外,每家厂商有自己的参数(top_p、frequency_penalty 等)。LangChain 用 model_kwargs 统一透传:
model = init_chat_model(
    "deepseek:deepseek-chat",
    temperature=0.0,
    model_kwargs={

        "top_p": 0.9,               # 核采样
        "frequency_penalty": 0.5,   # 频率惩罚,减少重复
    },
)
机制很直白:model_kwargs 里的键值对会被原封不动合并进发给厂商的请求体。可以理解为对 LangChain 说:"这几个参数你不认识,但请帮我原样转交给厂商。"
这样设计的好处:LangChain 不需要为每家厂商的每个参数都做适配,标准参数保证跨厂商一致,特有参数保留厂商能力——两边都不牺牲。
五、密钥管理:老问题,再强调一次
标准做法是 .env + 环境变量,初始化时显式传入:
import os
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model

load_dotenv(override=True)

model = init_chat_model(
    "openai:gpt-4o-mini",
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url=os.getenv("OPENAI_BASE_URL"),
)
三条加固建议:不同环境(开发/测试/生产)用不同的 .env 文件;有条件的团队用密钥管理服务;定期轮换 API Key。Key 一旦进过 Git 历史,唯一正确的处置是立即作废重发。
六、三种调用方式:初始化之后的第一个选择
模型初始化好之后,调用方式决定了应用的响应形态:
| 方式 | 行为 | 返回 | 适用场景 |
|---|---|---|---|
invoke() |
阻塞式,等完整响应 | 完整 AIMessage | Agent 内部循环、批量任务 |
stream() |
流式,逐 token 返回 | AIMessageChunk 迭代器 | 聊天 UI、长回复 |
batch() |
并发处理多个请求 | list[AIMessage] | 大量独立请求提吞吐 |
from langchain_core.messages import HumanMessage, SystemMessage

messages = [
    SystemMessage(content="你是一个专业的数据工程师"),
    HumanMessage(content="Spark 的宽依赖和窄依赖区别?"),
]

# invoke:一次拿全
resp = model.invoke(messages)
print(resp.content)

# stream:逐块输出,拼装完整消息
full = None
for chunk in model.stream(messages):
    full = chunk if full is None else full + chunk
    print(chunk.content, end="", flush=True)
print(full.response_metadata["token_usage"])  # 流式结束也能拿 token 用量
stream 的实战细节:chunk 需要累加拼接(full + chunk),结束后 full 就是完整 AIMessage,token 用量照常可读。另外若 Agent 链路要边流式边调工具,确保全链路支持 streaming,否则会静默回退同步模式。
七、生产级初始化模板
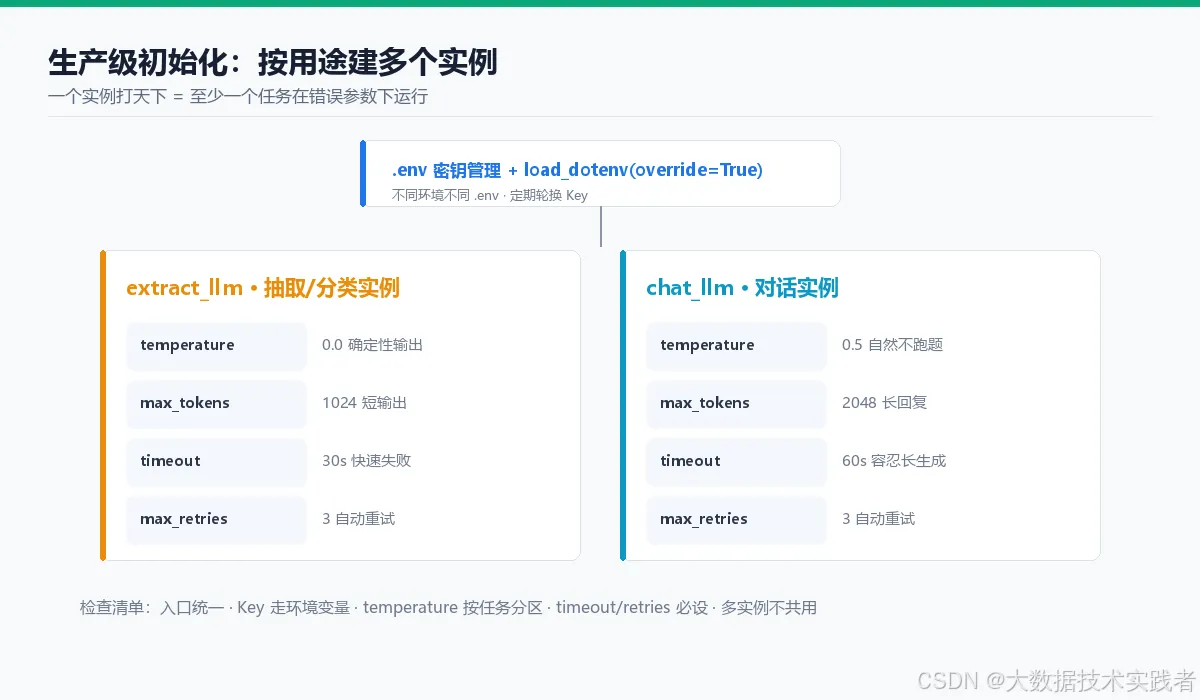
把前面的结论合并成一份可直接复制的模板:
"""my_llm.py —— 模型集中创建,全项目共用"""
import os
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model

load_dotenv(override=True)

# 抽取/分类用:低温 + 短输出 + 快超时
extract_llm = init_chat_model(
    "deepseek:deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_BASE_URL"),
    temperature=0.0,      # 确定性输出
    max_tokens=1024,      # 抽取结果不需要长篇
    timeout=30,
    max_retries=3,
)

# 对话用:中温 + 长输出
chat_llm = init_chat_model(
    "deepseek:deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_BASE_URL"),
    temperature=0.5,
    max_tokens=2048,
    timeout=60,
    max_retries=3,
)
注意模板里的关键设计:按用途建多个实例,而不是全项目共用一个。抽取任务和对话任务对温度、长度的要求不同,一个实例打天下意味着至少有一个任务在错误的参数下运行。
八、给 Java / 大数据工程师的对照
init_chat_model≈ 连接池工厂:传配置、拿实例,实例线程安全可复用;model_kwargs透传 ≈ JDBC 连接属性里的 unknown 参数:框架不解释,原样交给驱动;invoke/stream/batch≈ 同步调用 / 响应式流 / 批处理作业:选择逻辑完全同构;- temperature 分区 ≈ 隔离级别选择:不是"越高越好",是"按任务语义选"。
九、小结
模型初始化的检查清单,五条:
- 入口统一用
init_chat_model,厂商特有需求才上专用类; - Key 走环境变量,多环境多份 .env;
- temperature 按任务分区——给程序的输出用低温;
- timeout 和 max_retries 必设——这是生产底线;
- 按用途建多个模型实例,不共用。
第一行代码写对,后面的 Agent、链、工具才有可靠的推理引擎可用。
本文基于 LangChain v1.0 官方文档与社区实践整理,代码在 Python 3.13 + langchain 1.2.0 环境下验证通过。

