摘要:一位做云平台工程的工程师,转型学 Agentic AI 时撞上最大的墙——"读的时候懂,过两周讲不出"。他的解法是五个字:学 → 简化 → 可视化 → 写 → 复盘。本文就用这套方法,把他 100 天计划第一天的内容——AI、机器学习、深度学习、LLM 四级关系——一次讲透,并说清一个常被忽略的真相:生成式 AI 不是"最里层",而是横着切过这一层的。
一、一个云平台工程师的"翻车"
先讲个很多人的真实困境。
有位工程师,背景是云平台、分布式系统、DevOps。今年一头扎进 Agentic AI 和 AI Inference,结果发现——换赛道比想象中难。
难在哪?不是数学多吓人,而是他发现自己陷进了一个循环:
读论文、看文档、刷 YouTube、报课、收藏文章 → 当时看懂了 → 过两周要跟人讲 → 卡壳,讲不出来。
他自己调侃:可能那些 30 秒的短视频,也没帮上注意力啥忙。😅
这其实是今天所有人的处境。我们被要求成为"T 型人才"——在自己那一竖上够深,还得在横向上跟得上新技术。可资料越堆越多,20 个浏览器标签页永远开着,真要输出时,脑子却空了。
他试了一圈学习方法,最后留下一个对自己特别管用的:学 → 简化 → 可视化 → 写 → 复盘(Learn → Simplify → Visualize → Write → Revisit)。
把读到的东西,画成一张一页的涂鸦(他说用 ChatGPT 帮忙),再写成一篇约 10 分钟能读完的小文。他说,逼自己去"画"和"讲",会逼出那些你本来会跳过的真问题:
它是什么?为什么需要它?它怎么运作?我能不能不用术语把它讲清楚?
这四个问题,就是检验"真懂没懂"的试金石。
这篇文章,就借他这套方法,把他 100 天计划第一天的内容——AI、机器学习、深度学习、LLM 到底啥关系——一次讲透。顺便你会发现:这套"画一张图、去术语讲一遍"的方法,本身就是一篇值得收藏的职场心法。
二、先记住一句话:AI 是"目标",不是"方法"
这是理解后面所有东西的钥匙,也是 90% 的人混淆的源头。
1956 年达特茅斯会议(McCarthy、Minsky、Rochester、Shannon 四位大佬,提案其实写于 1955 年),给一个领域起了名,叫"人工智能"。但那次会议没有定义一项技术,它只立了一个"目标":
凡是让机器做出"如果人来做会被称为智能"的行为,都算 AI。
所以 AI 是一个目标(让机器变聪明),不是一种手段。而"机器学习"是一种手段(让机器从数据里学)。把"目标"和"手段"搅在一起,是所有概念混乱的开始。
记住这层关系,后面就好懂了。
三、四级嵌套:一把伞,套一层,再套一层
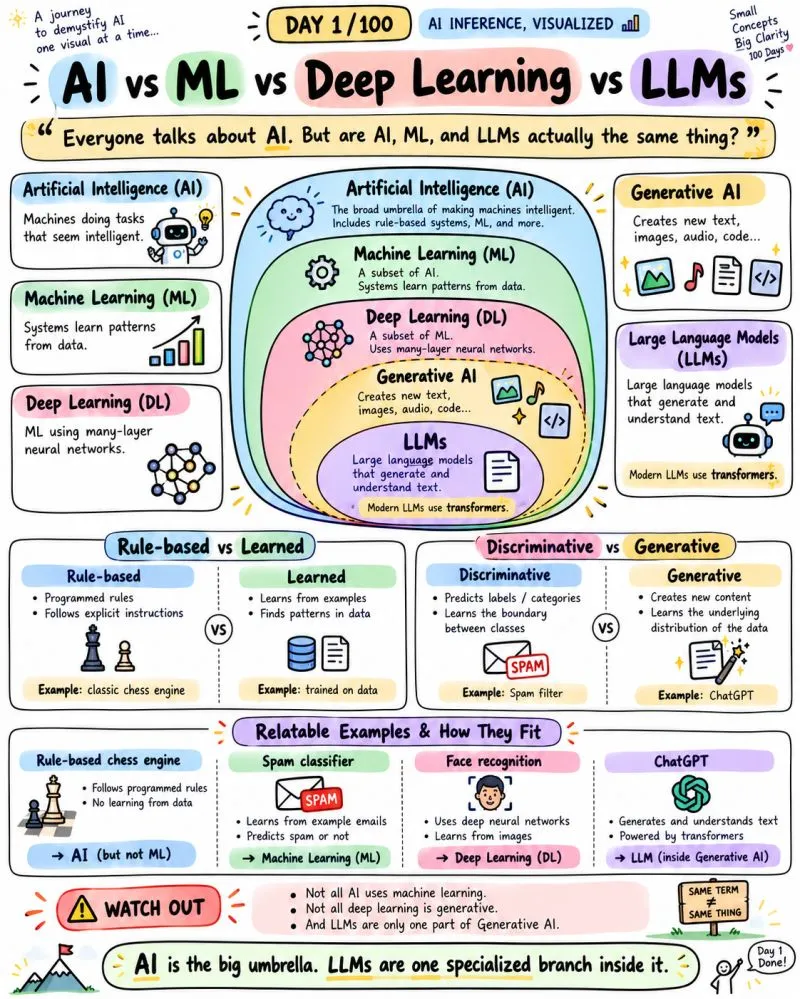
那张 Day 1 的速查卡,画的是一组"俄罗斯套娃"式的嵌套椭圆。从外到内:
第一层 · AI(人工智能)——最大的那把伞。 定义:让机器表现出智能行为的整个领域。注意,它包含规则系统。比如一个经典的西洋棋引擎,是人类把"如果对方这样走,你就那样应"的规则一条条写死的——它下棋像人一样聪明,但它没有从数据里学任何东西。按达特茅斯的定义,它是 AI,但它不是机器学习。
第二层 · ML(机器学习)——伞里的一层。 Arthur Samuel 在 1959 年造了这个词的本意:"让计算机在没有被显式编程的情况下,获得学习能力。"一句话翻转了传统编程:
传统编程:输入 + 规则 → 输出 机器学习:输入 + 输出 → 规则(规律是从数据里"长"出来的)
你给它 1 万封标了"垃圾/非垃圾"的邮件,它自己学会判新邮件。你给它历史房价和面积、卧室数,它自己学会预测价格。规则不是人写的,是它从例子里"找"的。
第三层 · DL(深度学习)——ML 里的一支。 它是机器学习的一个子集,用很多层的神经网络来学("深度"指输入输出之间的层数多)。它的厉害之处在于:能自动提取特征。以前做人脸识别,工程师得 manually 告诉机器"眼睛长这样、鼻子长那样";深度学习让网络自己从像素里一层层学——第一层学边缘,第二层学形状,第三层学眼睛鼻子,第四层学整张脸。
引爆点是 2012 年的 AlexNet(本号第 30 篇详细写过:把 ImageNet 错误率从 26% 砸到 15%),GPU 和大数据的成熟让它从学术玩具变成产业引擎。
第四层 · LLM(大语言模型)——DL 里的一个分支,但大到改写了游戏规则。 它建立在 2017 年的 Transformer 架构上(本号第 29 篇拆过它的 8 个零件),用海量文本做预训练,训练目标朴素到只有一句话:预测下一个 token。GPT-3(2020)把参数堆到 1750 亿,ChatGPT(2022)让它走进千家万户。
这里有个常被误解的点:LLM 不是"更聪明的聊天机器人",而是人类第一次造出了能对"语言本身"建模的系统。区别在于:前者背答案,后者在理解"问题长什么样、语言怎么连"。
四层套一起,就是那张图的骨架:
AI ⊃ 机器学习 ⊃ 深度学习 ⊃ LLM
(顺带呼应一下前面几篇:第 32 篇拆的"神经元/层",正是这里"深度学习"的最小零件;第 29 篇拆的 Transformer,正是 LLM 的骨架;第 31 篇讲的优化器,正是"深度学习从数据里学规律"时用的下山地方式。)
四、那个被忽略的真相:生成式 AI 是"横切"的,不是最里层
绝大多数人看到嵌套图,会顺手在 LLM 里面再写一层"生成式 AI"。错。
生成式 AI(Generative AI)不是按"深浅"分的,而是按"输出类型"分的——它是横着切过这一层的。
判别一个模型,有两个维度:
它处在哪一级(AI / ML / DL / LLM);
它产出什么(判别式 vs 生成式)。
判别式模型,给输入一个"标签":垃圾邮件过滤器判"是/否垃圾";图像分类器判"这是猫还是狗"。生成式模型,造出新的内容:ChatGPT 写一段诗,Stable Diffusion 画一张图,Suno 生成一首歌。
所以真相是:
不是所有 AI 都用机器学习(规则棋引擎是 AI,但没用 ML);
不是所有深度学习都是生成式(人脸识别是 DL,但它只"认",不"造");
LLM 只是生成式 AI 的其中一支——图像生成的 Diffusion 模型(DALL·E、Midjourney)、音乐生成的 Suno,都是生成式 AI,但它们不是 LLM。
那张图右下角特意标了 "WATCH OUT:SAME TERM ≠ SAME THING"(同一个词,不等于同一件事)。这话值得贴在每个开 AI 产品会的墙上。
五、用四张例卡,把四级钉死
图里给了四个例子,正好把前面四层各钉一个钉子:
|
例子
|
它是什么
|
落在哪一级
|
为什么
|
| --- | --- | --- | --- |
|
规则西洋棋引擎
|
人写死规则,机器照走
|
AI(但不是 ML)
|
聪明,但没从数据里学过
|
|
垃圾邮件分类器
|
从标注邮件里学规律
|
机器学习(ML)
|
规律是"长"出来的,不是写死的
|
|
人脸识别
|
用深层神经网络从图里学
|
深度学习(DL)
|
多层网络自动提取特征
|
|
ChatGPT
|
基于 Transformer 生成/理解文本
|
LLM(在生成式 AI 内)
|
造新内容,且是语言模型
|
记住这张表,下次有人把"AI"和"LLM"混着说,你就能一句话点破:ChatGPT 是 LLM,LLM 是深度学习,深度学习是机器学习,机器学习是 AI——但反过来,一个下棋的规则引擎是 AI,却跟你说的 LLM 半点关系没有。
六、升华:把"目标"和"方法"分清,是成年人的基本功
回到第二节那句话——AI 是目标,ML 是方法。这个区分,远不止于考试。
第一,它戳破了"上 AI"这个伪目标。 太多公司把"我们也要上 AI"当战略。但"上 AI"是个目标描述,不是方法。真正该问的是 qfloo 那句 vendor 该问的灵魂三问:
它从什么数据里学了什么规律?又输出了什么?
一个"AI 客服",如果背后是 500 条人写死的规则,那它是 AI,但不是机器学习——它不会越用越聪明。你能分清,才不会被"AI-powered"的标签忽悠。
第二,"能画成图、能去术语讲清",才是你真懂了,也是你能卖出去的前提。 那位工程师的 5 步法,本质是费曼学习法的变体。它最值钱的地方,不是帮你考试,而是帮你沟通:向上汇报、给客户讲方案、做技术布道,本质都是"把 LLM 讲成伞里一根骨"。你讲不清,不是你懂太少,是你没逼自己"可视化 + 去术语"过一遍。这步省了,知识就只是囤在 20 个标签页里的死物。
第三,任何组织都该内置这 5 步。 学新框架、进新市场、接手新业务,别先囤资料。先逼自己画一张图、用大白话给一个外行讲一遍——"它是什么、为什么、怎么用"。讲不顺,说明你还没真懂,回去再学,比囤资料高效十倍。
七、给非算法背景、却绕不开 AI 的你三条建议
如果你不是算法工程师,只是个被时代推着要懂 AI 的人,三条很落地的:
第一,听到"AI"先降级问一句。 它在四级里的哪一级?是判别式还是生成式?这一句,能挡掉八成忽悠。
第二,用"嵌套"框架记,别背定义。 AI ⊃ ML ⊃ DL ⊃ LLM,生成式 AI 横切。一张伞图,胜过一万字。真忘了,画图就好。
第三,用"去术语讲一遍"自检。 挑任意一个 AI 概念,试着不讲"神经网络""Transformer""embedding"这些词,给完全的外行讲清楚"它是什么、为什么需要、怎么用"。讲得顺,才是真懂;讲不顺,回去补课。
八、结语
那位工程师给自己的系列起了个 slogan:Small Concepts, Big Clarity(小概念,大清晰)。
这话值得所有在 AI 浪潮里焦虑的人记一下。
真正拉开人和人的,从来不是谁收藏的资料多、谁追的模型新,而是谁能把一个个小概念,讲出大清晰。AI 这班车,别急着上车抢座,先把 AI、机器学习、深度学习、LLM 这四层,在脑子里站踏实。
站踏实了,你会发现:那些曾经让你卡壳的词,不过是一把伞、四层套娃、和一道横切的线。
互动话题:你第一次被"AI/机器学习/深度学习/LLM"这几个词搞晕,是在什么场景?后来是哪个比喻、哪张图让你突然"通了"?欢迎在评论区分享你的"开窍时刻"。
免责说明:本文核心框架整理自「AI Inference, Visualized」系列 Day 1/100 的公开速查卡(手绘嵌套椭圆:AI⊃ML⊃DL⊃LLM,Generative AI 以虚线横切,图内仅标注系列名、未署个人作者,故不臆造出处),及配套英文说明(作者学习历程与 Learn→Simplify→Visualize→Write→Revisit 五步法)。关键史实与层级均经多源交叉核实:AI 之名源于 1956 达特茅斯会议(McCarthy, Minsky, Rochester, Shannon;提案写于 1955),且 AI 是"目标"而非"方法"之分辨析参考 qfloo 等来源;ML 一词由 Arthur Samuel 于 1959 年提出(跳棋程序从数据中学);DL 以多层神经网络为特征,2012 AlexNet 引爆;LLM 基于 2017 Transformer 架构、以"预测下一个 token"为目标、GPT-3(2020)达 1750 亿参数;Generative AI 按"输出类型"横切分类(LLM、Diffusion 图像模型、Suno 音乐模型均属生成式但前两者非 LLM),Discriminative(如垃圾邮件过滤)与 Generative(如 ChatGPT)之别为共识;Foundation Model 术语由 Stanford HAI/CRFM 于 2021 年提出。各资料对层级边界的"严格包含"表述略有差异(如部分将 GenAI 置于 DL 子集、部分视其横切),本文取"嵌套 + 横切"的主流可视化框架。具体技术归属以你所用模型的官方文档为准。