
从"跑通了"到"拿到产物"
评估一个模型平台的能力面,我一开始的做法是把文档从头读一遍,再照着教程跑一次调用。教程跑通了,命令行刷出一段回答,然后就没有然后了,文件夹里什么都没留下。
问题出在评估方式上:只验证了"能调通",没验证"能产出什么"。
我后来换成一个更直接的口径:四个模态入口各跑一条命令,每条命令必须落一个能拿走的文件。 跑完看文件夹,不看结论。
阿里云百炼的 CLI 正好覆盖这四个入口,我把这一轮完整走了一遍,四个产物都拿到了,中间撞上一次超时,也如实写在下面。
四个入口与四个产物
| 模态入口 | 命令 | 产物 | 默认模型 | 实测耗时 |
|---|---|---|---|---|
| 文本生成 | bl text chat |
一段文字回答 | qwen3.8-max |
4.6 秒 |
| 图像生成 | bl image generate |
out/balloon.png,1024×1024 PNG |
qwen-image-3.0 |
68.2 秒 |
| 语音合成 | bl speech synthesize |
out/hello.mp3 |
cosyvoice-v3-flash |
1.8 秒 |
| 视觉理解 | bl vision describe |
一段图片描述 | qwen3-vl-plus |
3.6 秒 |
(蓝黄手绘示意图,非实测截图)
第四个入口读的是第二个入口生成的那张图。这一层依赖关系是刻意保留的:能看出四个入口不是各自独立,产物可以在链路里传递。
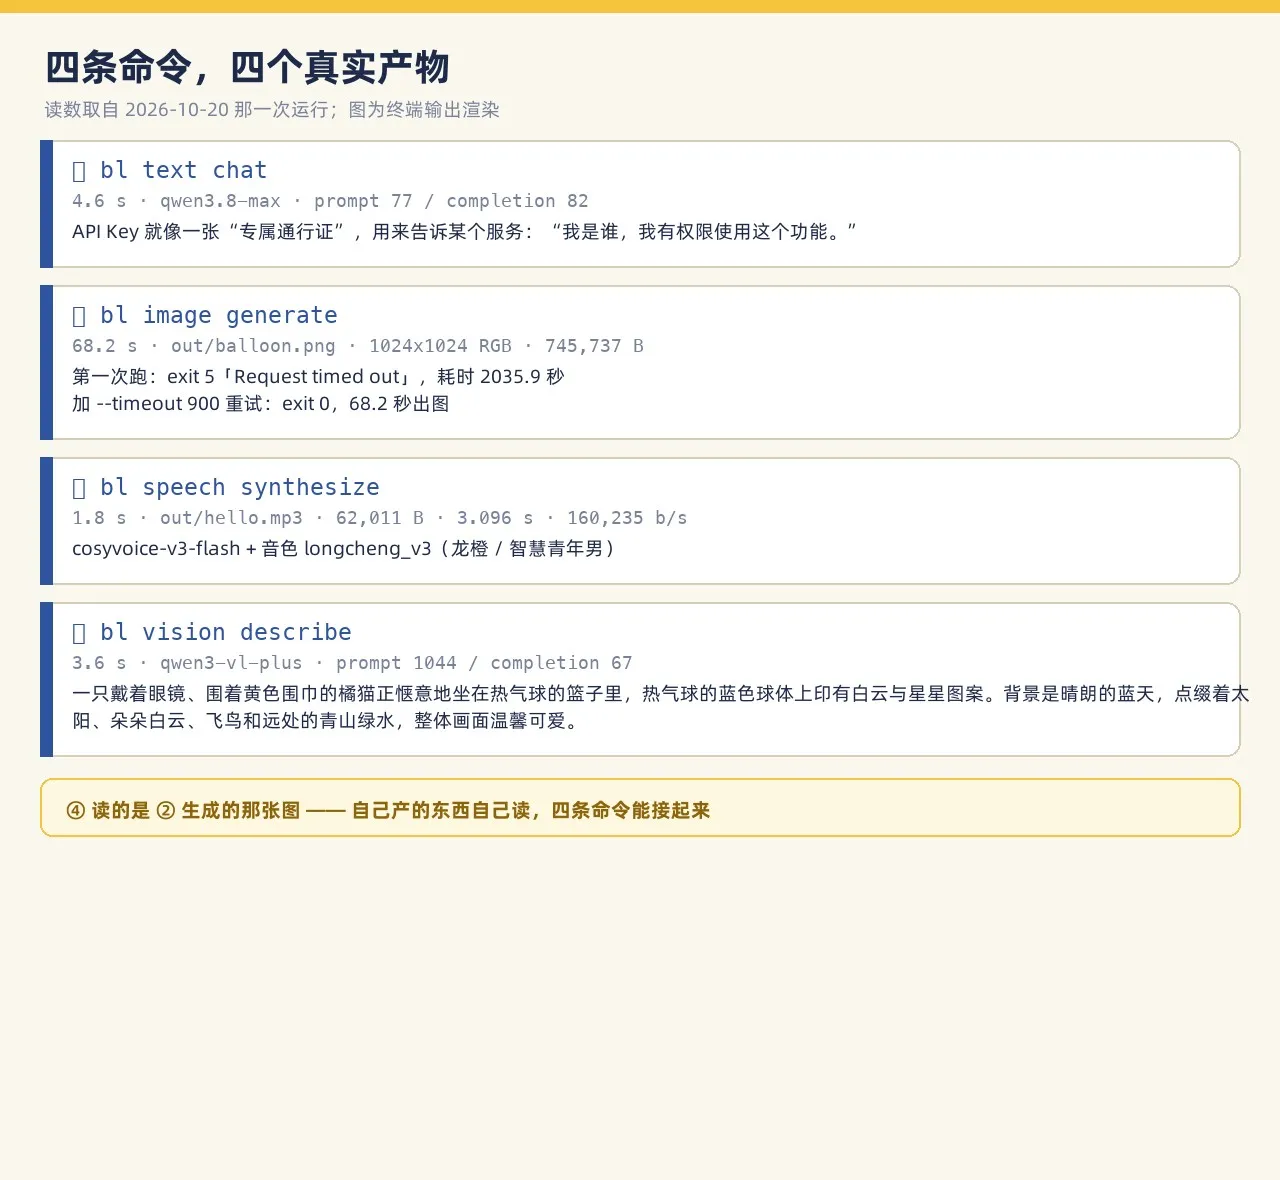
下面全部读数都是我 10 月 20 号在自己电脑上跑出来的,环境是 bl 2.1.0、macOS arm64,一轮共发起 8 次调用,6 次成功、2 次失败。
环境准备
安装 CLI:
npm install -g bailian-cli
用 API Key 登录:
bl auth login --api-key sk-你的key
Key 在控制台密钥管理页签发,命令说明与安装方式见CLI 安装页。
这一轮四条命令全部走 API Key 域,没有创建任何云资源,也不需要控制台操作。
入口一:文本生成
bl text chat --message "用一句话解释什么是 API Key,说给完全没接触过编程的人听。"
4.6 秒返回:
API Key 就像一张"专属通行证",用来告诉某个服务:"我是谁,我有权限使用这个功能。"
提示里要求"说给完全没接触过编程的人听",返回就没有使用任何术语。输出口吻由 --message 里的自然语言控制,不需要额外的参数配置,这一点对面向非技术读者的场景比较有用。
加 --output json 可以拿到结构化返回,除答案外还带消耗读数,我这次是输入 77、输出 82。
入口二:图像生成,以及一次超时
第一次执行的命令是:
bl image generate --prompt "一只戴着圆框眼镜的橘色小猫,坐在蓝色的复古热气球上,手里捧着一杯茶,扁平插画风格" --size 1024*1024 --out-dir out --out-prefix balloon
耗时 2035.9 秒后失败,退出码 5,报错原文:
Error:       Request timed out.
Hint:        Try increasing --timeout (e.g. --timeout 60).
Caused by:   This operation was aborted
Exit code:   5
(蓝黄手绘示意图,非实测截图)
按提示补充超时参数后重试:
bl image generate --prompt "一只戴眼镜的橘猫坐在蓝色热气球上,扁平插画风格" --size "1024*1024" --timeout 900 --out-dir out --out-prefix balloon
68.2 秒成功,产物 out/balloon.png,1024×1024、RGB、745,737 字节。
需要如实说明的是:重试时同时调整了三处,补 --timeout 900、--size 加引号、提示词缩短。三处是一起改的,无法判定单一变量的作用,能确认的只有补充超时后这次调用成功了。
由此得到两条使用约定:图像生成属于长耗时调用,应显式指定 --timeout,不依赖默认值;--size 的像素写法含 *,在 shell 中必须加引号,否则会被当通配符展开,也可改用 --size 1:1、--size 16:9 这类比例写法。
图像生成的产物默认带"AI 生成"角标,--watermark 默认值为 true,需要关闭时在生图命令中加 --watermark false。
入口三:语音合成
bl speech synthesize --text "你好,这是我第一次用命令行让机器说话。" --voice longcheng_v3 --format mp3 --out out/hello.mp3
1.8 秒完成,产物 out/hello.mp3,62,011 字节,时长 3.096 秒,码率 160235。
平台预置的系统音色可以直接盘点,这条命令不校验 Key:
bl speech synthesize --list-voices
cosyvoice-v3-flash 返回 64 个系统音色,每个都带中文人设描述与语言标注,例如 longcheng_v3 龙橙「智慧青年男」、longantai_v3 龙安台「嗲甜台湾女」、longtian_v3 龙天「磁性理智男」。按描述筛选即可,不必逐个试听。
存盘参数需要注意差异:语音合成用 --out 接完整文件路径,图像生成用 --out-dir 加 --out-prefix,两者不通用。
入口四:视觉理解
bl vision describe --image out/balloon.png --prompt "这张图里有什么?用两句话描述。"
3.6 秒返回,消耗读数为输入 1044、输出 67。返回原文:
一只戴着眼镜、围着黄色围巾的橘猫正惬意地坐在热气球的篮子里,热气球的蓝色球体上印有白云与星星图案。背景是晴朗的蓝天,点缀着太阳、朵朵白云、飞鸟和远处的青山绿水,整体画面温馨可爱。
这里有一个对预期管理很重要的观察:它读出了提示词里没有的内容。
入口二的提示词只有"一只戴眼镜的橘猫坐在蓝色热气球上,扁平插画风格"。眼镜、橘猫、蓝色热气球来自提示词;黄色围巾、球体上的白云与星星图案、太阳、飞鸟、远处的青山绿水均由模型自行补充。反向印证:第一次那版提示词写了"手里捧着一杯茶",重试时删掉,返回描述里也没有茶杯。
也就是说,图像生成不是精确执行指令,而是在描述基础上再创作。写验收标准时这一条要计入:提示词写到的会出现,删掉的不会出现,但模型会自行补细节。
视觉理解入口还有一个可复用的用法,就是核查角标:
bl vision describe --image out/balloon.png --prompt "图片右下角或边角有没有任何文字、logo 或水印角标?只回答有或没有,有的话把文字逐字念出来。"
返回逐字为"有,AI 生成"。这比人工放大图片逐处找要省事。
链路依赖方面补一条:入口二失败时图不存在,入口四的 --image 传空会直接返回退出码 2,报错 {"error":{"code":2,"message":"Provide --image or --video."}}。上游不出产物,下游就跑不了。
四条命令速查
bl text chat --message "你要问的话"
bl image generate --prompt "画面描述" --size "1024*1024" --timeout 900 --out-dir out --out-prefix 名字
bl speech synthesize --text "要念的话" --voice longcheng_v3 --format mp3 --out out/名字.mp3
bl vision describe --image out/名字.png --prompt "你想问这张图什么"
四个入口的共同形态是:输入是一句话或一个文件,输出是一个能拿走的产物。四条命令都支持 --model 切换模型,这一轮全部使用默认值,未调整任何采样参数。
(蓝黄手绘示意图,非实测截图)
如果你的目的是快速摸清平台能给到什么,这条路径的成本很低:四条命令、四个模态入口、四个本地产物,一轮跑完云资源创建为 0。
最后交代一句:四条命令的读数都是我自己跑出来的真实结果,但提示词里那只橘猫和热气球是我随口编的画面,你照着跑会拿到一张不一样的图(生图每次结果都不同)。
想先在网页端感受一下,可以去阿里云百炼控制台。

